¿Quién tiene el poder de convertir los números en evidencia?
Convertir los números en evidencia es una forma de trabajo, y en el Sur Global, ese trabajo está distribuido de manera desigual.
Convertir los números en evidencia es una forma de trabajo, y en el Sur Global, ese trabajo está distribuido de manera desigual.
1. ¿Quién puede cuestionar las cifras?
A finales de 2018, la Oficina Nacional de Encuestas por Muestreo de la India había completado su Encuesta Periódica de la Fuerza de Trabajo (PLFS, por su sigla en inglés) correspondiente al período 2017-2018, un instrumento del propio gobierno para medir el empleo. El informe no se publicó. Semanas más tarde, una versión filtrada a la prensa reveló que el desempleo se situaba en el 6,1%, su nivel más alto en cuarenta y cinco años. Dos miembros de la Comisión Nacional de Estadística, que había aprobado el informe, renunciaron por la retención del informe.1 La controversia inmediata no se centró en un error matemático en la cifra, sino en si se permitiría al público verla.
La controversia en torno a la PLFS puso de manifiesto el gran peso político que puede tener una cifra. Los números son fundamentales para el debate público: los índices de deuda, las tasas de crecimiento, las tasas de desempleo, los umbrales de pobreza, los índices de precios y los valores de exportación ayudan a decidir si una economía se está “recuperando”, si lxs trabajadorxs están “empleadxs” y si el gasto público se considera “sostenible”. Pero ocultar una cifra es solo una forma de controlar su significado político. Los números también pueden ocultar la realidad a través de las definiciones, clasificaciones, comparaciones y formatos que las hacen parecer neutrales.
Las tasas de desempleo son un buen ejemplo de lo que los números pueden revelar y ocultar al mismo tiempo. Una tasa de desempleo nunca es un simple recuento de personas sin trabajo. Es una relación entre quienes se clasifican como desempleados y quienes se cuentan como parte de la fuerza de trabajo activa. Esa relación depende de los límites de definición: quién califica como empleado, quién busca trabajo activamente, quién ha dejado de buscarlo, quién está disponible de inmediato para trabajar y qué formas de trabajo informal o no remunerado quedan fuera de la métrica.
La tasa puede bajar porque el empleo se ha expandido genuinamente, pero también puede bajar porque los solicitantes de empleo desanimados dejaron de buscar, porque el trabajo informal precario se cuenta como empleo, o porque el subempleo se ha clasificado en una categoría estadística diferente. Por sí solos, los números no pueden decirnos qué proceso social subyacente registran.
Estos ejemplos apuntan a un problema profundamente político. La precisión es solo una parte del asunto. La pregunta más profunda es quién tiene el poder de cuestionar estos números. ¿Quién puede indagar en sus definiciones? ¿Quién cuenta con los medios para auditar el denominador, distinguir un recuento de una tasa o un índice, o diferenciar un valor nominal de uno real? ¿Quién puede rastrear un indicador pulido hasta las realidades del trabajo y la clase, el género y la región, la deuda y el mercado mundial?
Estas preguntas tienen implicaciones en el mundo real que afectan la vida de miles de millones de personas. La supervisión del Fondo Monetario Internacional (FMI) y sus normas de difusión de datos —formalmente voluntarias— determinan los formatos mediante los cuales los Estados reportan los datos económicos; los préstamos del Banco Mundial han financiado y moldeado el desarrollo de los sistemas estadísticos nacionales; el Sistema de Cuentas Nacionales de las Naciones Unidas define los estándares internacionales para medir el producto interno bruto (PIB); y las calificaciones crediticias soberanas de Moody’s, S&P y Fitch influyen en los costos de endeudamiento a través de metodologías cuyos juicios finales no están totalmente abiertos al escrutinio público.2
Esta concentración de autoridad estadística pone a los investigadores del Sur Global en una encrucijada. Pueden preguntarse cómo la deuda soberana limita el gasto público, o cómo los precios de las materias primas vinculan la producción nacional a un mercado mundial desigual. Pero los datos con los que deben responder a esas preguntas suelen estar organizados en otros lugares, a veces precisamente por las mismas instituciones y normas que buscan cuestionar. El patrón no es nuevo. El análisis de Raúl Prebisch sobre los términos de intercambio entre el centro y la periferia3 y el de Walter Rodney sobre las economías coloniales organizadas para la extracción4 señalan un problema más antiguo: la dominación económica no solo da forma al movimiento de las materias primas, el trabajo y el capital, sino también a los términos mediante los cuales esos movimientos se contabilizan, comparan y comprenden. La pregunta hoy es cómo ese viejo problema reaparece en los conjuntos de datos, los indicadores, los metadatos y las normas institucionales. El Sur Global tampoco enfrenta este problema desde un único punto de vista. Un tecnócrata de un Ministerio de Finanzas, un grupo de cabildeo empresarial y el departamento de investigación de un sindicato no abordan las cifras del FMI con los mismos intereses. La pregunta, por lo tanto, no es solo dónde se encuentra la autoridad estadística, sino a qué intereses sirven sus categorías y medidas.
Para quienes investigan, los movimientos y las instituciones públicas que durante mucho tiempo han tenido que depender de métricas preestablecidas por las instituciones dominantes, el desafío no es simplemente la falta de datos, sino la desigualdad de poder para convertir los números en bruto en evidencia. La aparición de herramientas de IA cambia este panorama al reducir el costo de ese trabajo. Pero el significado político de la IA solo puede entenderse al observar primero el trabajo que precede al análisis: las decisiones, la verificación y las transformaciones que determinan qué puede mostrar una cifra.
2. Los números no son evidencia hasta que alguien los convierte en ello
La investigación cuantitativa suele concebirse como un proceso lineal: los datos existen, luego se depuran, se analizan, se visualizan y se interpretan. Esta secuencia parece intuitiva, pero comienza demasiado tarde. Gran parte de la investigación empírica ocurre antes de que comience el análisis formal, en el laborioso esfuerzo por determinar si una cifra determinada puede responder a la pregunta que se plantea.
El valor de una celda en una tabla aún no es evidencia. Solo se convierte en evidencia cuando se vincula a una pregunta de investigación específica, una definición rigurosa, una unidad de observación, una medida estandarizada y una base para la comparación. Un número puede ser válido dentro de su propio sistema estadístico y, aun así, no responder a la pregunta política que se plantea. Reconocer cuándo un total nacional oculta profundas disparidades distributivas, o cuándo una tendencia en términos monetarios oculta un cambio en lo que ese dinero compra, forma parte del trabajo conceptual de la investigación cuantitativa. También lo es detectar cuándo un recuento formal de trabajadorxs deja fuera el trabajo socialmente necesario.
Este trabajo de conexión —el que tiende un puente entre las cifras brutas y las afirmaciones sustantivas— es el trabajo de medición. Es el trabajo de transformar datos administrativos o estadísticos sin procesar en evidencia. Sus insumos pueden ser una tabla en PDF, una breve nota de metadatos o una serie temporal aislada. Sus resultados son variables explícitas, transformaciones verificadas, fuentes documentadas y comparaciones fundamentadas.
El término es específico de los datos, pero el tipo de traducción al que se refiere tiene una historia más larga. Bowker y Star demostraron que los sistemas de clasificación se construyen a través del trabajo político e institucional.5 Marx mostró cómo el capitalismo reduce diferentes tipos de trabajo concreto a valor abstracto e intercambiable.6 El trabajo de medición denomina una traducción relacionada: el proceso mediante el cual las cifras brutas se convierten en evidencia que puede circular como verdad pública.
Darle nombre a este trabajo es importante porque replantea la pregunta principal, pasando de “¿tenemos las cifras?” a “¿qué se ha hecho para que estas cifras puedan utilizarse como evidencia?”.
El PIB, por ejemplo, puede expresarse como un nivel absoluto, una tasa de crecimiento interanual, un valor per cápita, una serie nominal o un índice real deflacionado. Un umbral de pobreza puede hacer visible la privación material, pero el lugar donde se traza también determina cuántas personas se cuentan como pobres en primer lugar. Un índice de precios al consumidor mide la inflación, pero sus implicaciones políticas varían drásticamente dependiendo de si el enfoque se centra en la seguridad alimentaria, los costos del combustible, los salarios reales o la subsistencia de los hogares. No se trata de ajustes técnicos menores. Estos determinan qué aspectos de la vida social puede reflejar una cifra y cuáles deja de lado.
Tomemos como ejemplo la Hoja Rosa del Banco Mundial sobre los precios de las materias primas.7 El libro de trabajo anual que se descarga es un archivo complejo que contiene múltiples hojas: precios nominales, precios reales, índices de precios y estructuras de ponderación. Lxs investigadorxs que estudien la dependencia agrícola tienen que elegir qué versión del precio utilizar. ¿Deben seguir el precio tal como aparecía en ese momento, o ajustarlo para mostrar su poder adquisitivo a lo largo de los años? ¿Qué materia prima y qué unidad de medida se ajustan a la pregunta? Esta selección es un trabajo de medición. Puede hacer que las mismas décadas parezcan una recuperación —o un largo declive en lo que esos precios realmente podían comprar—.
De manera similar, una serie básica de crecimiento del PIB puede respaldar argumentos muy diferentes, incluso contradictorios, dependiendo de cómo se maneje. Mientras que una tasa anual sin ajustar resalta la volatilidad a corto plazo, un promedio móvil de tres años suaviza las fluctuaciones para revelar tendencias cíclicas, y un promedio de cinco años facilita la visualización de tendencias a más largo plazo (Figura 1). Los datos subyacentes siguen siendo los mismos, pero la decisión de agregarlos o suavizarlos constituye una intervención conceptual. Sin la capacidad técnica para construir estas medidas alternativas, un equipo de investigación se ve obligado a adoptar la versión utilizada en los comunicados de prensa oficiales para enmarcar el desempeño nacional.
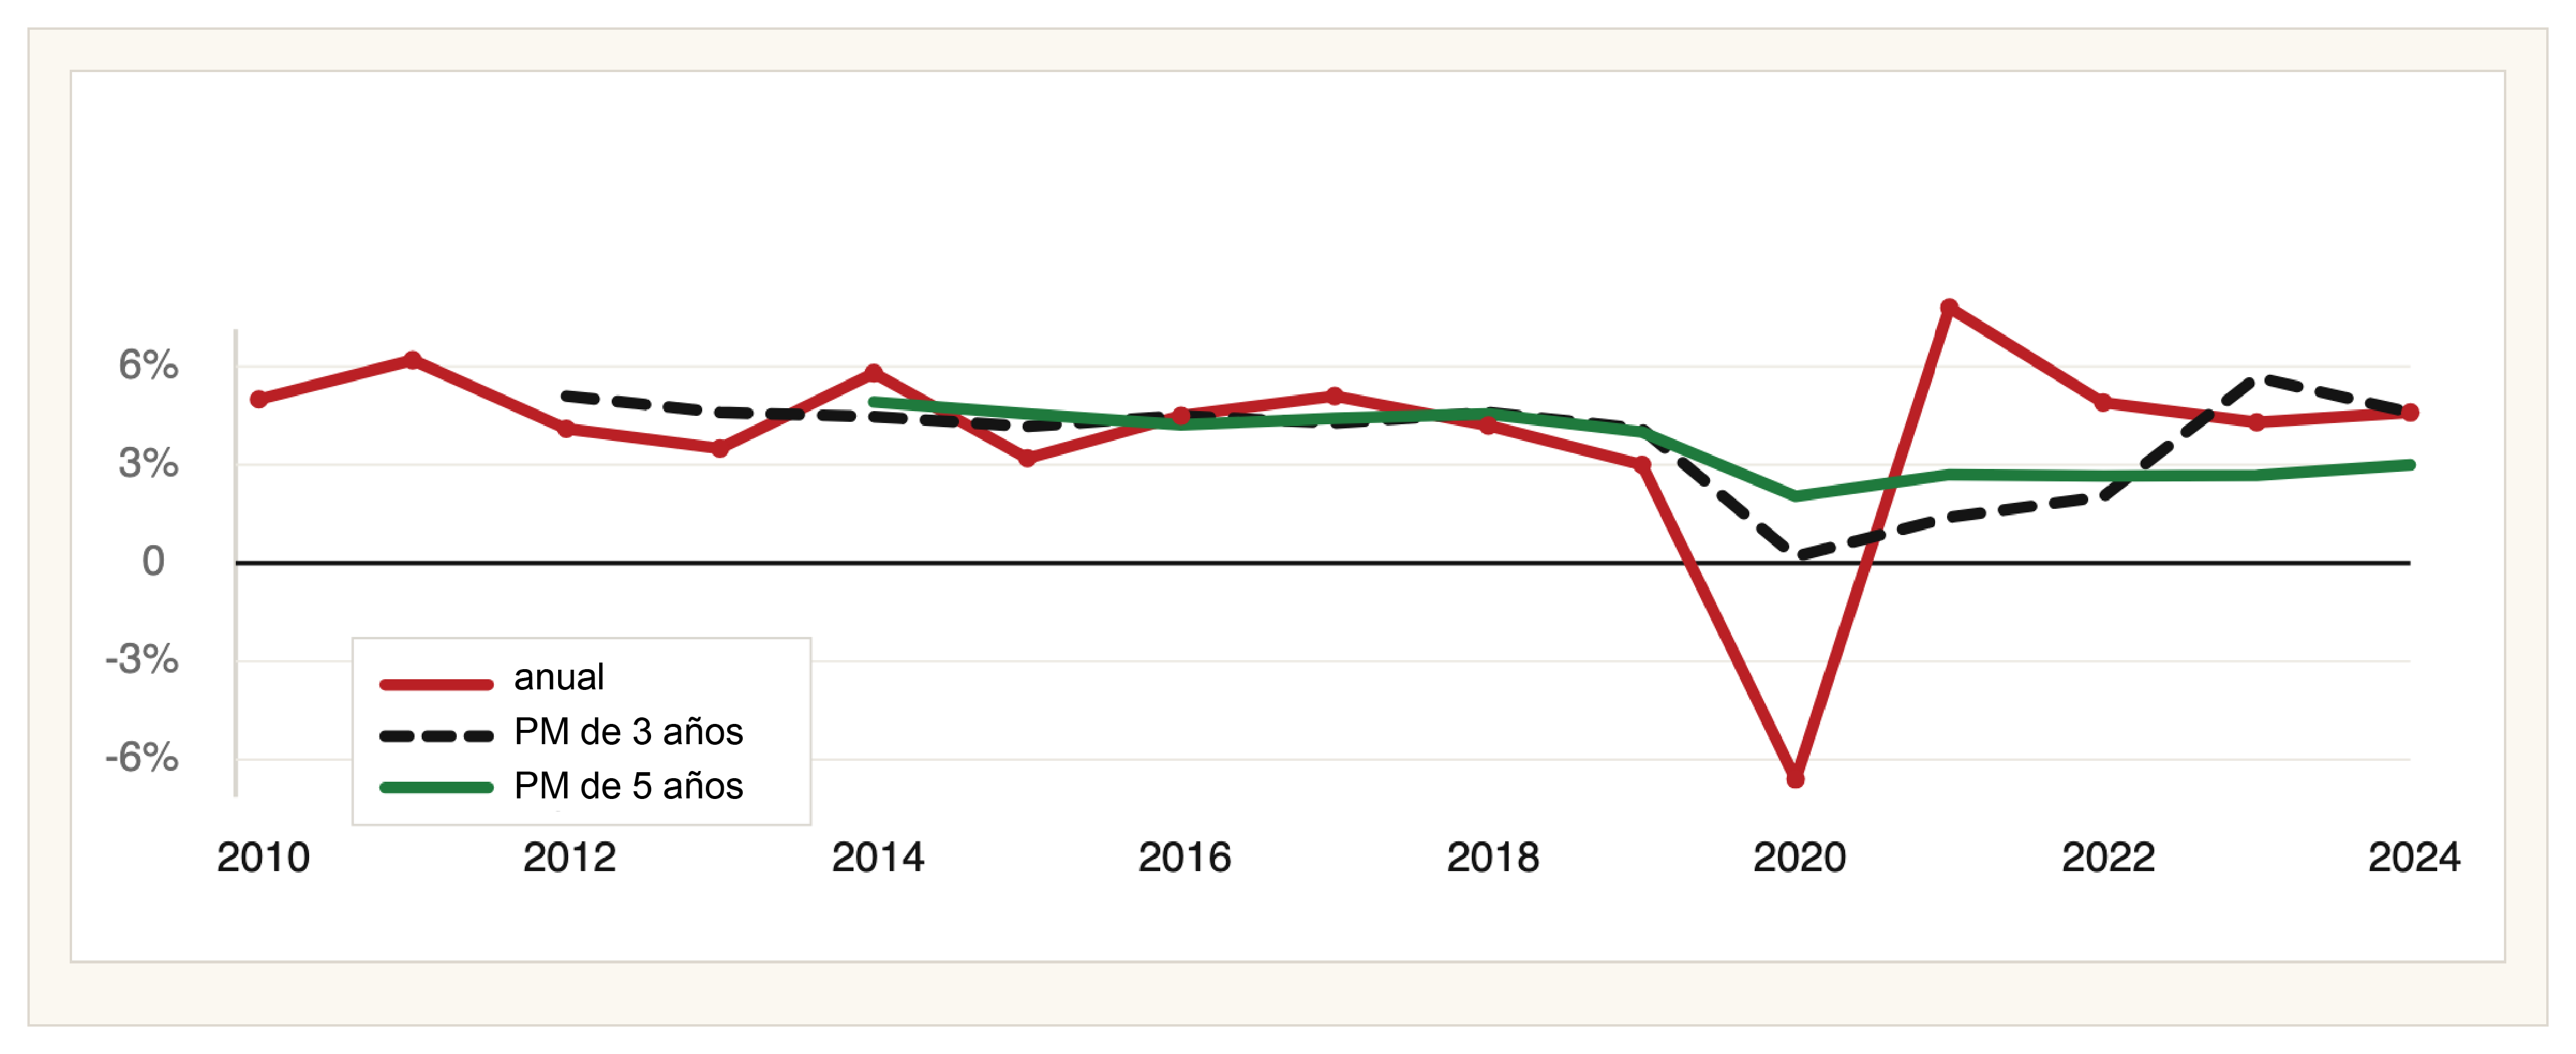
Figura 1. Crecimiento del PIB real, expresado como tasa anual y promedios móviles de tres y cinco años (serie ilustrativa construida, porcentaje por año; no corresponde a ningún país específico).
Nada de esto hace que las métricas estadísticas carezcan de sentido. Significa que su autoridad se basa en la cadena que conecta un valor bruto con una afirmación pública.
Sin embargo, esta cadena es profundamente desigual. Las instituciones bien financiadas pueden distribuir el trabajo preanalítico entre equipos de datos especializados, flujos de trabajo de software avanzados y sistemas de documentación robustos. Lxs investigadorxs, los movimientos sociales y las agencias públicas en el Sur Global a menudo tienen que encargarse ellos mismos de toda la secuencia: localizar archivos sin procesar, auditar fuentes, desmontar tablas, escribir código, validar totales y defender sus hallazgos en debates públicos.
Esta división del trabajo determina, en primer lugar, qué preguntas se pueden plantear. Si quien investiga no puede verificar el constructo detrás de un número, es posible que una investigación nunca llegue a la etapa del análisis formal. Si una hoja de cálculo no puede transformarse en evidencia estructurada, los patrones que contiene pueden quedar excluidos del debate público. Cuando solo un puñado de organizaciones bien financiadas pueden realizar esta traducción a gran escala, conservan el poder de definir la realidad económica y social a través de los números.
El trabajo de medición es una piedra angular de la capacidad de investigación cuantitativa. No es una tarea preliminar, sino una de las condiciones que hacen posible la investigación empírica.
Sin embargo, este trabajo fundamental suele quedar en el olvido. Los indicadores pulidos de las bases de datos globales aparecen como hechos consumados, mientras que las decisiones que los sustentan quedan ocultas. Este olvido genera dos obstáculos: desalienta a quienes investigan de cuestionar las estadísticas oficiales y los deja sin práctica en el manejo de datos administrativos sin procesar. A menudo, las cifras existen, pero se presentan en formatos que son difíciles de cuestionar. Una tabla puede ser fácil de leer y, aun así, difícil de verificar, comparar o reutilizar.
3. Una tabla legible no es aún un conjunto de datos
La brecha entre una tabla de presentación y un conjunto de datos listo para el análisis se hace evidente en una hoja de cálculo típica sobre indicadores de la fuerza de trabajo (Figura 2). La hoja se ve ordenada: los dos sexos aparecen en la parte superior, los sectores a la izquierda y tres bloques relacionados —participación en la fuerza de trabajo, empleo y desempleo— están apilados uno debajo del otro. Alguien investigando puede leerla y un programa de hoja de cálculo puede mostrarla. Pero herramientas como R, Python o SQL no pueden tratarla de manera confiable como datos, ya que el significado de cada valor viene determinado por la posición, la fórmula y el orden de los bloques, en lugar de por variables explícitas.
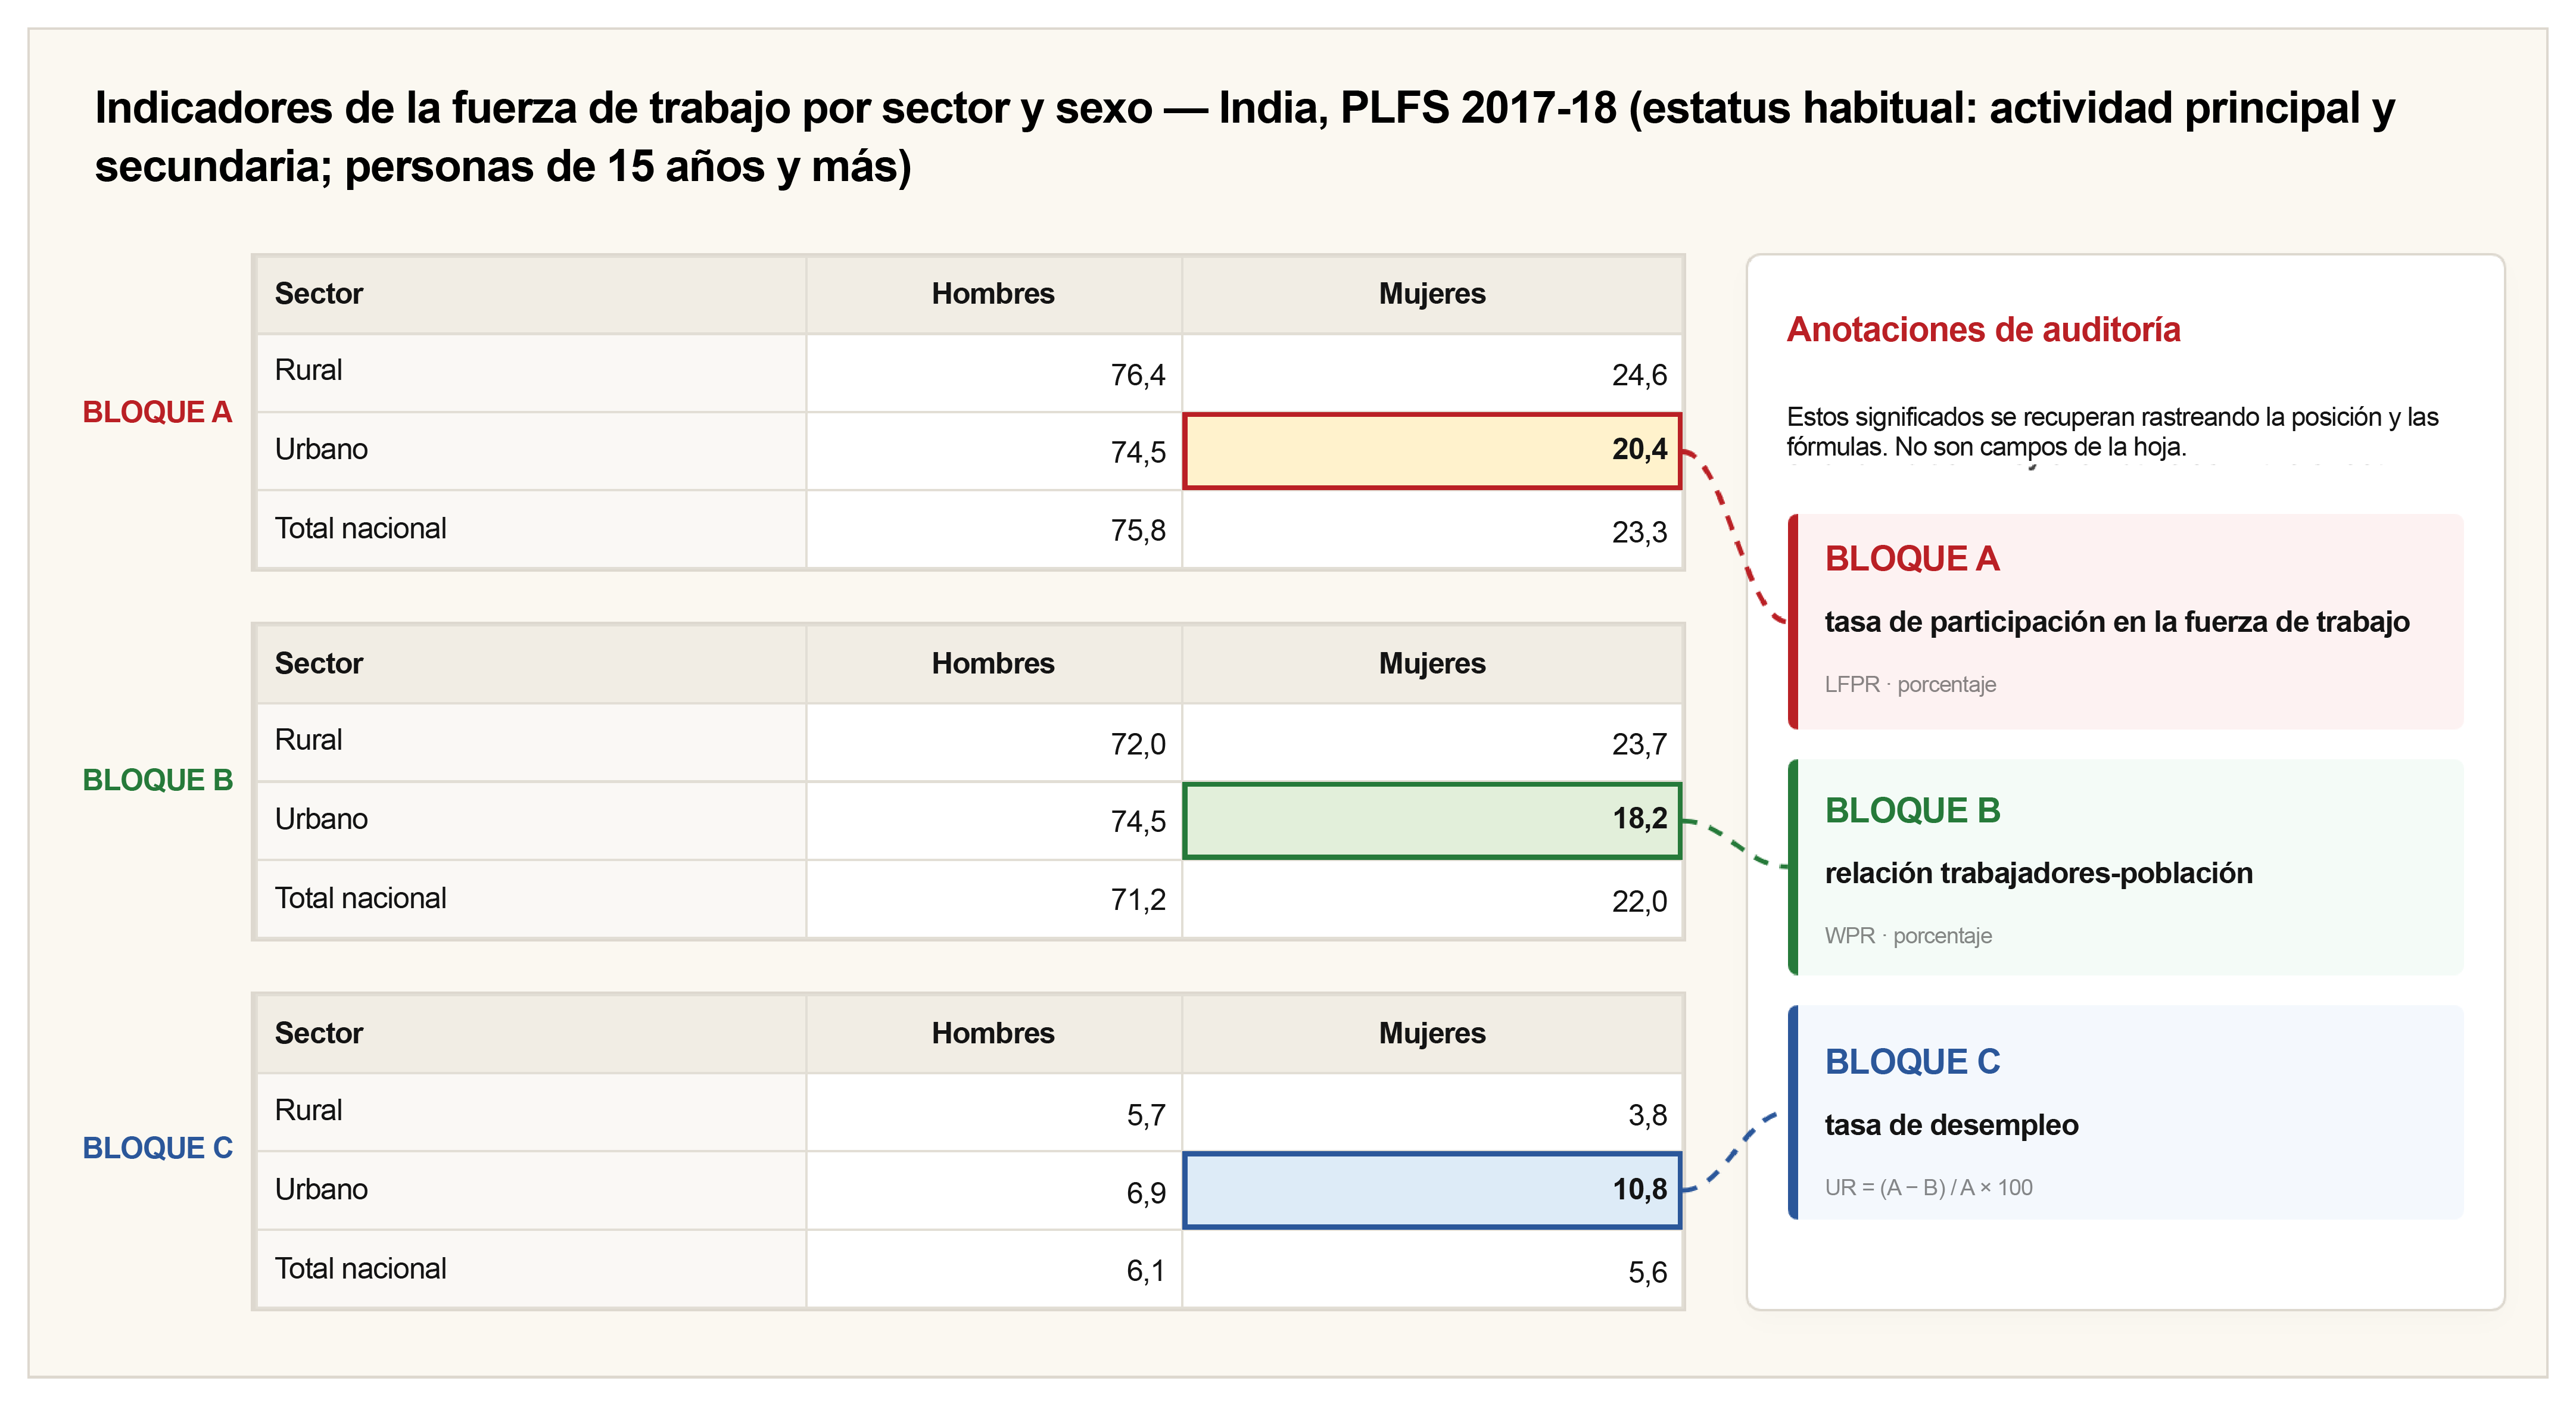
Figura 2. Indicadores de la fuerza de trabajo por sector y sexo, PLFS de la India 2017-2018 (hoja de cálculo de presentación; estatus habitual —actividad principal más actividad subsidiaria—; personas de 15 años o más; tasas en porcentaje).8
En el ejemplo anterior, la tasa de participación en la fuerza de trabajo, la relación trabajador-población y la tasa de desempleo aparecen en posiciones correspondientes en bloques separados. Para comprender cómo se relacionan entre sí, el lector debe seguir manualmente el diseño y las fórmulas. Eso puede ser suficiente para una lectura atenta, pero no lo es para un análisis que otra persona investigando pueda repetir y verificar.
Un conjunto de datos listo para el análisis debe organizarse de manera diferente. El significado de cada número debe estar integrado en el propio conjunto de datos: el sector, el sexo, la medida, la unidad y el valor deben aparecer como campos explícitos, no como pistas dispersas por todo el diseño. Las definiciones y fórmulas deben acompañar a la medida como metadatos, en lugar de deducirse a partir de la ubicación de un número en la cuadrícula. La pregunta pasa de ser “¿puedo ver el número correcto junto a la etiqueta correcta?” a “¿pueden otrxs investigadorxs verificar, agrupar, comparar y reproducir el registro sin tener que adivinar?”. Reestructurar la hoja de esa manera (Figura 3) convierte un diseño legible para humanos en evidencia verificable por una máquina.
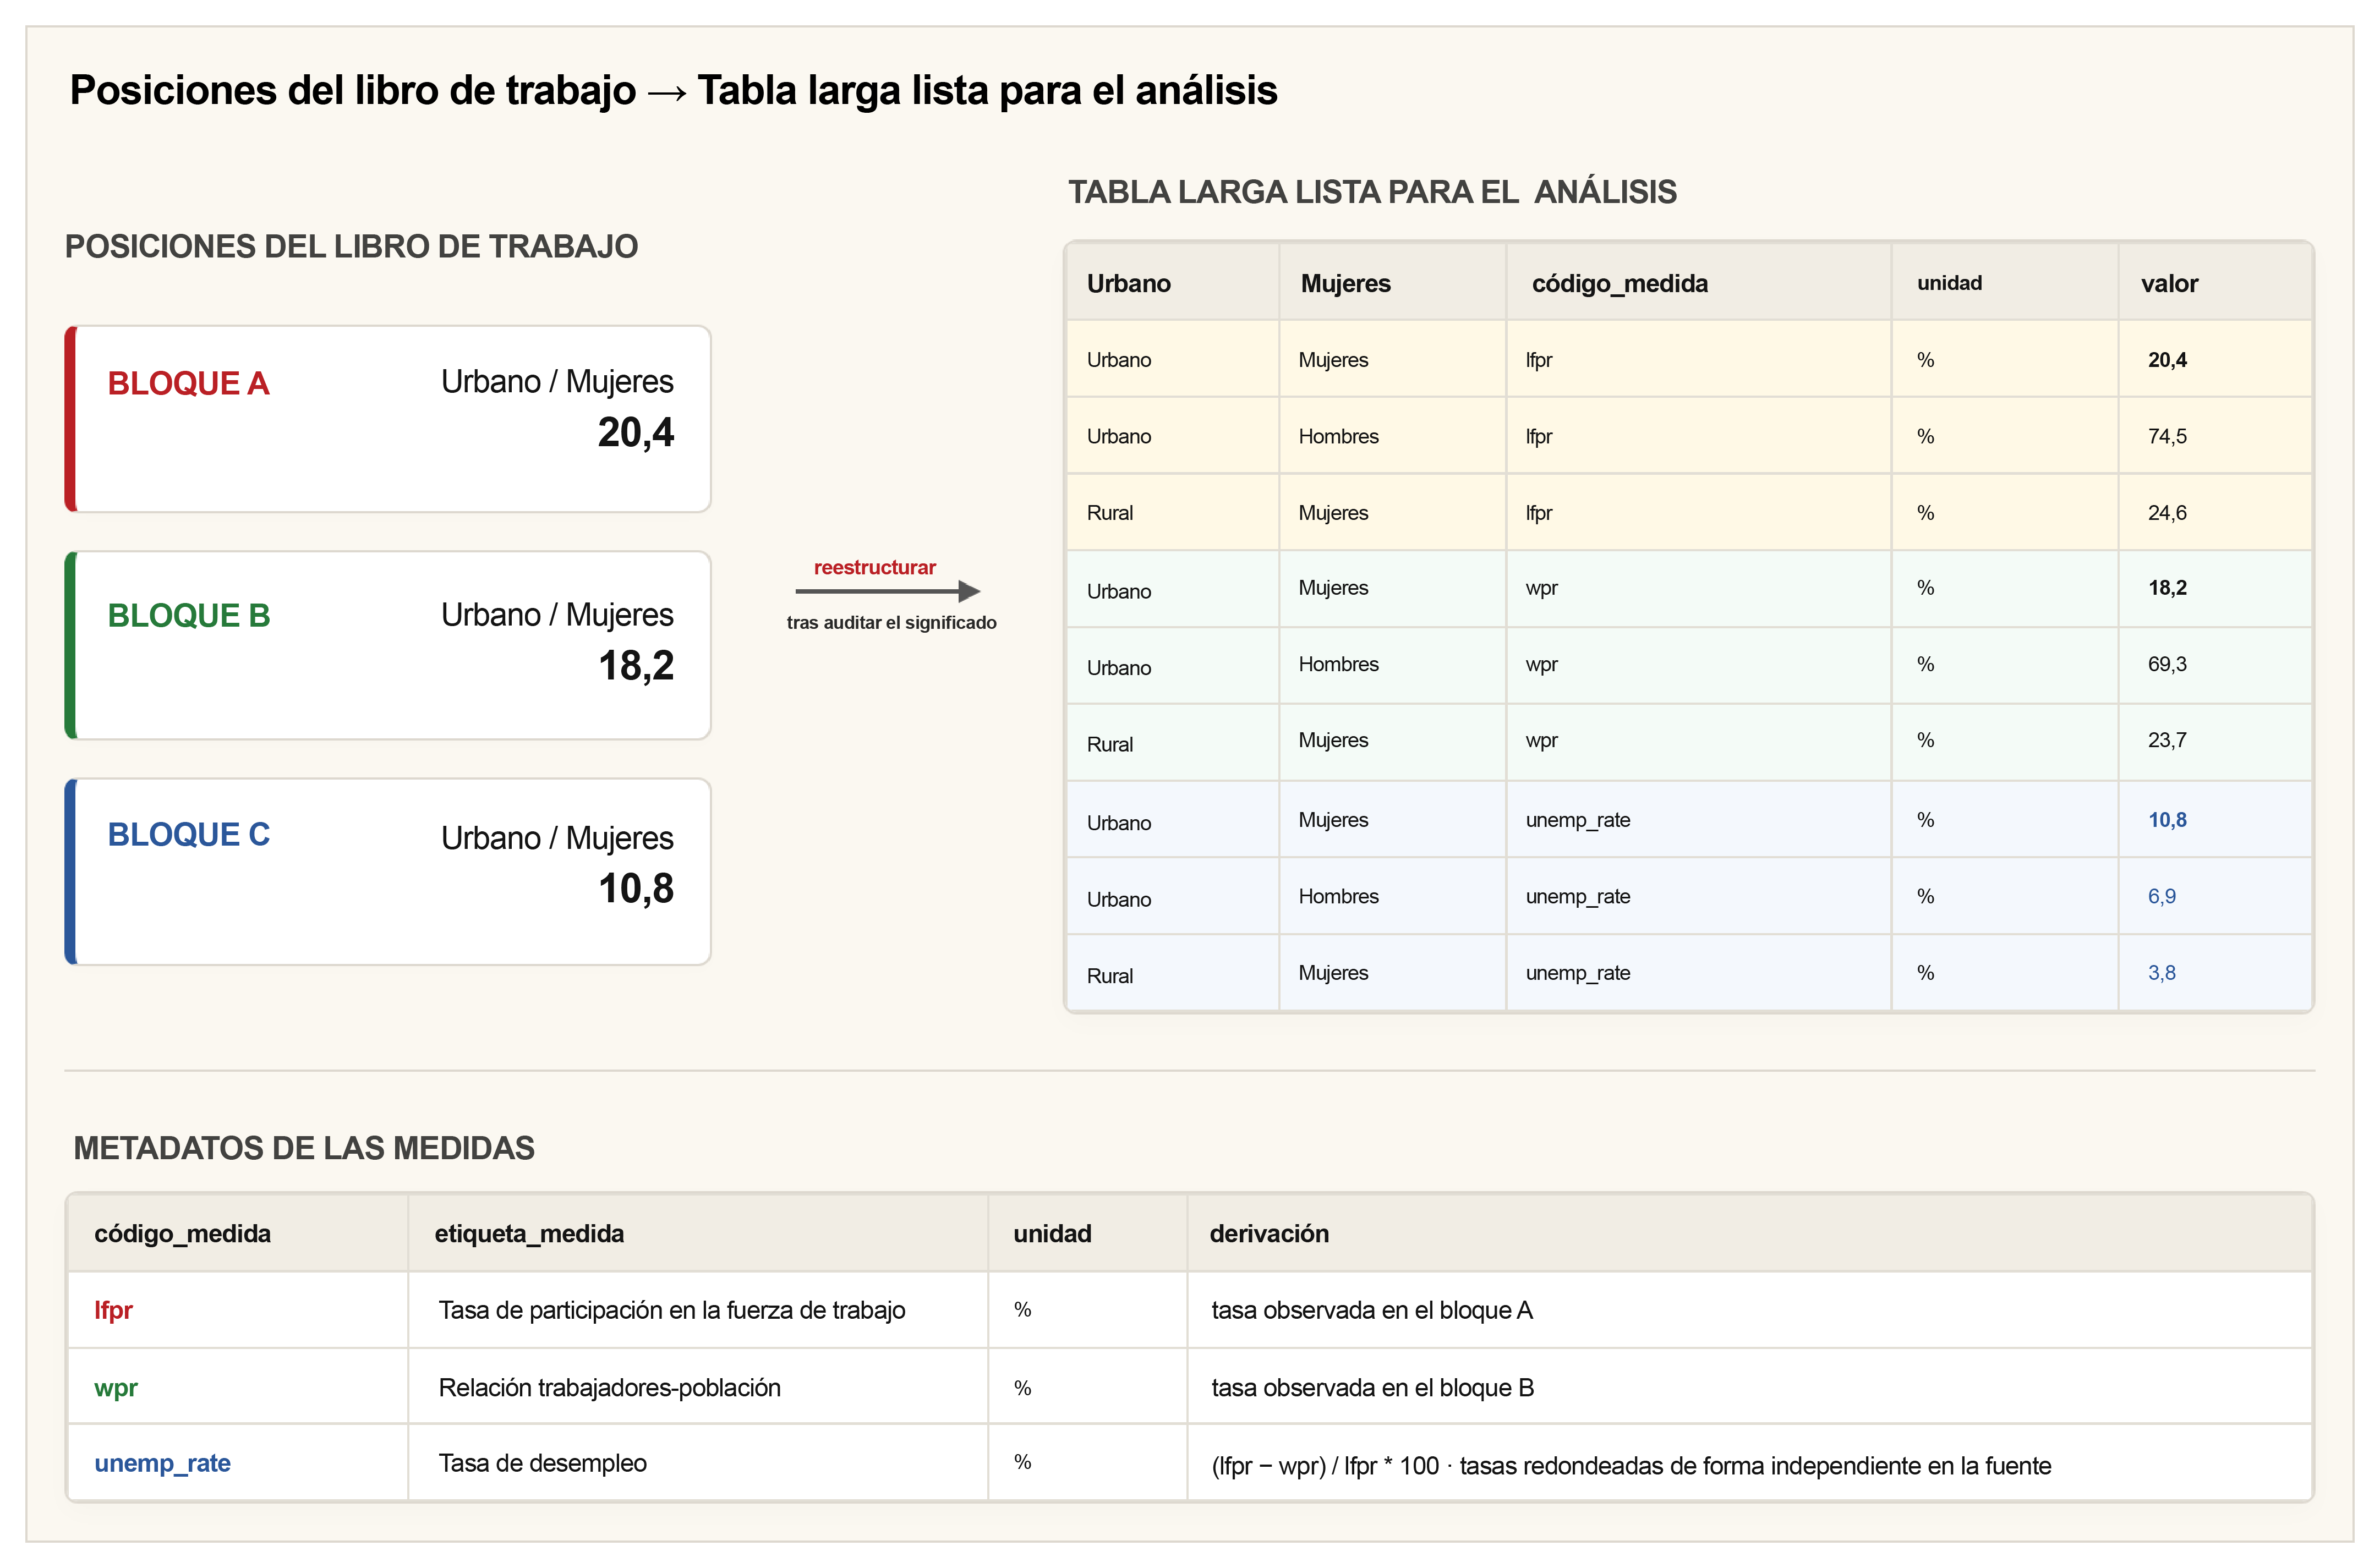
Figura 3. Del diseño del libro de trabajo a una tabla larga lista para el análisis, PLFS de la India 2017-2018 (estatus habitual: actividad principal más actividad subsidiaria; personas de 15 años o más; tasas en porcentaje; datos y definiciones como en la Figura 2).
Una vez que la medida es explícita, la cadena de evidencia puede verificarse e inspeccionarse. El código puede comprobar si los totales cuadran, si las categorías se repiten de manera consistente, si las tasas coinciden con sus datos de entrada y si faltan casos. El registro que acompaña al conjunto de datos —fuente, diseño, definiciones, fórmulas, exclusiones, verificaciones— permite que más investigadorxs sigan cada paso.
Sin esa estructura y ese registro, un gráfico puede parecer impecable, aunque se base en un número cuyo significado se dedujo a partir de su ubicación en la tabla. La evidencia no puede verificarse de manera independiente ni reutilizarse de manera confiable más allá de la persona que la depuró. Esa misma opacidad se repite en informes gubernamentales, bases de datos internacionales, resúmenes de encuestas, hojas de precios de productos básicos y archivos PDF estadísticos —en cualquier lugar donde las condiciones que hacen que los números sean utilizables como evidencia estén ocultas en el diseño, los metadatos, las definiciones y las prácticas institucionales—.
4. La IA reduce el costo del trabajo previo al análisis
En este contexto, la IA es importante porque reduce el costo del trabajo previo al análisis. Resulta más útil para los investigadores que tienen una pregunta clara, comprenden los conceptos estadísticos y pueden evaluar lo que está en juego políticamente, pero carecen de años de capacitación formal en ingeniería de datos.
Para los equipos de investigación con recursos limitados, un gran cuello de botella es la difícil transición de una tabla publicada a un conjunto de datos que se pueda consultar, verificar y analizar. El equipo debe identificar las variables implícitas, escribir el código que reformule la tabla, verificar las fórmulas y registrar de dónde proviene cada valor. Muchas investigaciones prometedoras se abandonan en esta etapa, no porque la pregunta sea débil, sino porque el camino desde el formato original hasta la evidencia es demasiado costoso.
La IA puede ayudar en varios puntos de esta transición, siempre y cuando cada paso siga estando abierto a la inspección humana.
Interpretación del diseño. La IA puede reducir las dificultades al ayudar a quienes investigan a mapear la estructura de los datos de origen. Un equipo de investigación puede describir una tabla en lenguaje sencillo —trimestres en las columnas, cohortes de edad en las filas, categorías por sexo repetidas en cada período y medidas agrupadas en bloques— y pedirle al sistema que proponga una estructura: período, grupo de edad, sexo, código de medida, unidad y valor. El objetivo no es externalizar el diseño, sino obtener un primer borrador que se pueda revisar, corregir y finalizar más rápido que si se partiera de un script en blanco.
Redacción del código. La IA puede ayudar a convertir el plan de investigación en un primer script funcional. Un equipo de investigación puede explicar qué debe hacerse con la tabla: mover los encabezados repetidos a sus propias columnas, combinar tablas relacionadas o listas de referencia, eliminar marcadores de notas al pie y otros patrones de texto recurrentes, unificar las etiquetas, convertir los números almacenados como texto en valores utilizables o registrar de dónde provienen las cifras originales. El script aún debe verificarse contra la fuente. Pero la IA puede reducir la barrera entre saber qué hay que hacer y poder ejecutar el código que lo haga.
Ejecución de las verificaciones. La IA también puede ayudar con la verificación. Un equipo de investigación puede pedirle que genere verificaciones de validación: ¿Las categorías por sexo suman los totales indicados? ¿Los subagregados regionales concuerdan con los agregados nacionales? ¿Una tasa coincide con su numerador y denominador? ¿Se omitió alguna fila durante el proceso de reestructuración? Estas verificaciones son la principal forma en que un equipo pequeño puede evitar que una afirmación empírica se aleje de su fundamento material.
Documentación del trabajo. La IA puede ayudar a convertir una sesión desordenada e interactiva de depuración de datos en un registro estructurado del trabajo: qué hojas y rangos de celdas se leyeron, qué filas se excluyeron, cómo se renombraron las variables, qué supuestos se hicieron y qué pruebas de validación tuvieron éxito. Ese registro puede escribirse en formato Markdown, JSON o cualquier otro que el equipo pueda revisar. Sin esto, el análisis sigue siendo un oficio aislado. Los equipos de investigación se ven obligados a reconstruir los mismos pasos una y otra vez, mientras que las instituciones con sistemas de gestión de datos más sólidos conservan la autoridad para definir la narrativa dominante.
Las visualizaciones de diagnóstico amplían esa misma lógica. Los gráficos de líneas, de barras y los histogramas pueden revelar rupturas estructurales, períodos duplicados, categorías que faltan o valores atípicos mientras aún se están recabando pruebas, antes de que se haya redactado una afirmación basada en un patrón erróneo.
Cabe mencionar aquí una advertencia política: depurar datos administrativos sensibles con una herramienta de IA externa puede hacer que esos datos sean legibles para la empresa que opera el modelo, dependiendo de sus prácticas de retención de datos. Esa misma acción puede desarrollar la capacidad de investigación y abrir un nuevo punto de extracción.
En conjunto, estos pasos colocan a la IA dentro del flujo de trabajo de medición en lugar de por encima de él (Figura 4). La IA puede reducir el costo de pasar de una fuente a una estructura, un conjunto de verificaciones y un registro. Pero el trabajo que le da un significado público a los números —confirmar la fuente, verificar las definiciones e interpretar el resultado— sigue estando en manos humanas.
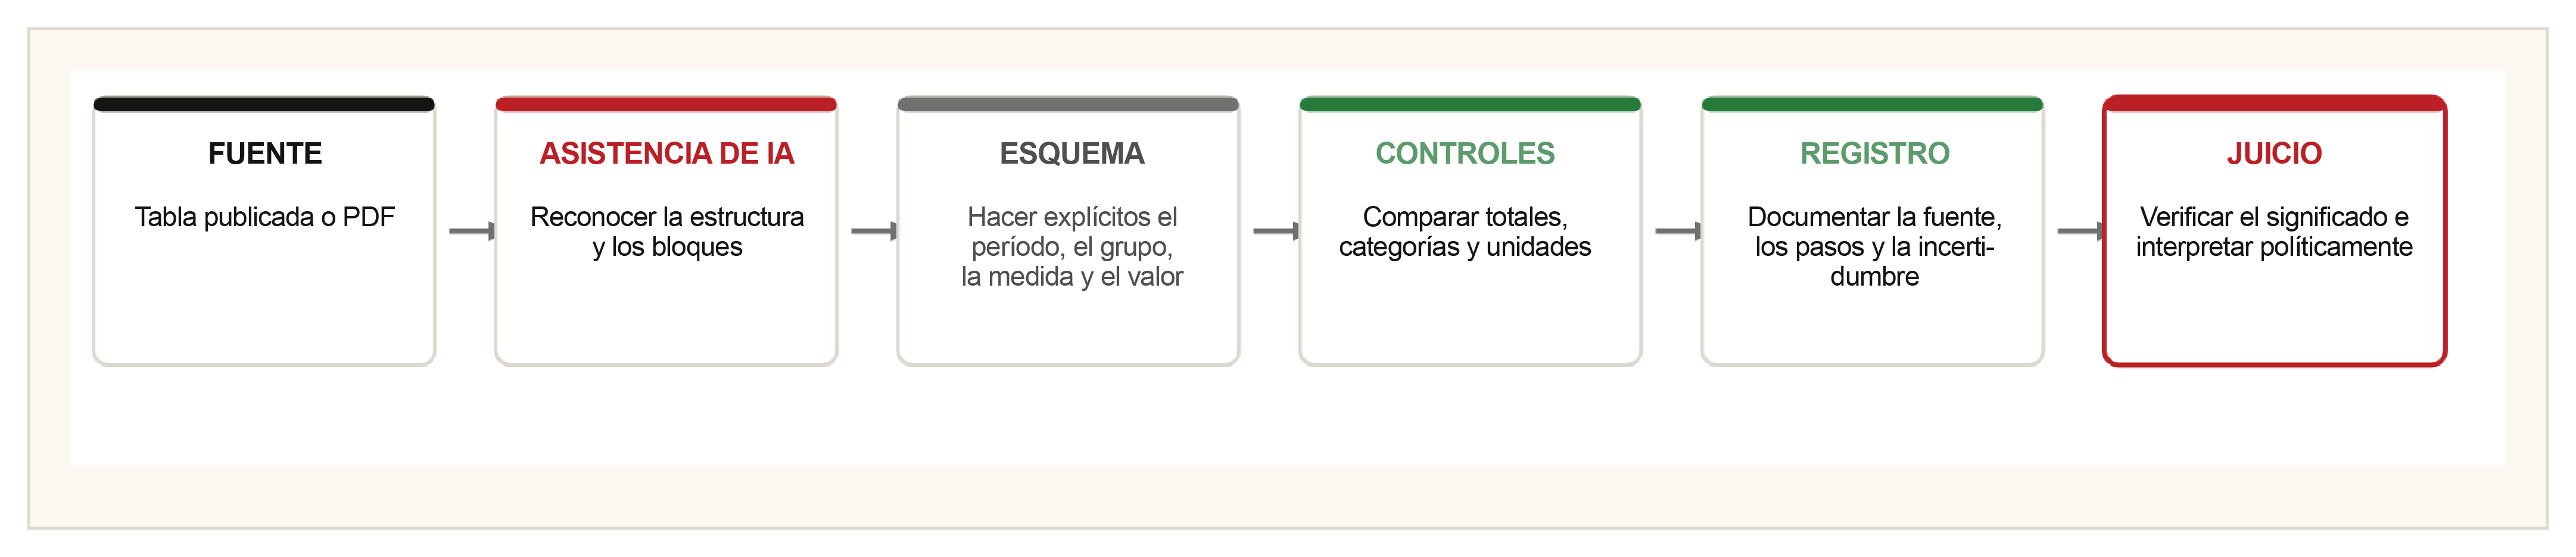
Figura 4. Dónde interviene la IA en el flujo de trabajo de medición (esquema; sin datos).
La IA puede automatizar partes del flujo de trabajo cuantitativo, pero no puede reemplazar a la investigación cuantitativa en su totalidad. Tampoco hace que la programación quede obsoleta. La oportunidad política radica en que los equipos de investigación pueden dedicar menos tiempo a lidiar con la sintaxis y más tiempo a las definiciones estadísticas, el diseño conceptual y la interpretación político-económica.
En la práctica, esto significa que los equipos de investigación locales, los sindicatos y las instituciones públicas regionales del Sur Global ahora pueden transformar informes administrativos densos y mal formateados en bases de datos auditables que otros puedan inspeccionar, reutilizar y cuestionar. Esto extiende el marco de IA para las Ciencias Sociales (AI4SS) de Circuitos de Bandung al terreno de la medición, aplicando su preocupación por la soberanía de la investigación al trabajo de convertir los números en evidencia.9
5. La IA no puede reemplazar el juicio
Facilitar la preparación de datos no es lo mismo que sustituir el juicio intelectual.
Un sistema de IA puede reformular un archivo sin comprender su contenido. Puede inferir un diseño tabular sin saber si un valor determinado es un numerador, un denominador, un total, una tasa, una proporción o un índice. Puede generar un conjunto de datos limpio a partir de una premisa errónea. Puede acelerar la investigación, pero también puede acelerar los errores sistemáticos.
El principio fundamental sigue siendo el mismo: la IA puede transformar el archivo, pero un equipo de analistas debe verificar lo que el archivo representa realmente.
La verificación es el punto donde convergen la definición estadística, la interpretación económica y la responsabilidad política. Lxs investigadorxs aún deben decidir qué actividades se consideran trabajo, qué denominador corresponde a una tasa, si las categorías históricas siguen siendo comparables a lo largo del tiempo, si una serie nominal debe ajustarse por la inflación y si un índice de precios elegido responde genuinamente a la pregunta de investigación. También deben preguntarse si un indicador oficial oculta el trabajo informal, los cuidados no remunerados, la degradación ecológica o la distribución de clases.
Esa misma limitación se observa en las investigaciones sobre el trabajo informal. Un sistema de IA puede aislar categorías como el trabajo por cuenta propia o el trabajo familiar auxiliar. Pero no puede determinar si una categoría se entiende mejor como un medio de vida independiente, trabajo asalariado encubierto, una estrategia de supervivencia del hogar o una posición de subordinación aguda dentro de una cadena de extracción más amplia. Traducir una categoría estadística en una relación social concreta requiere un juicio político-económico. Ninguna máquina puede asumir la responsabilidad de cómo una investigación interpreta la clase, el valor, la dependencia o la explotación.
La IA puede recomendar verificaciones de validación, pero no puede discernir qué discrepancia es políticamente relevante. Una pequeña discrepancia en un total puede ser un problema de redondeo; un denominador que excluye silenciosamente a trabajadores y trabajadoras migrantes puede cambiar el significado social de toda la tasa. La IA puede generar un gráfico, pero no puede asumir la responsabilidad de la afirmación pública que se le atribuye.
Usar la IA de manera responsable no significa delegar el juicio a un algoritmo. Significa integrar la máquina en un flujo de trabajo de investigación disciplinado —verificar fuentes, conciliar totales, documentar cada paso— e interpretar el resultado políticamente. Cuanto más poderosas se vuelven estas herramientas computacionales, más claramente deben comprender quienes investigan sus límites.
6. Del acceso a los datos a la capacidad de investigación
A estas alturas, el problema ya no es solo si se puede acceder a los datos. Se trata de si los equipos de investigación tienen la capacidad de convertir esos datos en evidencia que pueda ser puesta a prueba y defendida. Un conjunto de datos puede ser público y, aun así, resultar políticamente inutilizable si quienes investigan carecen del tiempo, las herramientas, los conceptos y el apoyo institucional para trabajar con él. Lo que importa es quién puede sostener toda la cadena: formular la pregunta, estructurar los datos, validar las transformaciones, interpretar los resultados y llevar los hallazgos al debate público.
Si la producción de conocimiento tiene sus propios “medios de producción”, entonces la investigación cuantitativa no es la excepción. Requiere datos y software, conceptos estadísticos y teoría económica, infraestructura y documentación, y, sobre todo, tiempo institucional. A este conjunto más amplio de condiciones lo llamamos los medios de la investigación cuantitativa. No se trata de un solo paquete de software, sino de la capacidad colectiva para analizar los números. El trabajo de medición es una capa fundamental, aunque a menudo oculta, de esta capacidad; es el punto en el que las condiciones estructurales de la investigación cuantitativa se convierten por primera vez en trabajo.
El cambio central no radica en las preguntas que plantean quienes investigan, sino en los recursos necesarios para responderlas con evidencia. Al reducir ese umbral de recursos, la IA puede cambiar quién construye y defiende una base de evidencia. El primer cambio consiste en un acceso más amplio a los materiales. Un equipo de investigación que antes se limitaba a una tabla en PDF escaneada ahora puede construir una base de datos auditable. El segundo es un acceso más profundo a los constructos estadísticos. Investigadores e investigadoras de la sociedad civil que antes tenían que aceptar un indicador externo ya elaborado ahora puede desmontarlo y examinar su numerador, denominador y lógica de medición. El tercero es la capacidad de construir una base de evidencia propia. Una institución pública local que antes consumía pasivamente las clasificaciones internacionales ahora puede evaluar si esos marcos se alinean con su mandato y elaborar contraevidencias rigurosas cuando no es así. La Comisión Económica para América Latina y el Caribe de las Naciones Unidas muestra cómo se manifiesta esa tercera capacidad cuando se mantiene a escala institucional. Prebisch la dirigió de 1950 a 1963, y esta ha producido estadísticas alternativas de desarrollo para la región durante casi ocho décadas.10
Se trata, fundamentalmente, de una cuestión de soberanía metodológica. No significa que cada institución deba inventar sus propias estadísticas o ignorar la comparabilidad. Significa tener la capacidad de examinar las medidas heredadas, comprobar si responden a las preguntas locales y regionales, documentar opciones alternativas y hacer que esas opciones rindan cuentas ante el debate público. Para estudiantes de posgrado, esto puede significar reproducir un gráfico oficial en lugar de simplemente citarlo. Para un sindicato, un instituto de investigación o una agencia pública, puede significar mantener una base de evidencia alternativa que pueda resistir el escrutinio público. La Campaña del Plan Popular de Kerala, lanzada en 1996, es un ejemplo concreto de ese equilibrio. Los organismos locales recopilaron sus propios datos y establecieron sus propias prioridades de desarrollo, dentro de un marco de planificación común que mantuvo la comparabilidad de los planes en todo el estado —y la planificación descentralizada que se construyó continúa bajo la Junta de Planificación del Estado de Kerala—.11
La soberanía metodológica es fundamental cuando las estadísticas deciden el futuro de un país. En Pakistán —como documenta el Instituto Tricontinental de Investigación Social en el dossier nº 69, Cómo el Fondo Monetario Internacional está exprimiendo a Pakistán— el FMI ha condicionado sus préstamos a medidas de austeridad: eliminar los subsidios a la electricidad, el gas y el combustible, aumentar las tasas de interés y dejar que el mercado fije el tipo de cambio.12 El Fondo justifica estas condiciones mediante una evaluación agregada de la sostenibilidad de la deuda. Su criterio de lo que es “sostenible” llega a los hogares en forma de precios del gas para cocinar y de la electricidad. Para mostrar cómo se distribuye esa carga, investigadores locales y los sindicatos necesitan la capacidad de trabajar con microdatos de encuestas de hogares, reponderar los índices de precios de acuerdo con los patrones de consumo locales y estimar los efectos de los recortes propuestos en diferentes grupos, particularmente en los hogares de la clase trabajadora. Contar con los medios para realizar investigaciones cuantitativas permite a lxs investigadorxs ir más allá de simplemente reaccionar ante las afirmaciones del FMI: pueden cuestionar sus cálculos con evidencia que resista el escrutinio técnico y equipar a los sindicatos, movimientos y gobiernos dispuestos a impugnar sus recomendaciones.
Lo que cambia la IA depende de quién la utilice. En manos de las instituciones dominantes, puede producir las mismas narrativas de indicadores prefabricadas a un ritmo más rápido. En manos de investigadorxs, sindicatos, movimientos sociales y organismos públicos en el Sur Global, puede ampliar el número de personas capaces de construir y defender una base de evidencia. Ese acceso más amplio no implica estándares más bajos. Requiere definiciones más claras, linajes de datos más trazables, transformaciones más reproducibles, protocolos de verificación más explícitos y una interpretación más responsable. El objetivo no es adaptar las cifras a una narrativa predeterminada, sino permitir que más investigadorxs verifiquen lo que las cifras pueden y no pueden decir.
7. ¿Quién establece los términos del recuento?
El rigor es importante porque las cifras tienen poder en la vida pública. Pero no todo lo que tiene valor debe convertirse en una métrica. Algunas relaciones de solidaridad y subsistencia se resisten al recuento, y así debe ser. La afirmación más específica es que quien establece los términos del recuento ejerce el poder real, y ese poder no debe recaer únicamente en el Norte. Esa es también la prueba a la que debe someterse la IA: no que la IA piense por los equipos de investigación, sino que más investigadorxs cuenten con las condiciones para pensar con las cifras.
¿Quién tiene derecho a cuestionar los números? ¿Quién tiene derecho a convertir los números en evidencia? ¿Quién tiene derecho a usar esa evidencia para desafiar los marcos establecidos por otros? En el Sur Global, la soberanía metodológica comienza ahí: en la capacidad de cuestionar los números heredados, defender la evidencia construida a partir de ellos y movilizarla para la emancipación política y social.
[1] Annual Report, Periodic Labour Force Survey (PLFS) 2017-18, Oficina Nacional de Encuestas por Muestreo, Ministerio de Estadística y Ejecución de Programas, Gobierno de la India (informe publicado el 31 de mayo de 2019). Sobre la retención del informe por parte del gobierno y la renuncia de dos miembros de la Comisión Nacional de Estadística el 28 de enero de 2019, véanse Business Standard, “Unemployment rate at four-decade high of 6.1% in 2017-18: NSSO survey” (31 de enero de 2019), https://www.business-standard.com/article/economy-policy/unemployment-rate-at-five-decade-high-of-6-1-in-2017-18-nsso-survey-119013100053_1.html; y The Tribune, “NSC controversy”, https://www.tribuneindia.com/news/archive/editorials/nsc-controversy-723433.
[2] Sobre los estándares internacionales de datos y su alcance: Boletín de Normas de Difusión del FMI, https://dsbb.imf.org/; Sistema de Cuentas Nacionales de las Naciones Unidas, División de Estadística, https://unstats.un.org/unsd/nationalaccount/. Sobre el financiamiento del Banco Mundial para construir o reformar los sistemas nacionales de estadística, véase el Programa de Fortalecimiento de la Capacidad Estadística (STATCAP) del Banco Mundial, https://www.worldbank.org/en/data/statistical-capacity-building/statcap. Sobre las metodologías de calificación soberana —que combinan evaluaciones institucionales, económicas, externas, fiscales y monetarias en un nivel de calificación indicativo, permiten ajustes complementarios específicos y dejan la determinación final en manos de un comité de calificación—, véase S&P Global Ratings, Criteria | Governments | Sovereigns: Sovereign Rating Methodology, 18 de diciembre de 2017, https://spratings.prod.ratings.spglobal.com/ratings/en/regulatory/article/-/view/sourceId/10221157.
[3] Raúl Prebisch, The Economic Development of Latin America and Its Principal Problems (Lake Success, NY: Comisión Económica para América Latina de las Naciones Unidas, 1950).
[4] Walter Rodney, How Europe Underdeveloped Africa (Londres: Bogle-L’Ouverture Publications, 1972).
[5] Geoffrey C. Bowker y Susan Leigh Star, Sorting Things Out: Classification and Its Consequences (Cambridge, MA: MIT Press, 1999).
[6] Karl Marx, El capital, vol. I (1867), especialmente la parte I sobre la mercancía y la forma de valor.
[7] Banco Mundial, “The Pink Sheet” de los mercados de productos básicos (datos anuales de precios), Commodity Markets Outlook, https://www.worldbank.org/en/research/commodity-markets.
[8] Los tres bloques utilizan los valores de la PLFS 2017-2018 en situación habitual —actividad principal más actividad subsidiaria (la base “ps+ss” de la encuesta)— para personas de 15 años o más: tasa de participación en la fuerza de trabajo (cuadro 8), relación trabajador-población (cuadro 11) y tasa de desempleo (cuadro 32 y tabla 18 del apéndice, “grupos de edad: 15 años o más”). Oficina Nacional de Encuestas por Muestreo, Annual Report, Periodic Labour Force Survey (PLFS) 2017-18 (2019), https://www.mospi.gov.in/sites/default/files/publication_reports/Annual%20Report%2C%20PLFS%202017-18_31052019.pdf?download=1. Cada tasa se estima y se redondea de manera independiente en la fuente, por lo que la tasa de desempleo coincide con la diferencia entre la tasa de participación en la fuerza de trabajo y la relación trabajador-población, expresada como una proporción de la tasa de participación, solo hasta el redondeo.
[9] Véanse también “Un método sistemático para controlar el estilo de redacción de la IA”, https://thetricontinental.org/es/a-systematic-method-for-controlling-ai-writing-style/, y “How to Analyse and Critique Research with AI”, https://thetricontinental.org/how-to-analyse-and-critique-research-with-ai/.
[10] Comisión Económica para América Latina y el Caribe de las Naciones Unidas (CEPAL), fundada en 1948; Prebisch la dirigió de 1950 a 1963. Véase CEPAL, “Prebisch and ECLAC”, https://biblioguias.cepal.org/prebisch_en/prebisch-and-eclac.
[11] Sobre la Campaña del Plan Popular de Kerala, lanzada el 17 de agosto de 1996, y su planificación descentralizada, véanse T. M. Thomas Isaac con Richard W. Franke, Local Democracy and Development: People’s Campaign for Decentralized Planning in Kerala (Nueva Delhi: LeftWord Books, 2000), especialmente los caps. 5-7 sobre los informes de desarrollo, los formatos de proyectos y los documentos de planificación; y Junta Estatal de Planificación de Kerala, División de Planificación Descentralizada, https://spb.kerala.gov.in/en/decentralised-planning-division.
[12] Instituto Tricontinental de Investigación Social, dossier nº 69, Cómo el Fondo Monetario Internacional está exprimiendo a Pakistán (17 de octubre de 2023), https://thetricontinental.org/es/dossier-69-como-el-fmi-asfixia-a-pakistan/; para conocer el marco del propio Fondo, véase FMI, Pakistán: Solicitud de un acuerdo de derecho de giro, Informe del FMI sobre el país nº 23/260 (julio de 2023), https://www.imf.org/en/publications/cr/issues/2023/07/17/pakistan-request-for-a-stand-by-arrangement-press-release-staff-report-staff-statement-and-536494, que incluye el análisis de sostenibilidad de la deuda.
Autor |
Editores |