Cómo convertir PDF escaneados con Docling
Por qué los PDF escaneados son un problema
Existen numerosos artículos académicos, documentos históricos y registros oficiales que solo están disponibles como imágenes escaneadas, página tras página de píxeles bloqueados que las herramientas estándar basadas en texto no pueden tocar.
Cuando su investigación implica extraer citas, tablas o referencias de docenas de estos archivos, la transcripción manual se convierte en un cuello de botella serio. Existen motores de Reconocimiento Óptico de Caracteres (OCR por siglas en inglés), pero integrarlos en un flujo de trabajo asistido por IA, fiable y repetible, dista mucho de ser sencillo: la mayoría de los resultados de OCR sin procesar pierden encabezados, fusionan columnas o mezclan las estructuras de las tablas, lo que hace imposible que un gran modelo de lenguaje (LLM, por sus siglas en inglés) razone sobre el documento con confianza.
Necesita una herramienta que no solo “lea” la imagen, sino que también reconstruya el diseño lógico del documento y devuelva un texto limpio, estructurado y apto para máquinas. Es exactamente para esto que está diseñado Docling.
Qué hace Docling
Docling es una herramienta de comprensión de documentos de código abierto que convierte una amplia variedad de formatos de documentos en información estructurada que los agentes de IA pueden consumir. Mucho más que un simple contenedor de OCR, procesa materiales donde el texto, las tablas y las imágenes están intercalados, incluyendo diseños de múltiples columnas, notas manuscritas y PDF complejos que en realidad son solo fotografías escaneadas.
Capacidades clave que distinguen a Docling:
- Comprensión de contenido mixto, maneja documentos donde el orden de lectura natural no coincide con el flujo del PDF en bruto. Las tablas siguen siendo tablas, las figuras conservan sus pies de foto y los encabezados no se vuelcan en el cuerpo.
- Flexibilidad de formatos, acepta PDF, DOCX, PPT, XLSX, HTML, imágenes (PNG, JPEG, TIFF), LaTeX, texto plano, WAV, MP3 y WebVTT. Esto amplía drásticamente la gama de material de origen con el que un agente de IA puede trabajar posteriormente.
- Integración con MCP, a través del Model Context Protocol (MCP), Docling se convierte en un servicio que un agente puede invocar directamente. Esto cierra el ciclo “cargar → convertir → consultar” dentro de una sola conversación, sin que tenga que salir de la interfaz de chat.
En resumen, Docling toma una fotografía de una página y la transforma en un archivo Markdown que conserva la estructura real del contenido. Esa estructura es lo que marca la diferencia entre una IA que alucina un resumen que suena plausible y otra que realmente cita el párrafo correcto.
Instalación local de Docling
Los pasos que se indican a continuación utilizan un agente en VS Code, pero el mismo método funciona en cualquier entorno compatible con MCP.
Primero, abra el panel de chat de su agente.
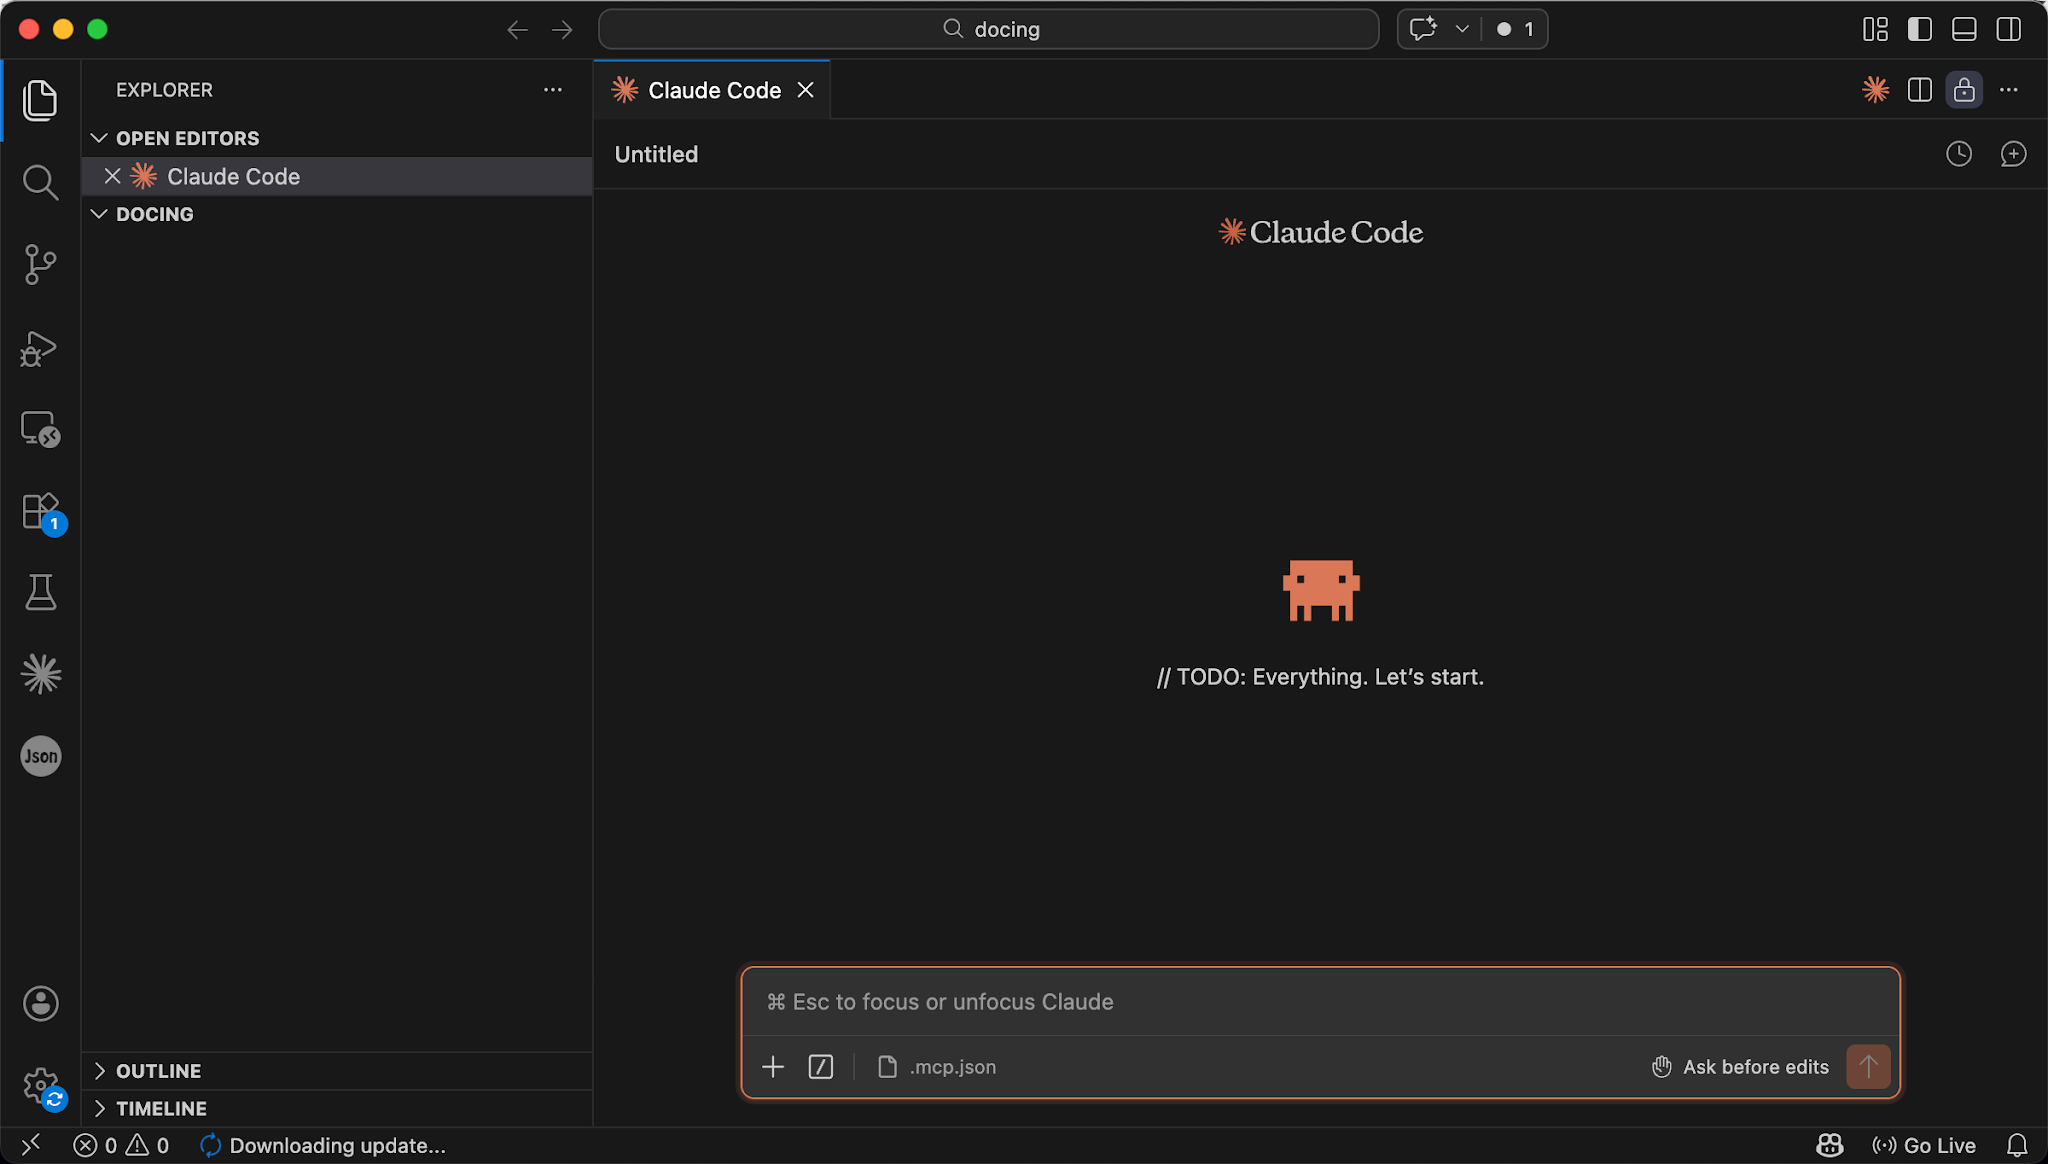
Panel del agente
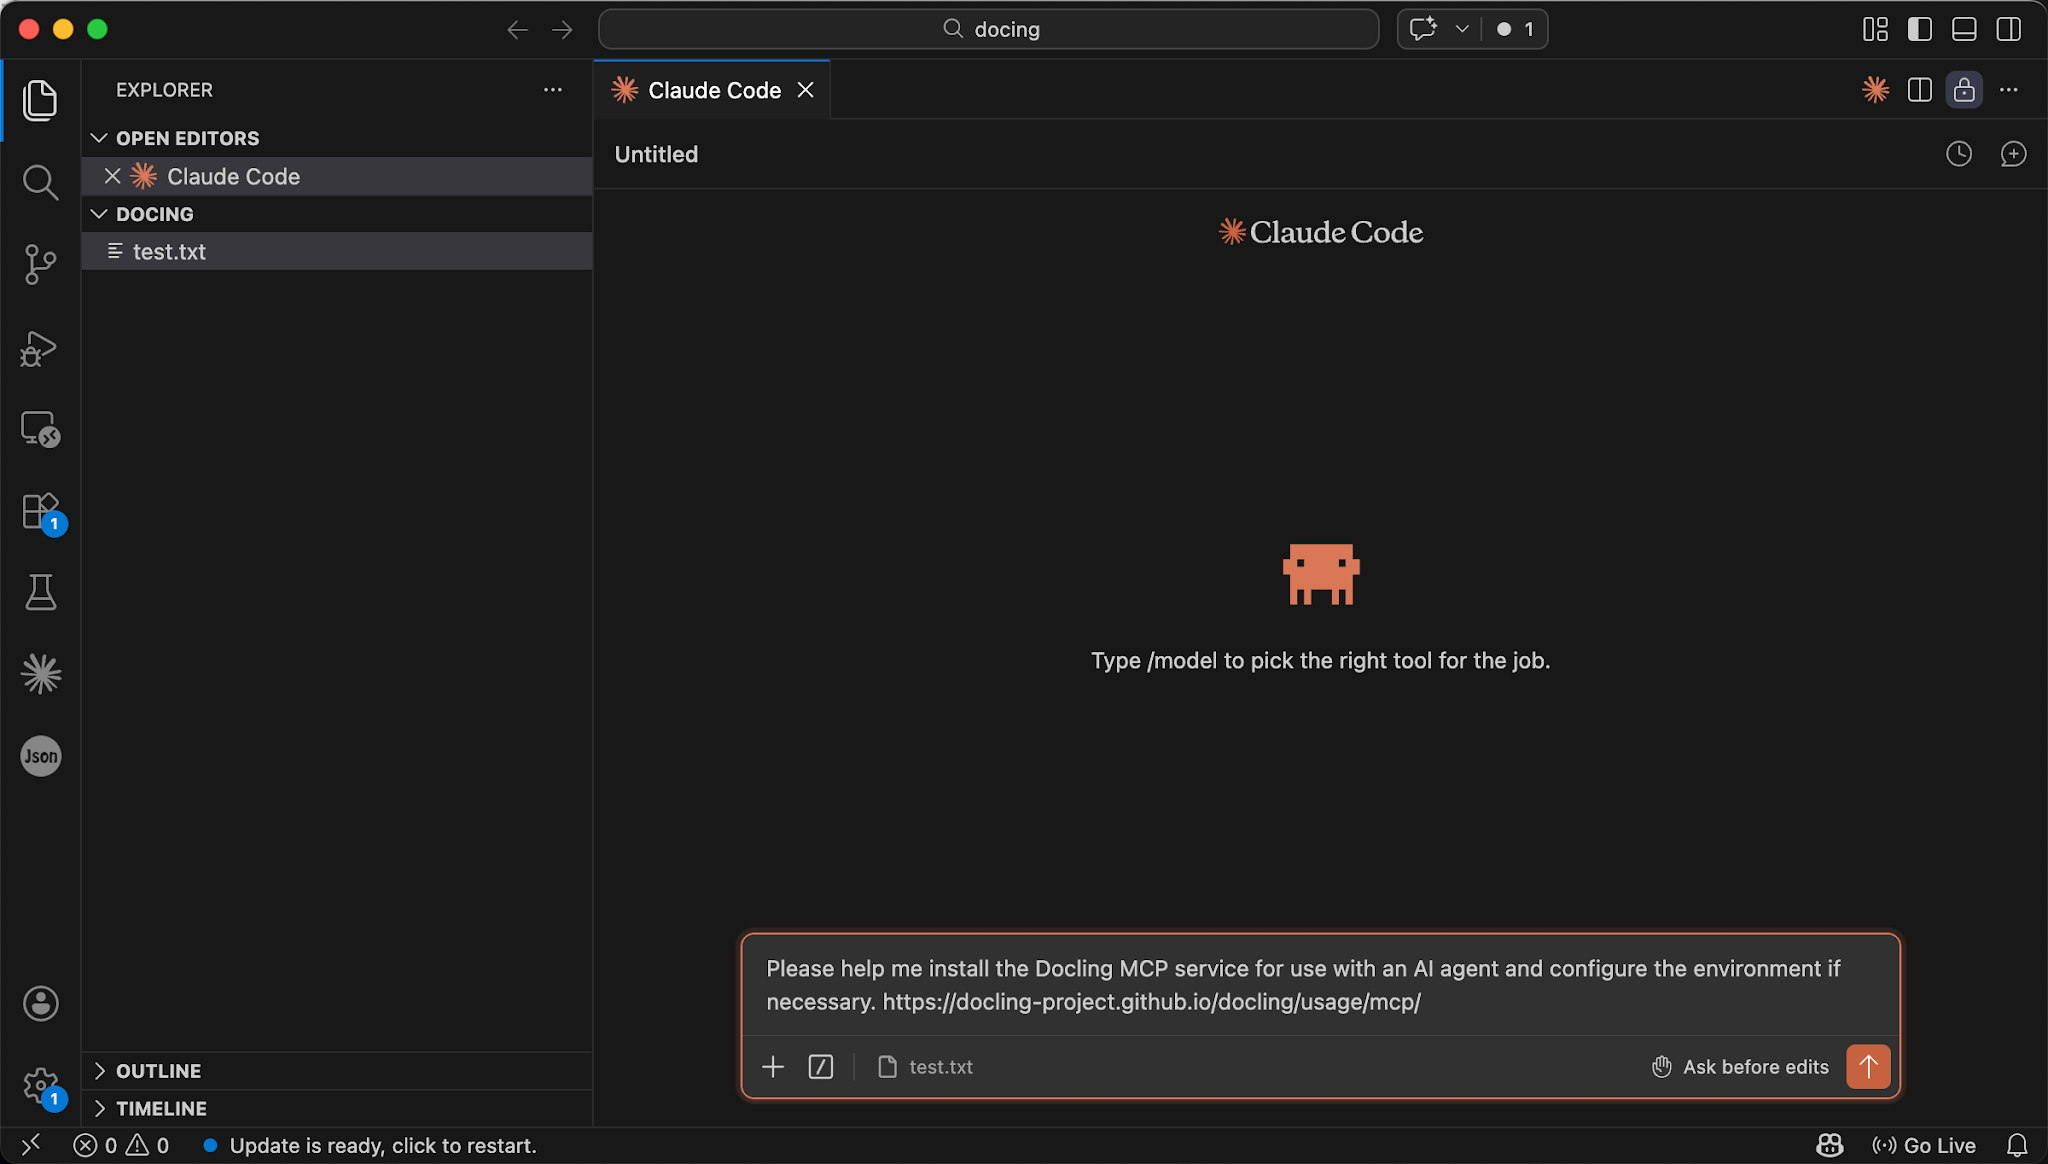
Los agentes de IA modernos a menudo pueden localizar y aplicar las instrucciones de instalación por sí mismos. Para comenzar, introduzca un prompt que describa exactamente lo que desea:
Por favor, ayúdame a instalar el servicio de Docling MCP para usarlo con un agente
de IA y a configurar el entorno si es necesario.
Para la configuración, consulta la documentación en
https://docling-project.github.io/docling/usage/mcp/
El estado del MCP muestra Connected después de los pasos manuales
Una vez que el agente confirma que la configuración se ha completado, Docling está listo para usarse.
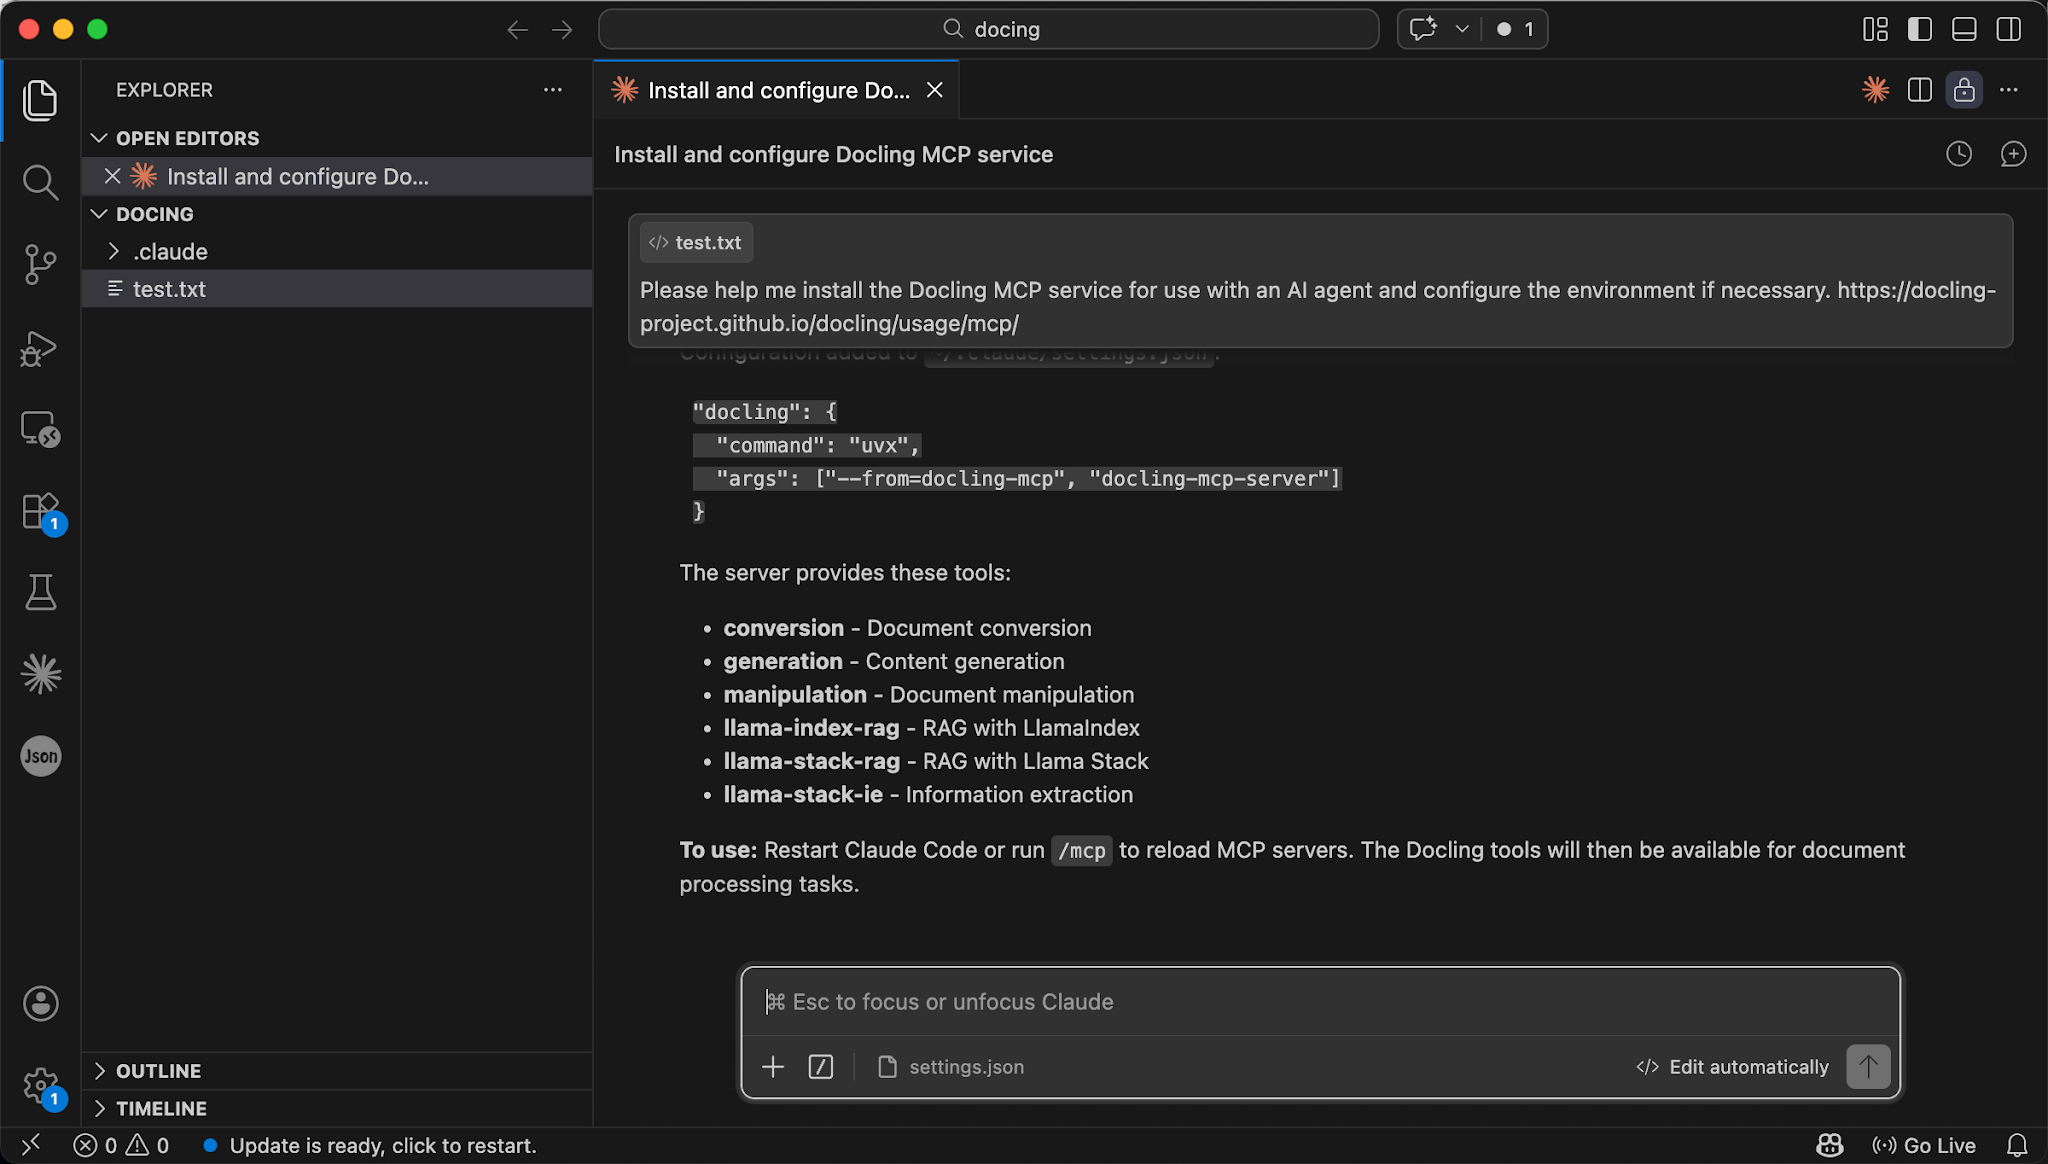
El agente confirma que la instalación se ha completado
Puede verificar la instalación escribiendo el comando /mcp en el diálogo. Esto enumera todos los servidores MCP conectados actualmente a su agente.
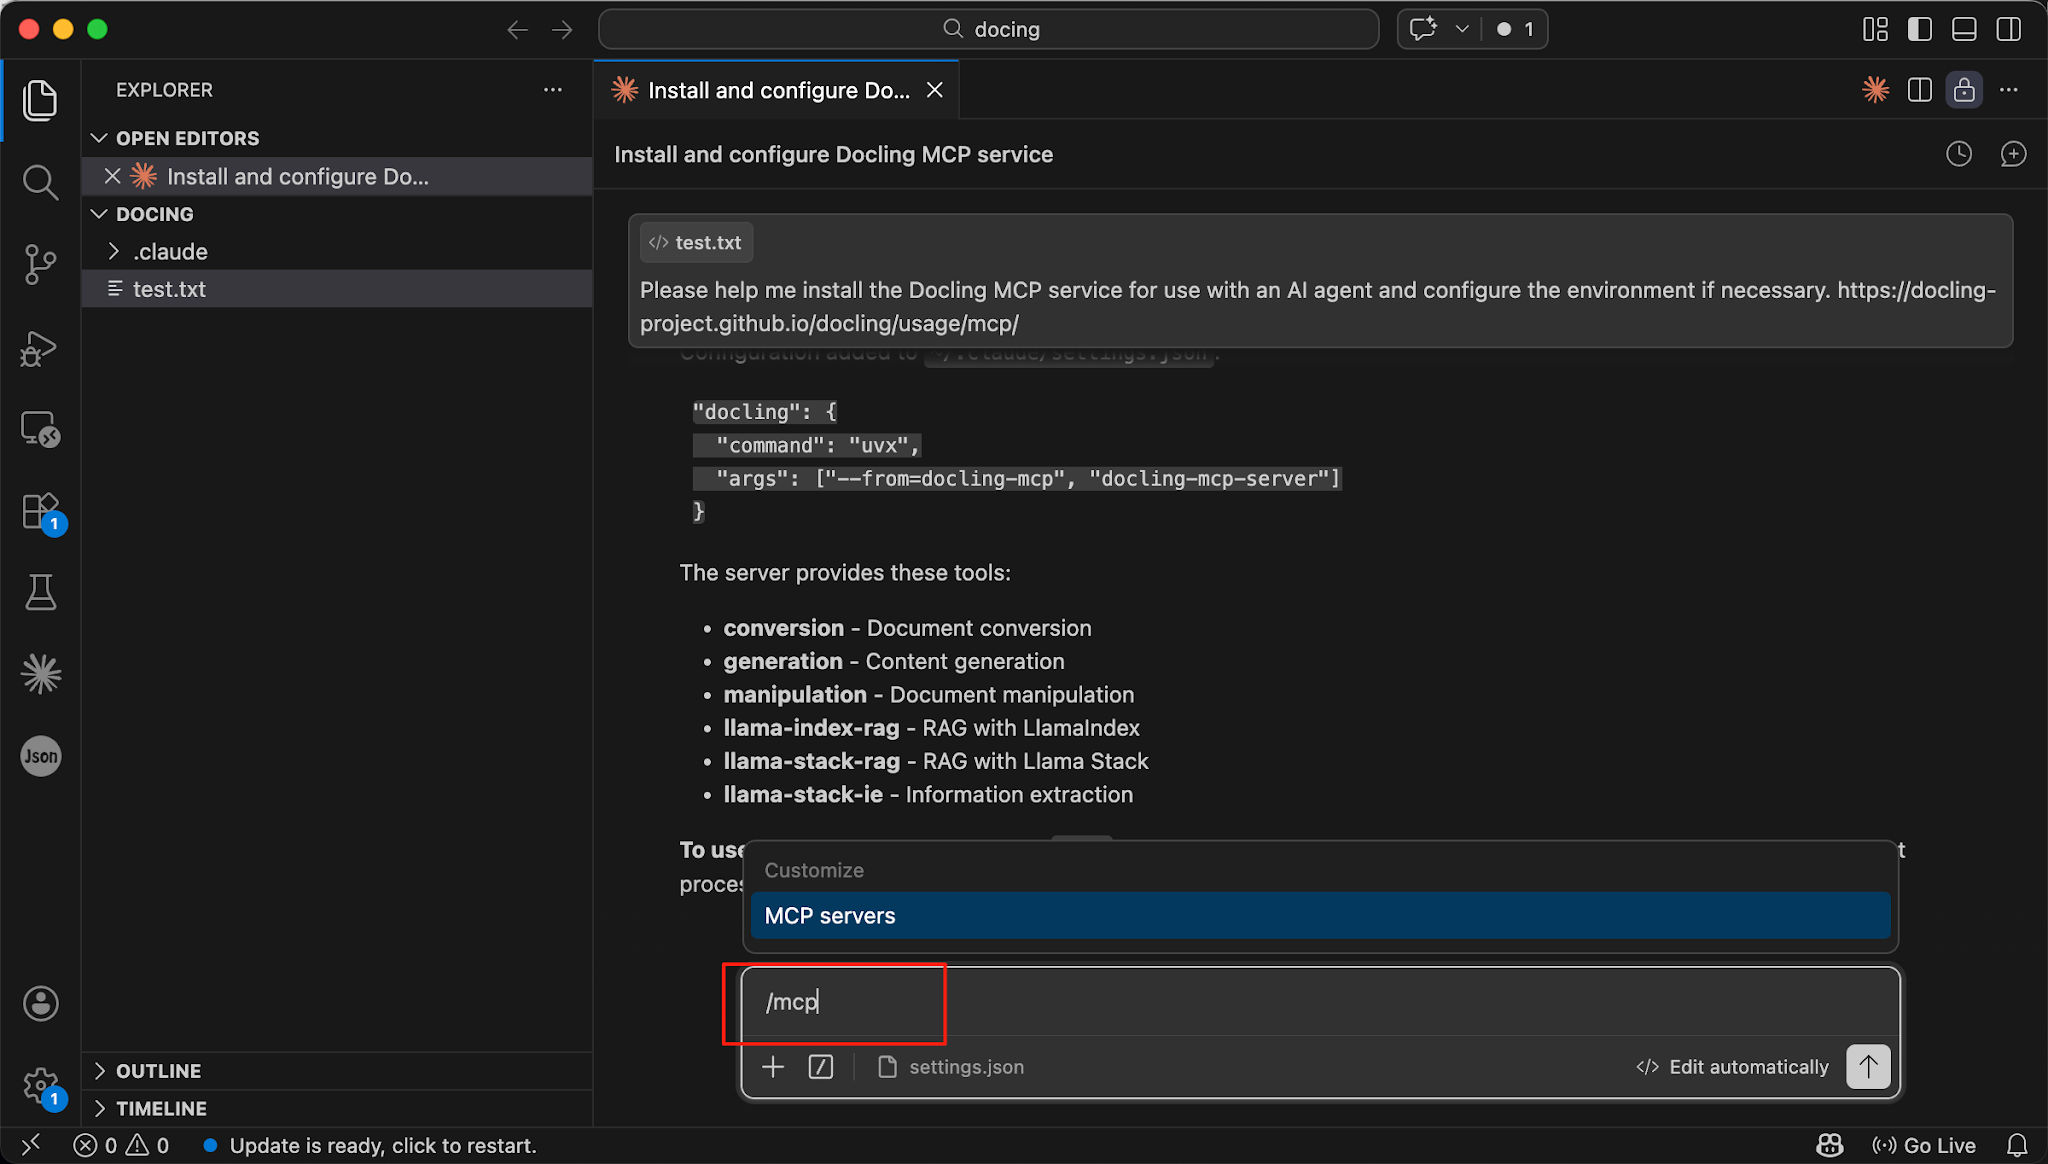
Escriba /mcp para ver la lista de servicios
Cuando docling aparece en la lista MCP y su estado es Connected (normalmente mostrado en verde), el servicio está activo y esperando una nueva solicitud.
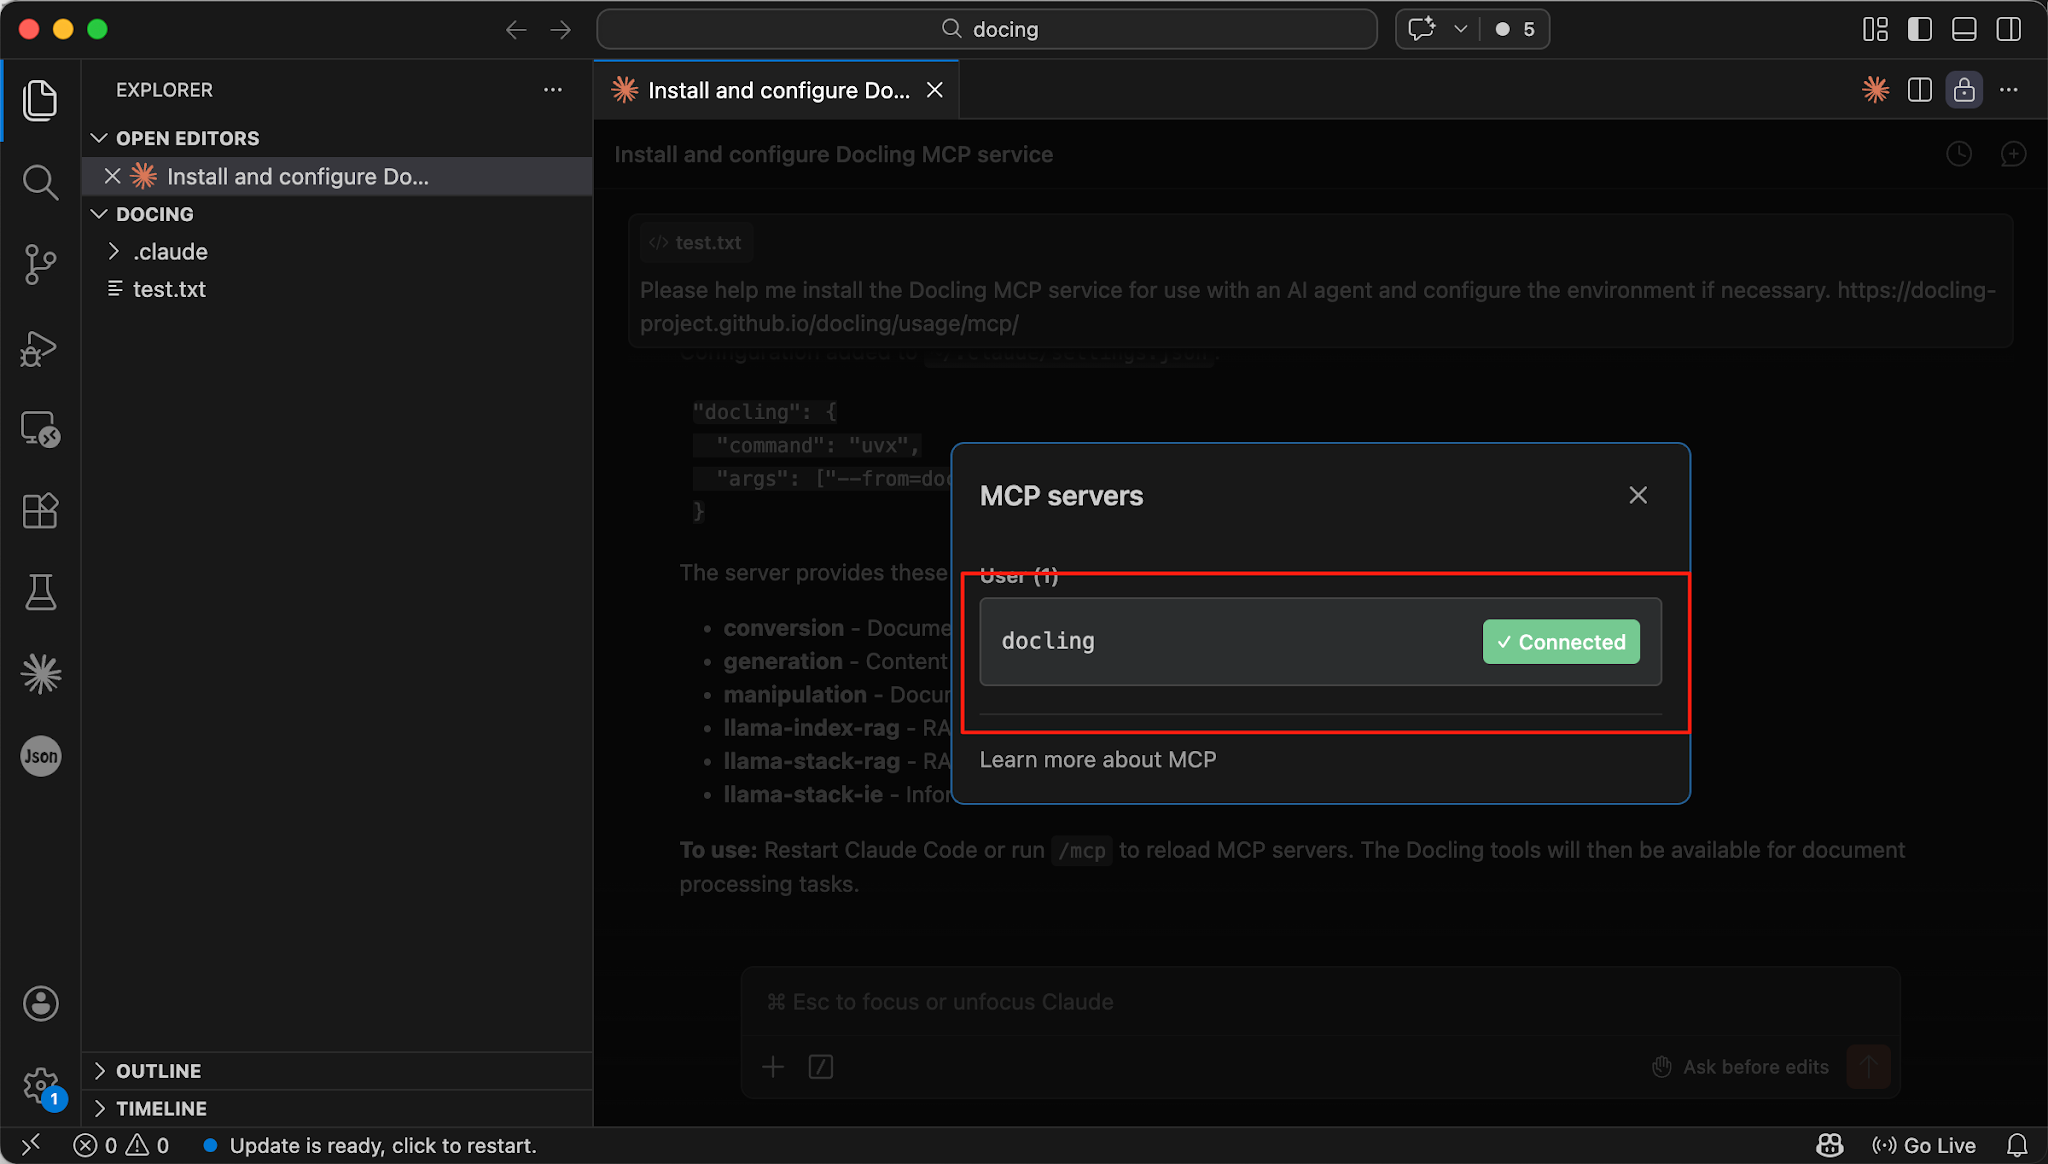
docling aparece como Connected en la lista MCP
Para probar la configuración, cargue un PDF escaneado de muestra y pregúntele al agente:
Por favor, convierte este PDF a Markdown.
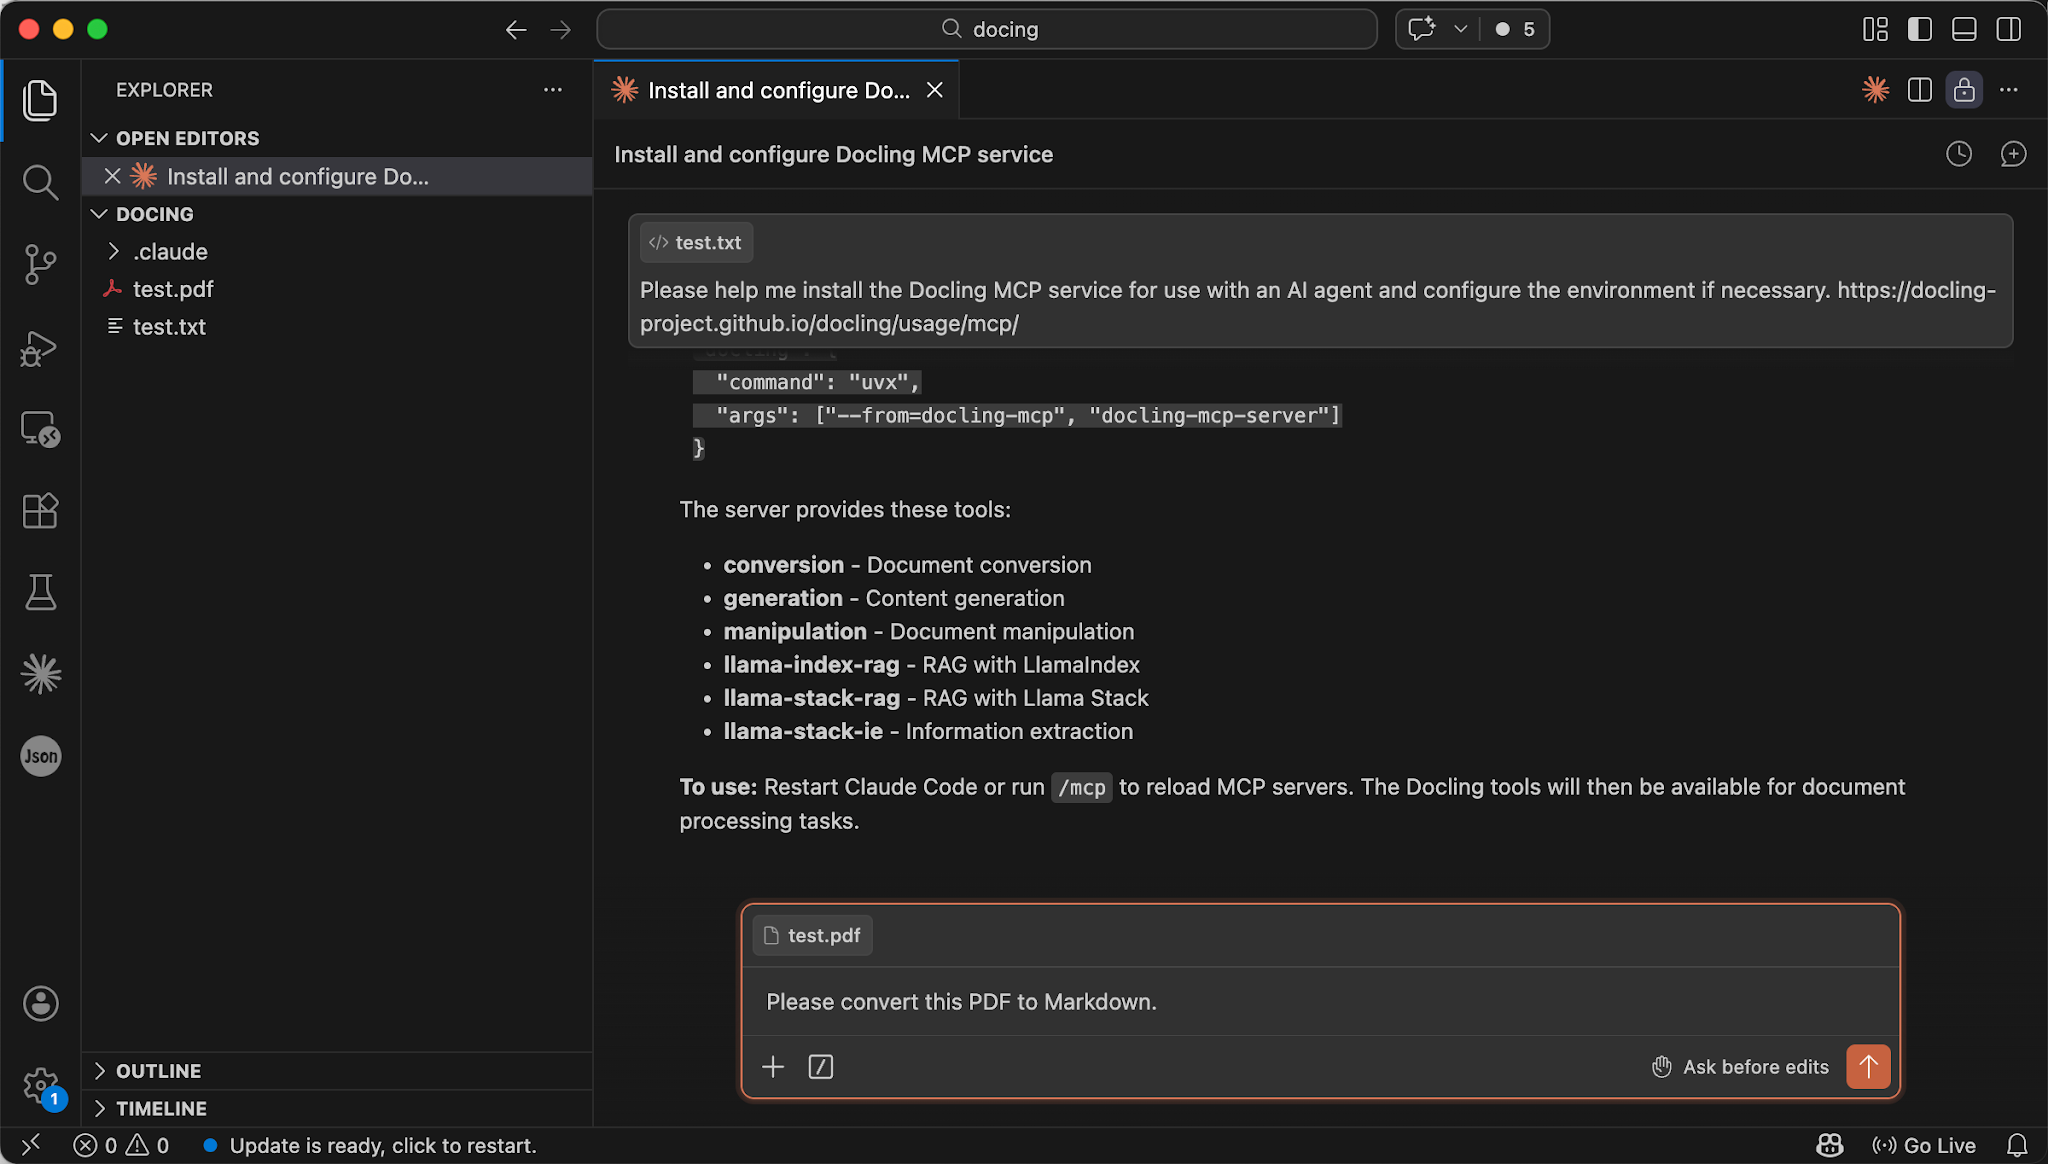
Prompt para convertir un PDF a Markdown
Una conversión exitosa devolverá un Markdown limpio y estructurado, conservando todos los encabezados, párrafos, tablas y referencias de imágenes. Esto confirma que su agente puede leer y procesar de manera fiable el contenido del PDF, lo cual es la base para tareas posteriores como el resumen, la extracción de puntos clave y la respuesta a preguntas fundamentadas en evidencias.
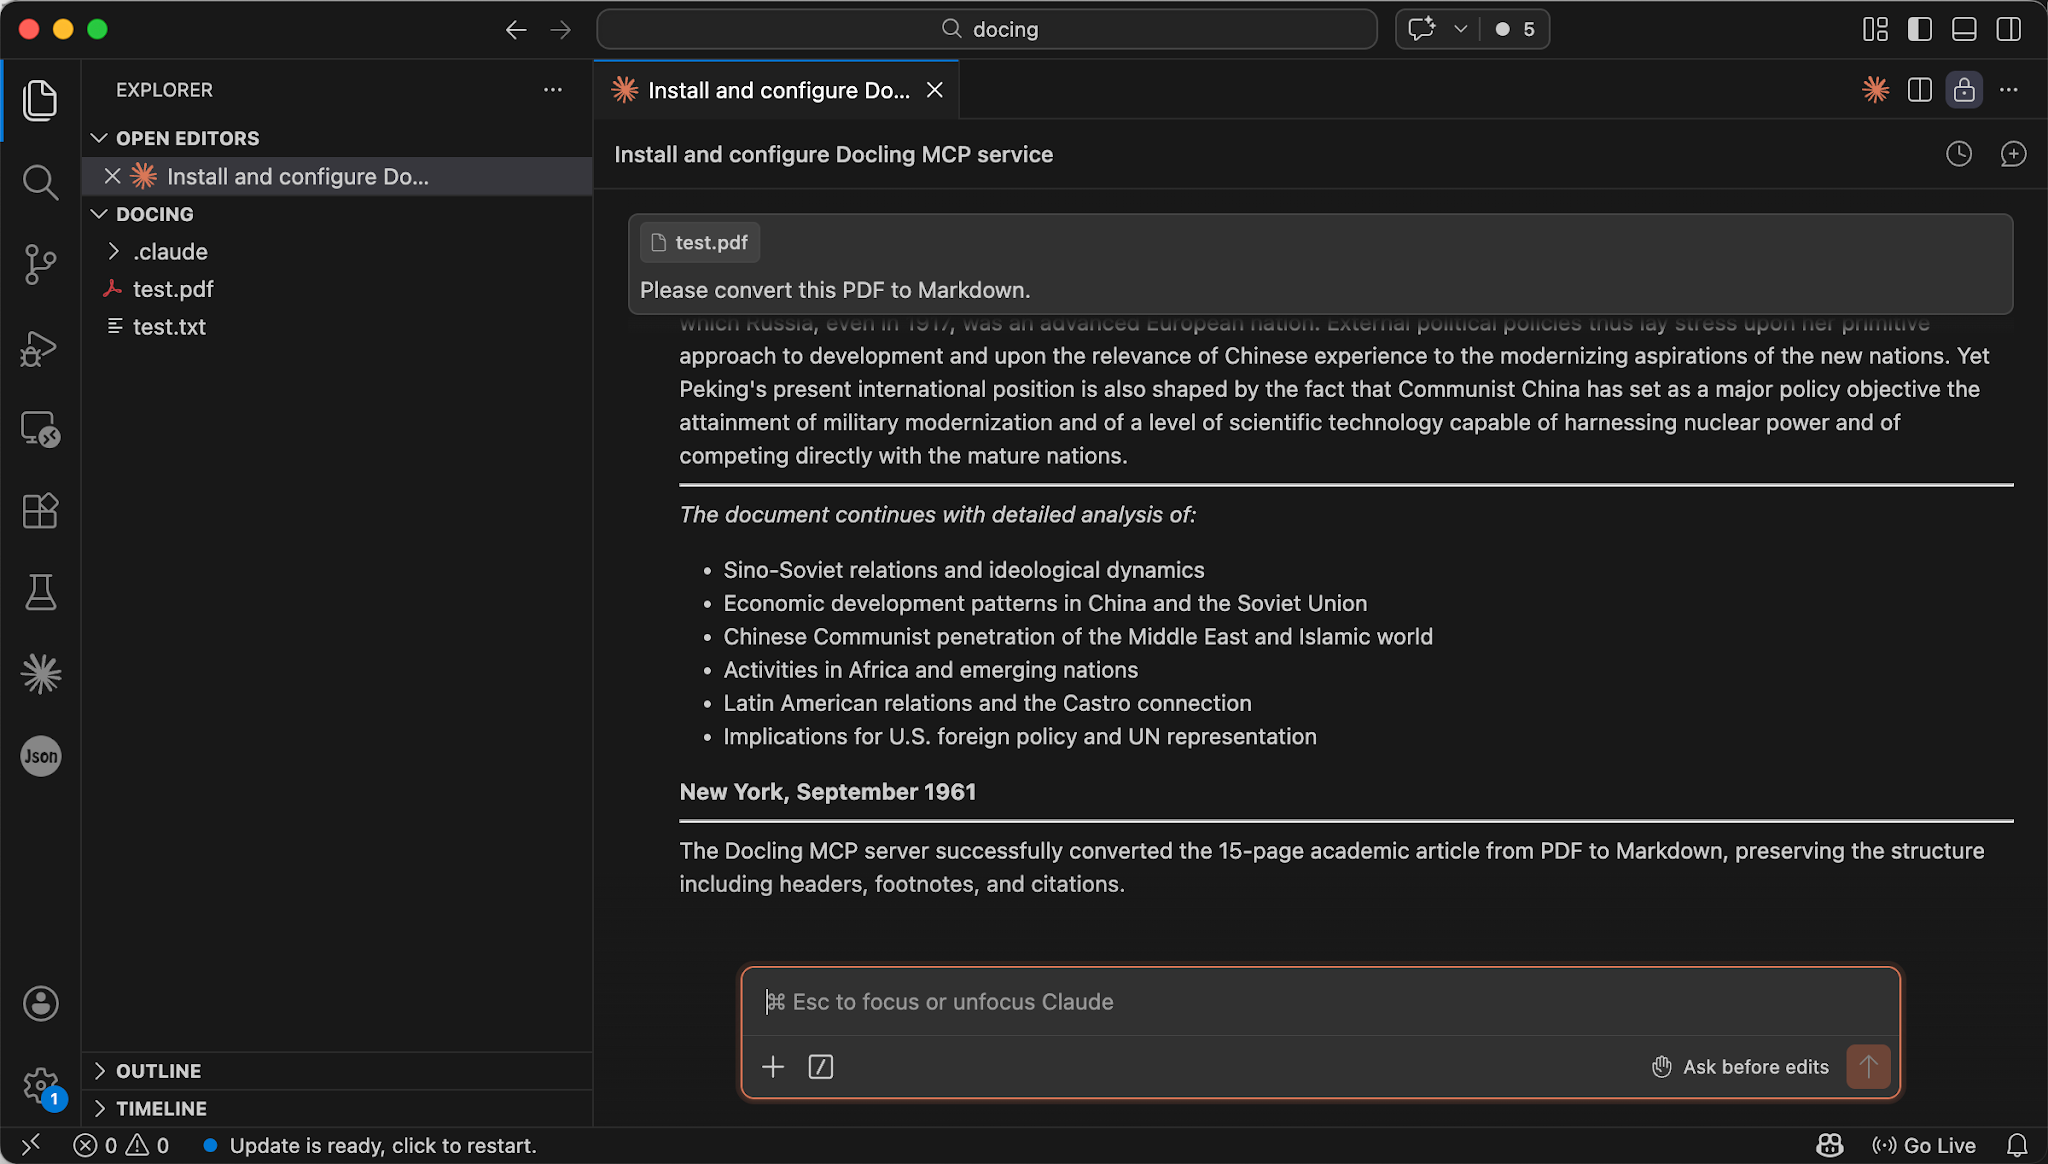
Un resultado exitoso de conversión a Markdown
Si la conversión falla o el resultado se ve desordenado, pídale al agente que revise los registros y sugiera correcciones; las soluciones comunes incluyen ajustar las dependencias del sistema o volver a escanear el PDF original a una resolución más alta.
Comprobación de la calidad del resultado
Obtener un archivo Markdown es solo la mitad del trabajo. Para trabajos de nivel de investigación, debe verificar que el resultado represente fielmente el documento original. Dedique unos minutos a examinar una muestra representativa y preste mucha atención a los siguientes puntos:
- Integridad de los párrafos y orden de lectura, compruebe que los párrafos clave estén completos y aparezcan en la misma secuencia lógica que en el PDF. Los diseños de múltiples columnas a veces confunden a los motores de OCR, así que busque fragmentos de texto que puedan haber sido desordenados.
- Fidelidad de las tablas, confirme que las tablas estén identificadas y que se conserve su estructura de filas y columnas. Una tabla renderizada como una simple cadena plana de números es casi inútil para el análisis posterior.
- Fórmulas matemáticas y caracteres especiales, los símbolos, las letras griegas y las ecuaciones en bloque son propensos a errores. Verifique que se hayan convertido con precisión y que no estén deformados ni omitidos.
- Encabezados y pies de página, asegúrese de que los encabezados corrientes, los números de página y las notas al pie no se fusionen incorrectamente con el texto principal, lo que contaminaría el contenido extraído.
Para documentos especialmente importantes, lo más seguro es cotejar el resultado de Markdown con el PDF original página por página. Si detecta problemas sistemáticos, como fuentes no reconocidas o tablas consistentemente rotas, intente volver a escanear el documento a un DPI más alto o elegir un formato de exportación diferente antes de enviarlo a Docling. Los pequeños ajustes en la entrada a menudo producen resultados drásticamente mejores.
Resumen
Docling transforma el contenido escaneado y bloqueado en Markdown estructurado y legible por máquinas, cerrando la brecha entre los documentos estáticos y la investigación fundamentada en IA. Con soporte nativo para PDF, DOCX, PPT, XLSX, HTML, PNG, JPEG, TIFF, LaTeX, texto plano, WAV, MP3 y WebVTT, elimina el caos de formatos que típicamente ralentizan los proyectos con gran volumen de documentos. Una vez que el servicio MCP está instalado y verificado, simplemente puede describir cualquier tarea de conversión o análisis a su agente y dejar que este se encargue del resto.
Cuando se combina con la Generación Aumentada por Recuperación (RAG) o la construcción de gráficos de conocimiento, el texto limpio que produce Docling se convierte en contenido fiable para respuestas basadas en evidencias. En lugar de adivinar lo que podría decir un artículo escaneado, su IA tiene el texto real, y eso marca toda la diferencia entre el ruido plausible y el conocimiento confiable.