Cómo realizar una investigación fundamentada: búsqueda y recuperación de contenido web
Para proyectos sencillos, suele bastar con recopilar fuentes manualmente y redactar preguntas de investigación. Cuando se necesita una investigación exhaustiva que abarque decenas o cientos de artículos, las limitaciones de la búsqueda y la descarga manuales se hacen evidentes.
Este artículo enmarca la investigación fundamentada en torno a dos acciones complementarias: la búsqueda en la web (descubrir de forma programática lo que existe en la web abierta y en los índices académicos) y la recuperación de contenido web (recuperar documentos completos o representaciones legibles por máquina a través de interfaces documentadas que tú controlas). Si se utiliza de acuerdo con los términos de servicio y los límites de uso de cada proveedor, esta combinación agiliza la recopilación y reduce el riesgo de “alucinaciones”, al vincular los resultados del modelo a fuentes que pueden verificarse.
Búsqueda en la web y recuperación de contenido web
Los motores de búsqueda tradicionales devuelven enlaces y fragmentos breves. Los humanos pueden seguir esos enlaces uno por uno; los flujos de trabajo a gran escala o impulsados por agentes suelen necesitar resultados de búsqueda estructurados, campos que se puedan analizar, filtrar y pasar al siguiente paso.
En este contexto, la búsqueda en la web consiste en utilizar unas API de búsqueda para que el agente obtenga datos normalizados (títulos, URL, fragmentos, posiciones en los resultados y similares) en lugar de código HTML renderizado.
El JSON que se muestra a continuación es un ejemplo sencillo de cómo puede ser un resultado de búsqueda estructurado:
[
{
    "title": "Google",
    "link": "https://google.com/",
    "snippet": "Busca información de todo el mundo, incluyendo páginas web, imágenes, vídeos y mucho más. _Google_ cuenta con numerosas funciones especiales para ayudarte a encontrar exactamente lo que buscas...",
    "position": 1
},

{
    "title": "Google Académico",
    "link": "https://scholar.google.com",
    "snippet": "_Google Scholar_ ofrece una forma sencilla de realizar búsquedas amplias de bibliografía académica. Realiza búsquedas en una amplia variedad de disciplinas y fuentes: artículos, tesis, ...",
    "position": 2
}
]
La recuperación de contenido web es el siguiente paso: conseguir el texto completo o el contenido depurado de una página, un PDF o una extracción en formato similar a Markdown de una página que se te permita procesar, de modo que el modelo pueda trabajar a partir de argumentos completos, y no solo de vistas previas.
En conjunto, la búsqueda estructurada y la recuperación disciplinada forman un proceso que va desde la consulta hasta la evidencia, la columna vertebral práctica de la investigación fundamentada.
Por qué son importantes estas capacidades
Los modelos generativos producen alucinaciones cuando el contexto es escaso o incorrecto. Alimentarlos con material recuperado y verificable, metadatos, resúmenes, archivos PDF o extractos de canales autorizados, permite anclar las respuestas a fuentes reales.
Para proyectos de investigación completos, la búsqueda y la recuperación programáticas resultan útiles porque ofrecen:
- Trazabilidad: URL, identificadores o datos de solicitudes a API que pueden registrarse y volverse a consultar.
- Un contexto más rico: el texto completo o las extracciones depuradas superan a los simples fragmentos cuando los matices son importantes.
- Actualidad: muchas API académicas y web muestran registros más recientes que el límite de entrenamiento estático de un modelo.
A continuación se repasan herramientas a las que puedes conectarte mediante claves de API y documentación publicada, además de algunas ayudas interactivas cuyo valor radica en la exploración más que en la automatización.
Búsqueda en la web
Las secciones siguientes explican cómo descubrir candidatos, artículos, páginas y conjuntos de datos antes de ir a la recuperación completa.
1. Serper.dev
Serper.dev pertenece a la misma familia general que otras API de tipo SERP: se envía una solicitud HTTP con una consulta y las credenciales, y se recibe un JSON estructurado en lugar de tener que navegar por una página de resultados. Los motores, parámetros y límites de uso se definen en la documentación de Serper; el flujo de trabajo diario resultará familiar si ya has utilizado productos del estilo de SerpApi.
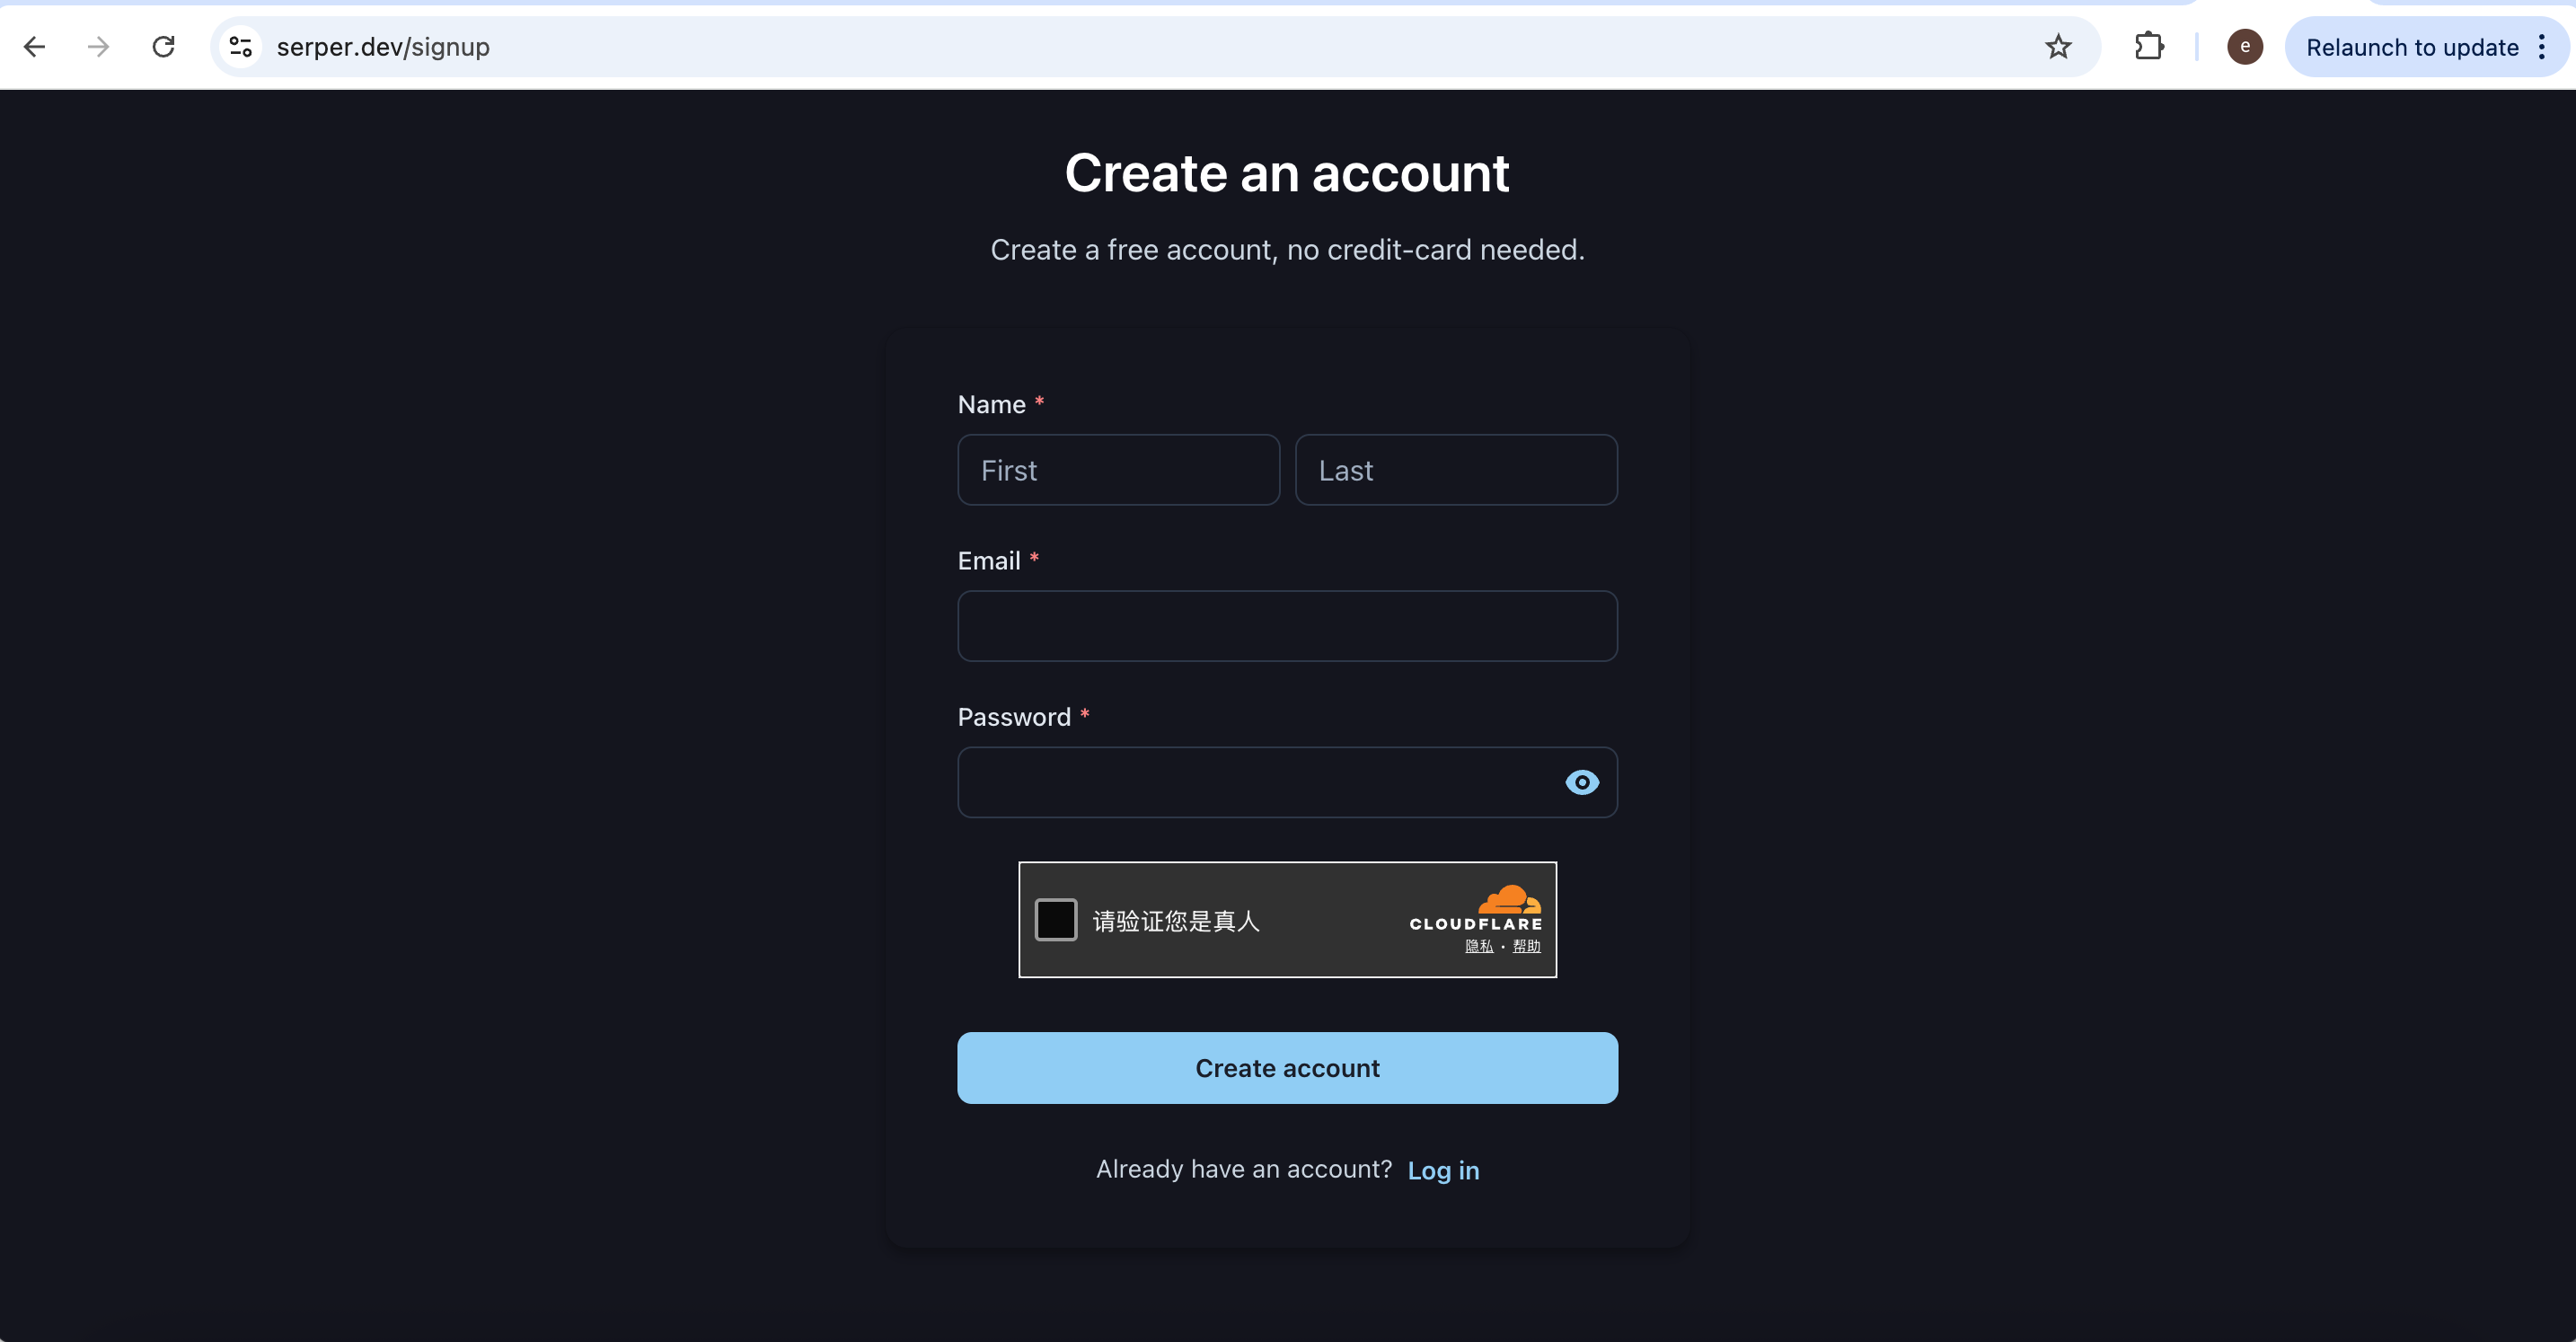
Empieza por crear una cuenta: https://serper.dev/signup.
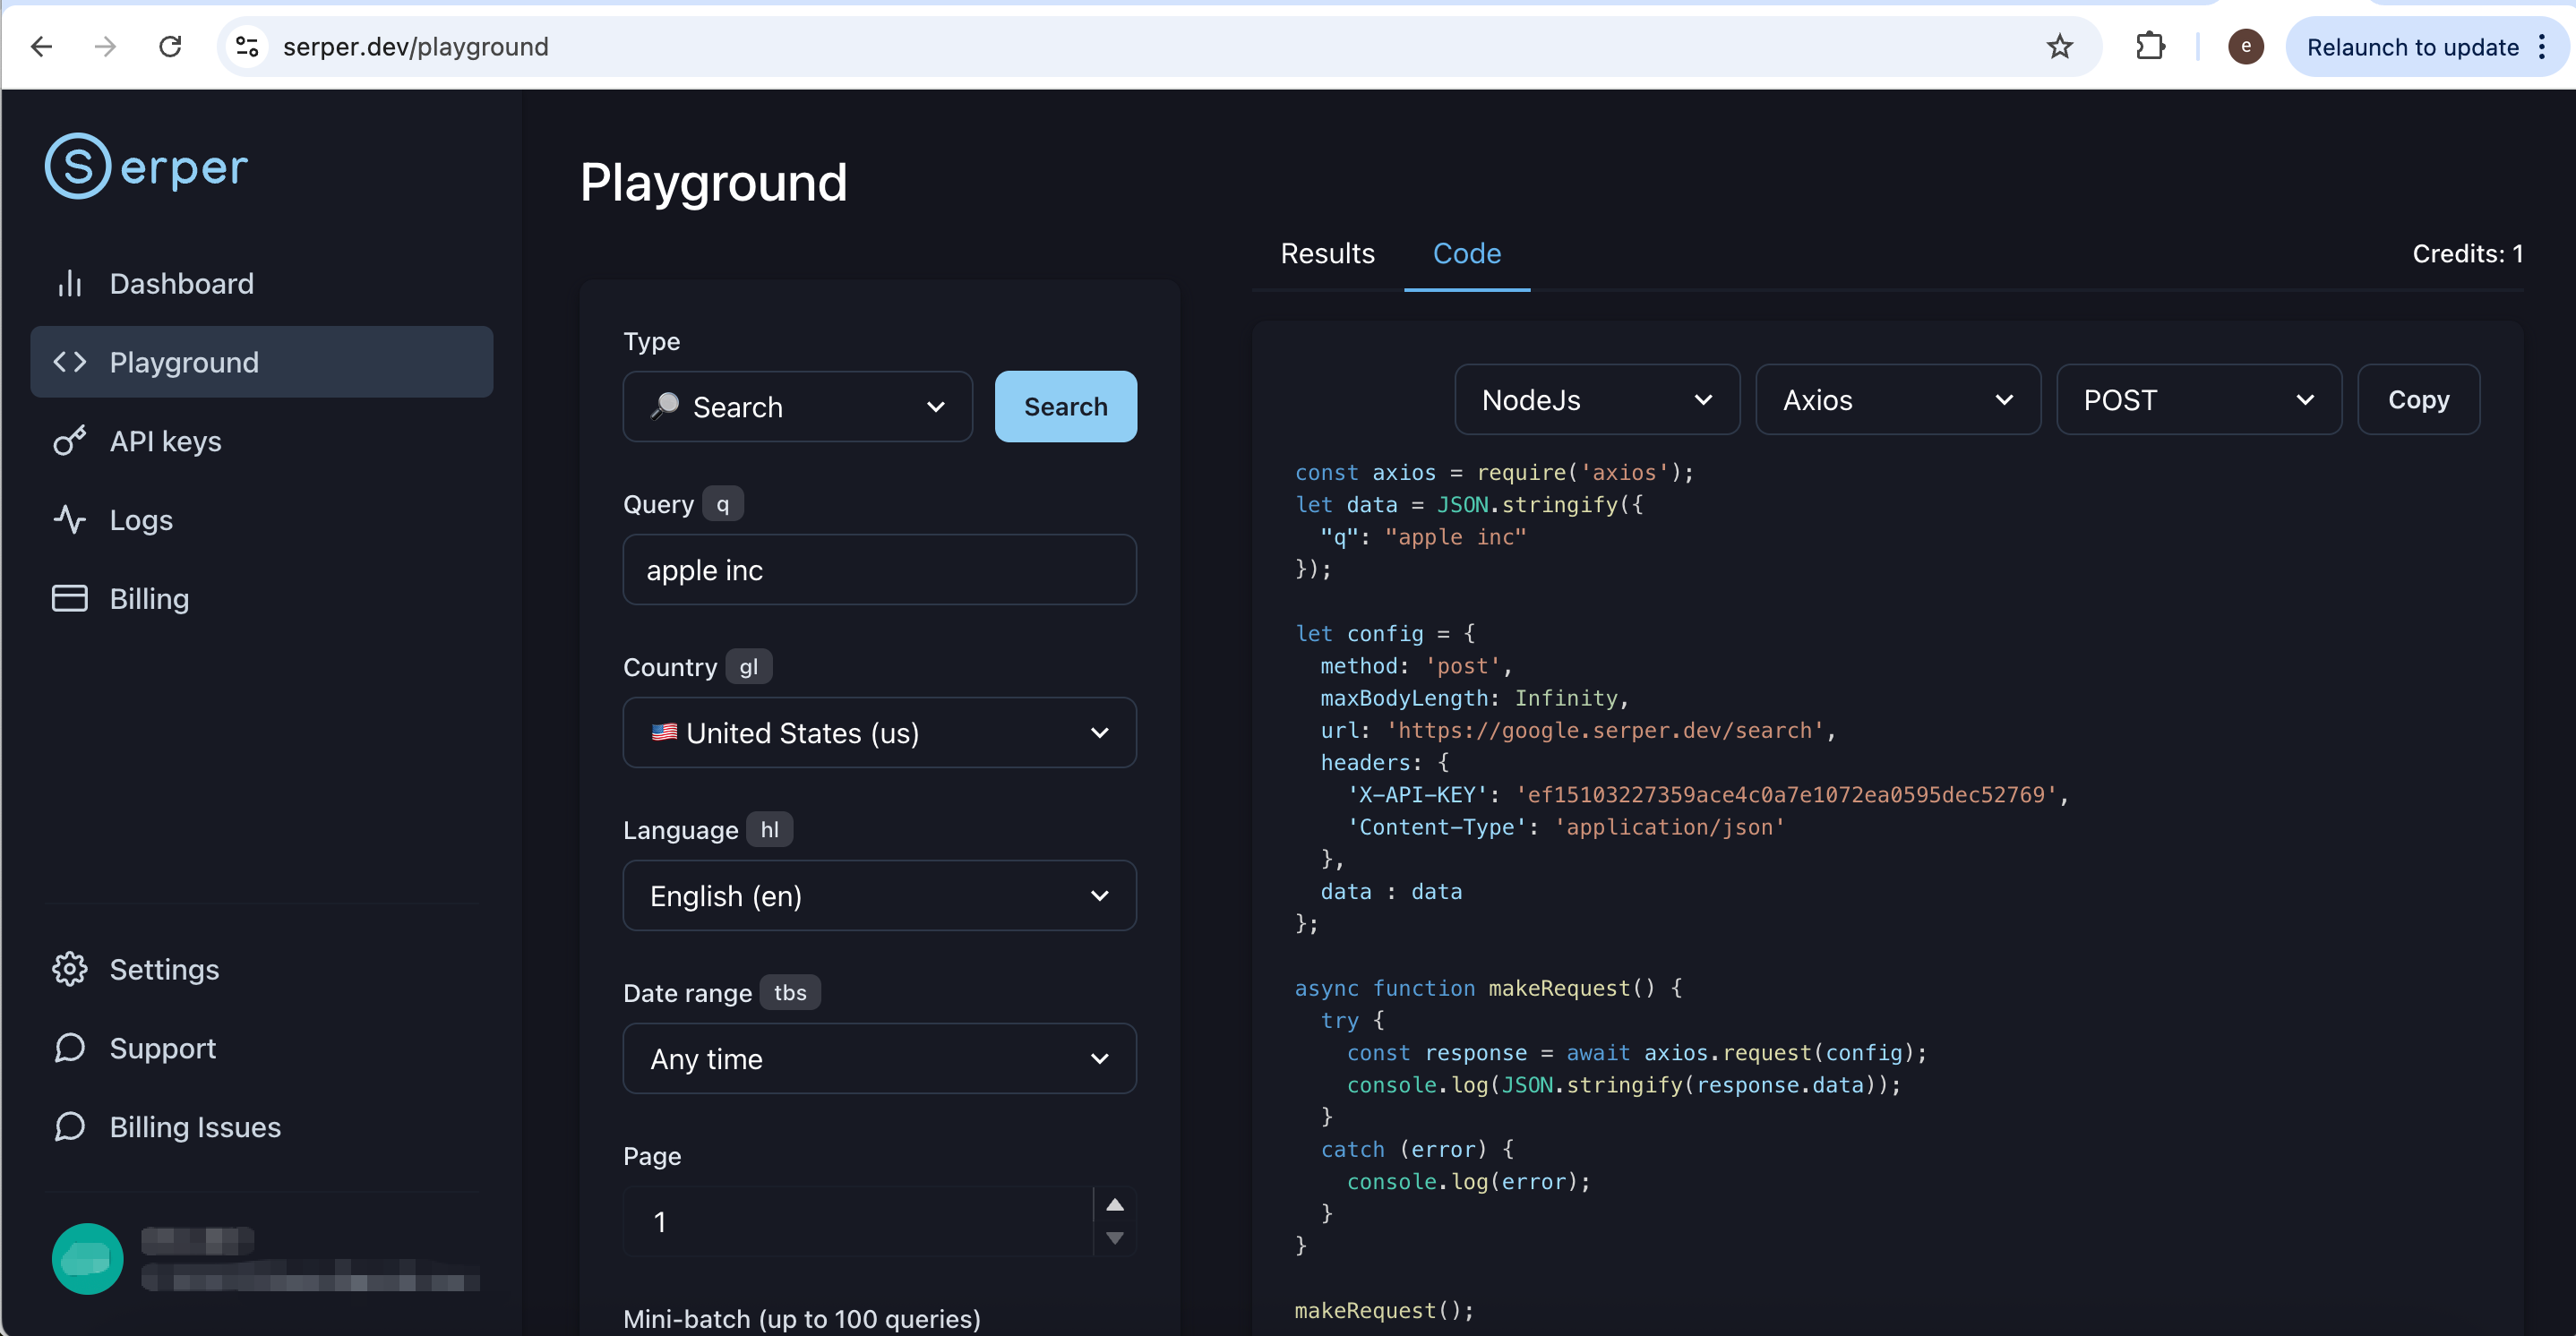
Una vez verificado tu correo electrónico, la página suele redirigirte al entorno de pruebas en https://serper.dev/playground. Allí puedes consultar el uso reciente y probar consultas de forma interactiva.
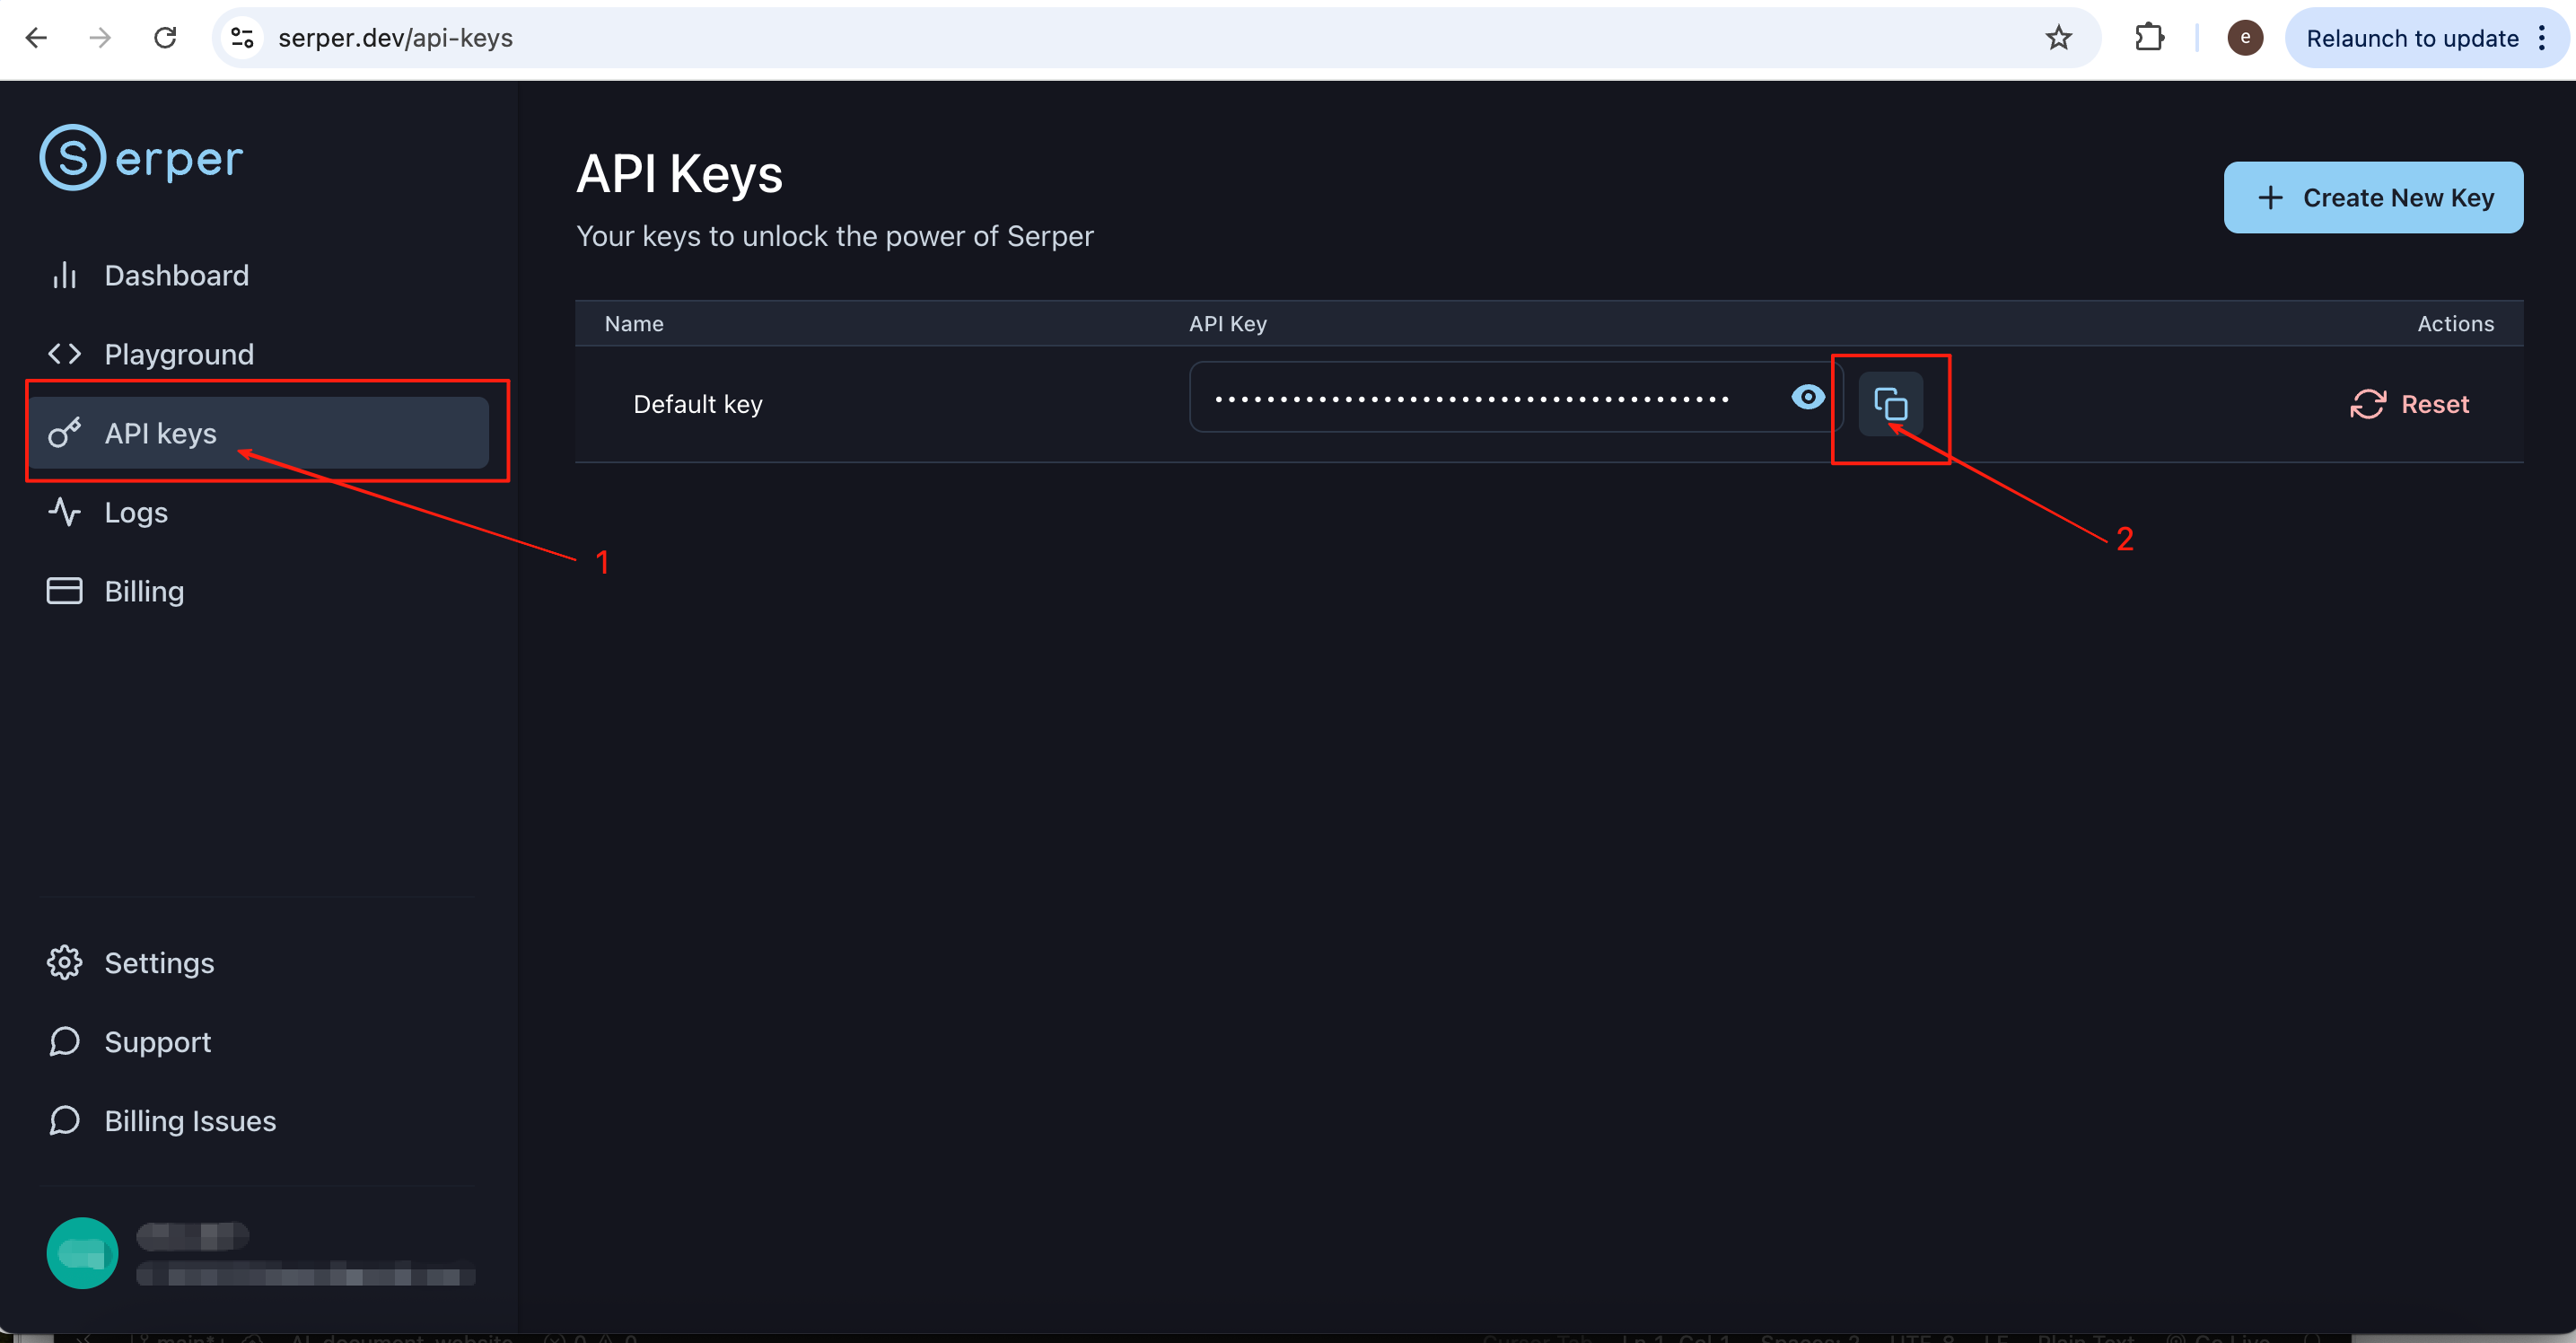
Para usar la API desde código o desde un agente, abre la pestaña “API Keys” en la barra lateral izquierda. Normalmente se genera una clave automáticamente; cópiala y guárdala de forma segura (por ejemplo, en una variable de entorno).
Para realizar búsquedas en Google a través de Serper, sigue el método HTTP, los encabezados y el formato del cuerpo que se indican en la documentación oficial cuando uses la API desde el código o desde un agente. Para una comprobación rápida, a veces puedes abrir una URL mínima en el navegador (sustituye {palabras de búsqueda} y {tu clave de API}):
https://google.serper.dev/search?q={palabras de búsqueda}&apiKey={tu clave de API}La respuesta es un JSON, no una página de resultados HTML de tipo consumidor, exactamente lo que esperan los clientes programáticos.
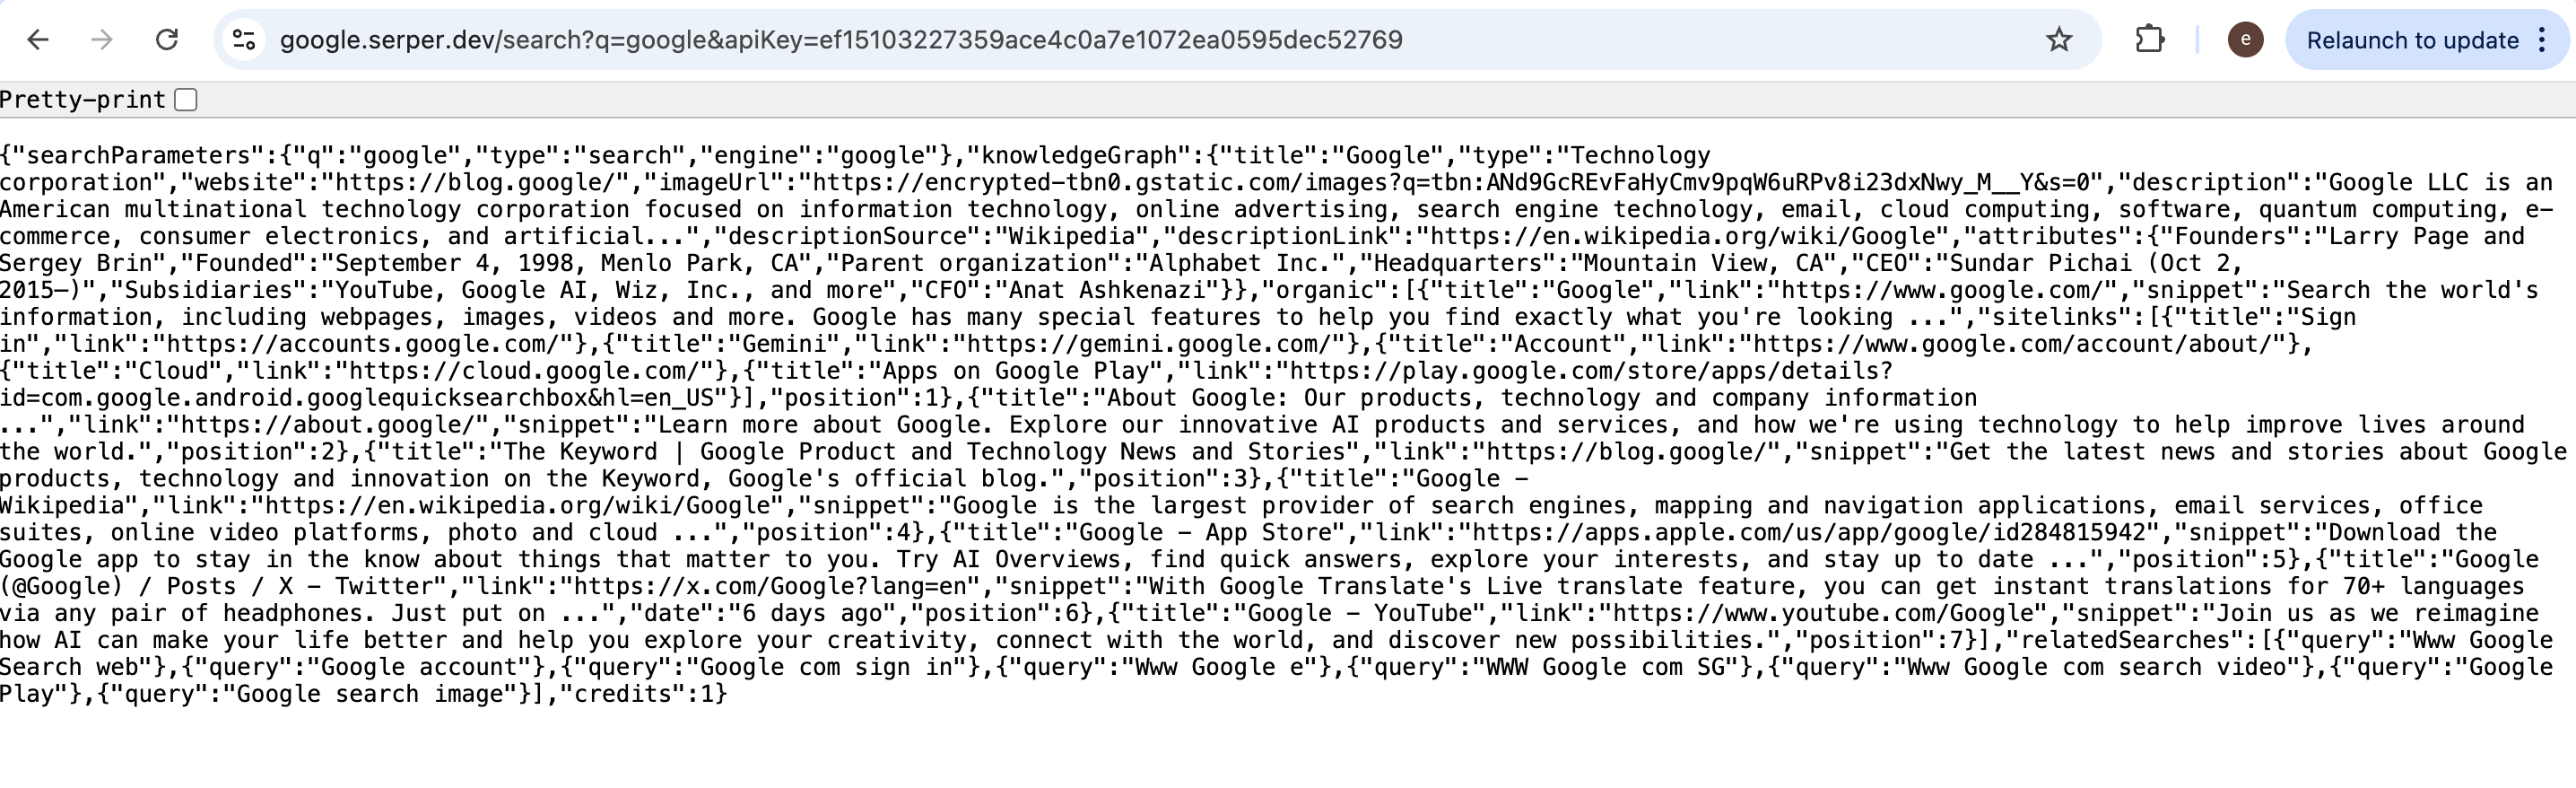
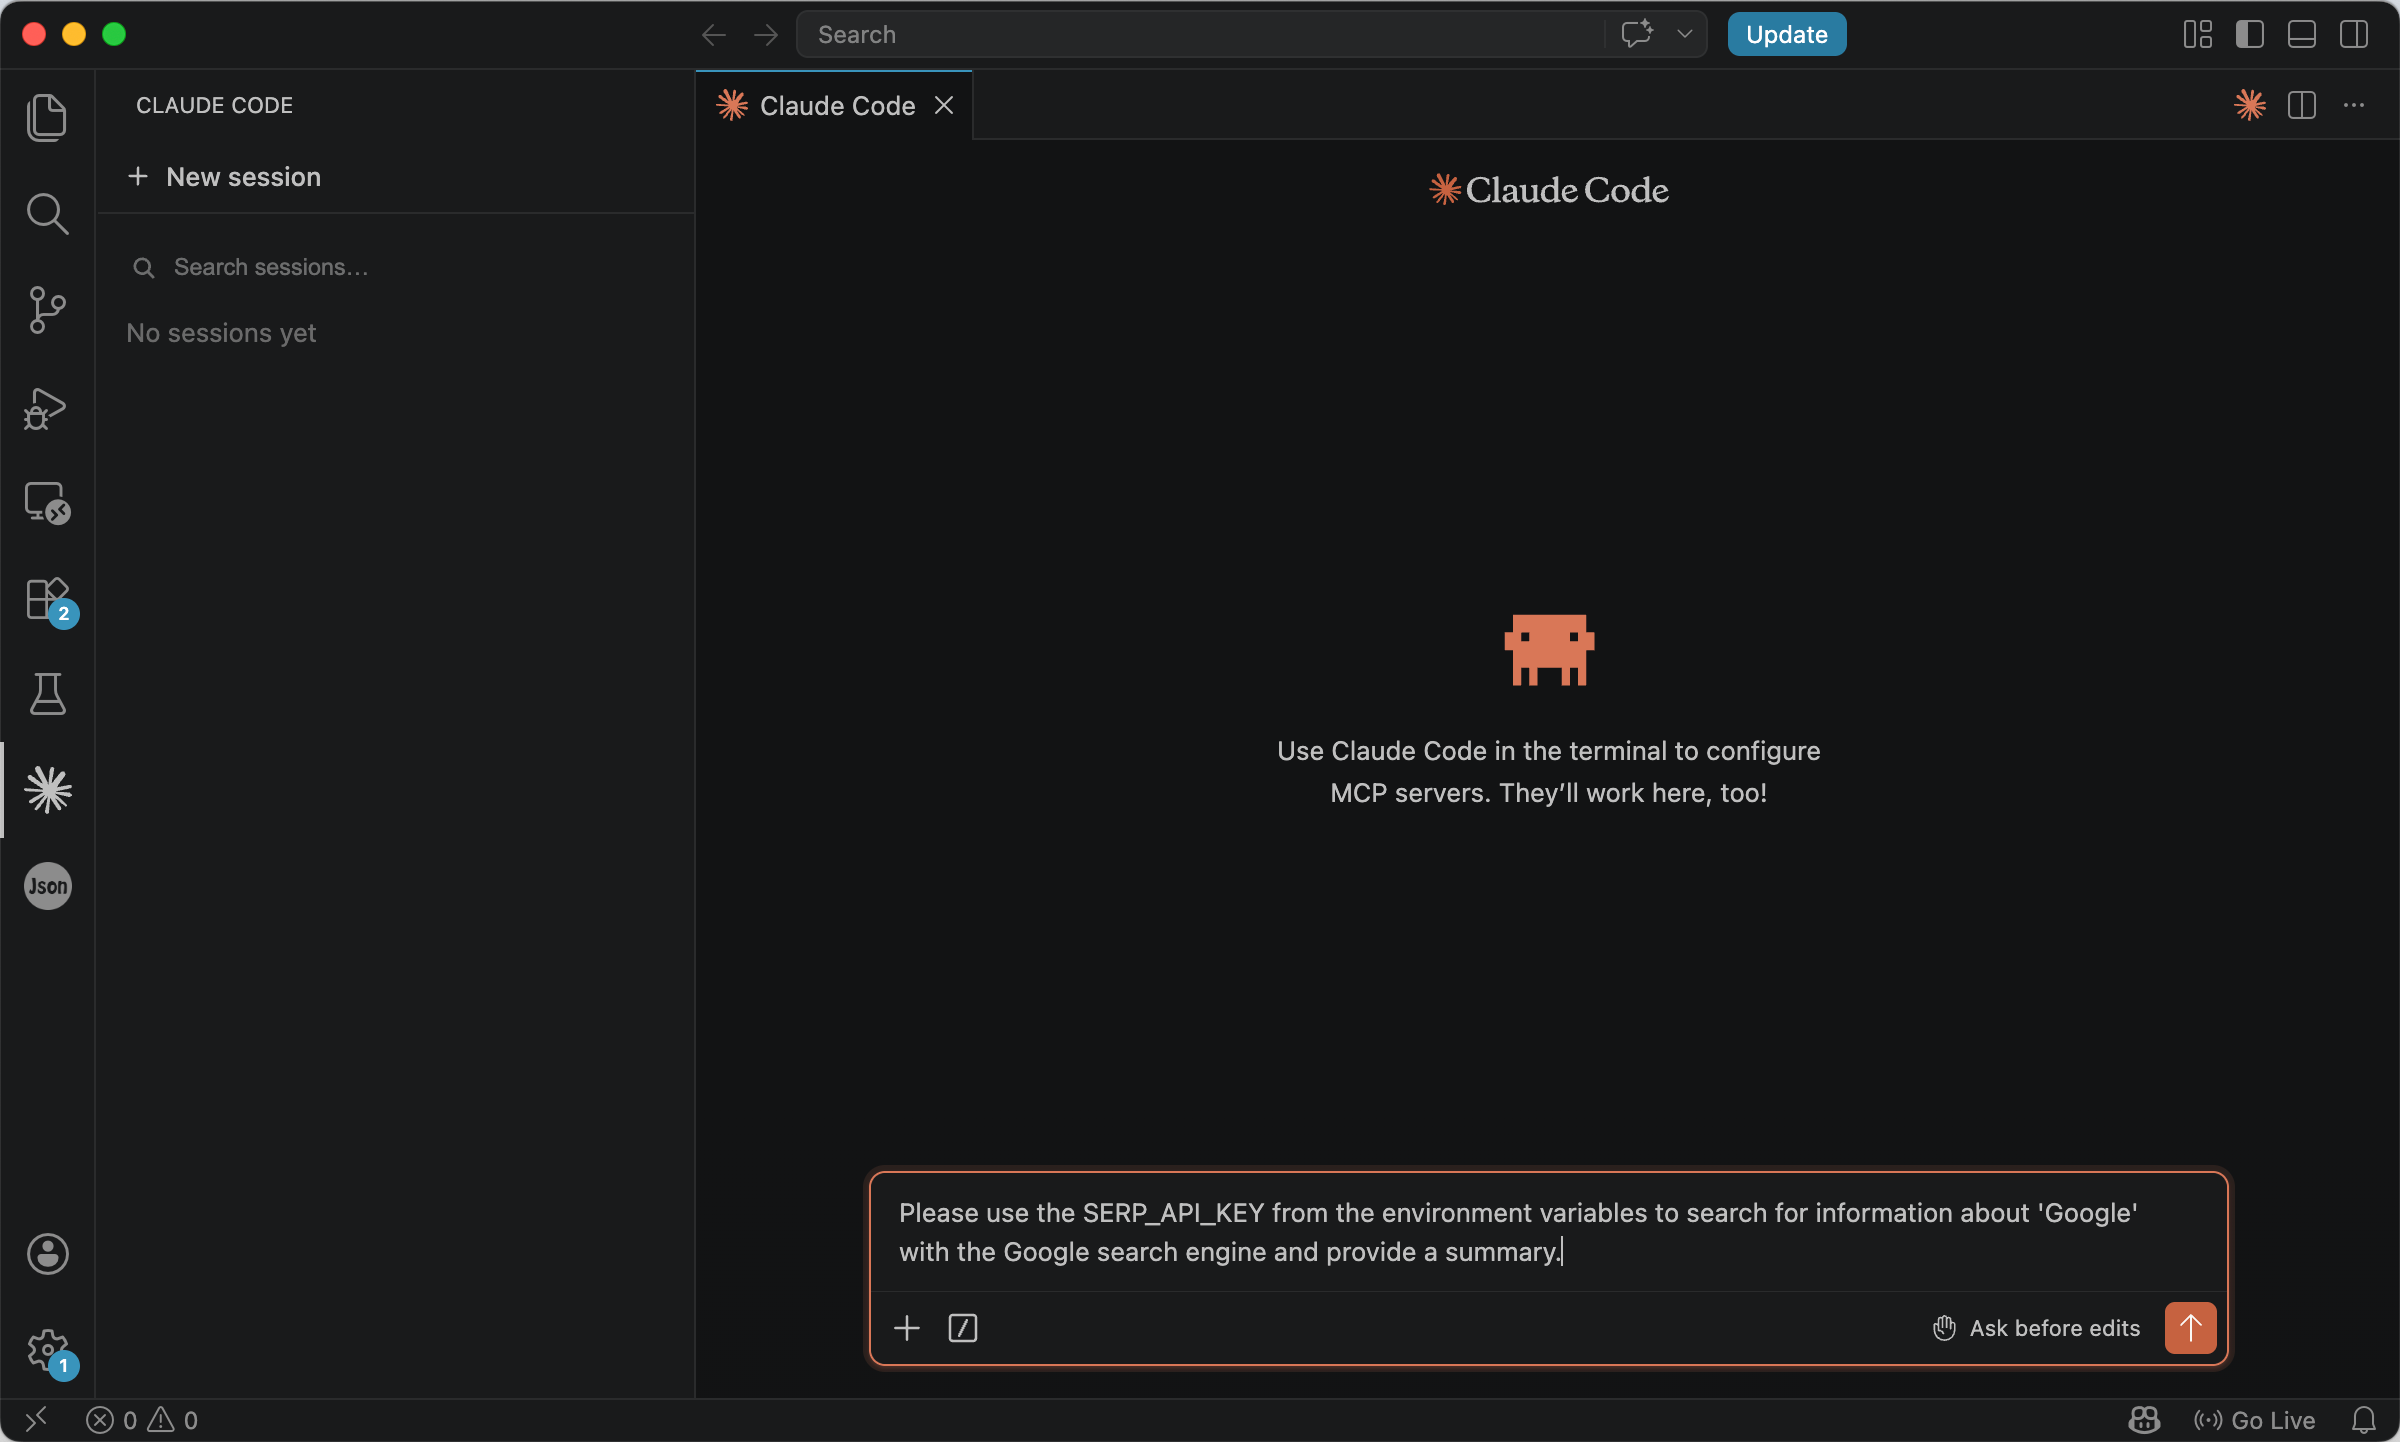
En tu agente, guarda la clave bajo un nombre como SERP_DEV_API_KEY y haz referencia a ella desde tus prompts en lugar de codificarla de forma fija. Por ejemplo:
Utiliza SERP_DEV_API_KEY de las variables de entorno para buscar información sobre «Google» con el motor de búsqueda de Google y proporciona un resumen. El formato de la API es:
https://google.serper.dev/search?q={palabras de búsqueda}&apiKey={tu clave de API}A continuación, el agente puede llamar al endpoint y resumir el JSON.
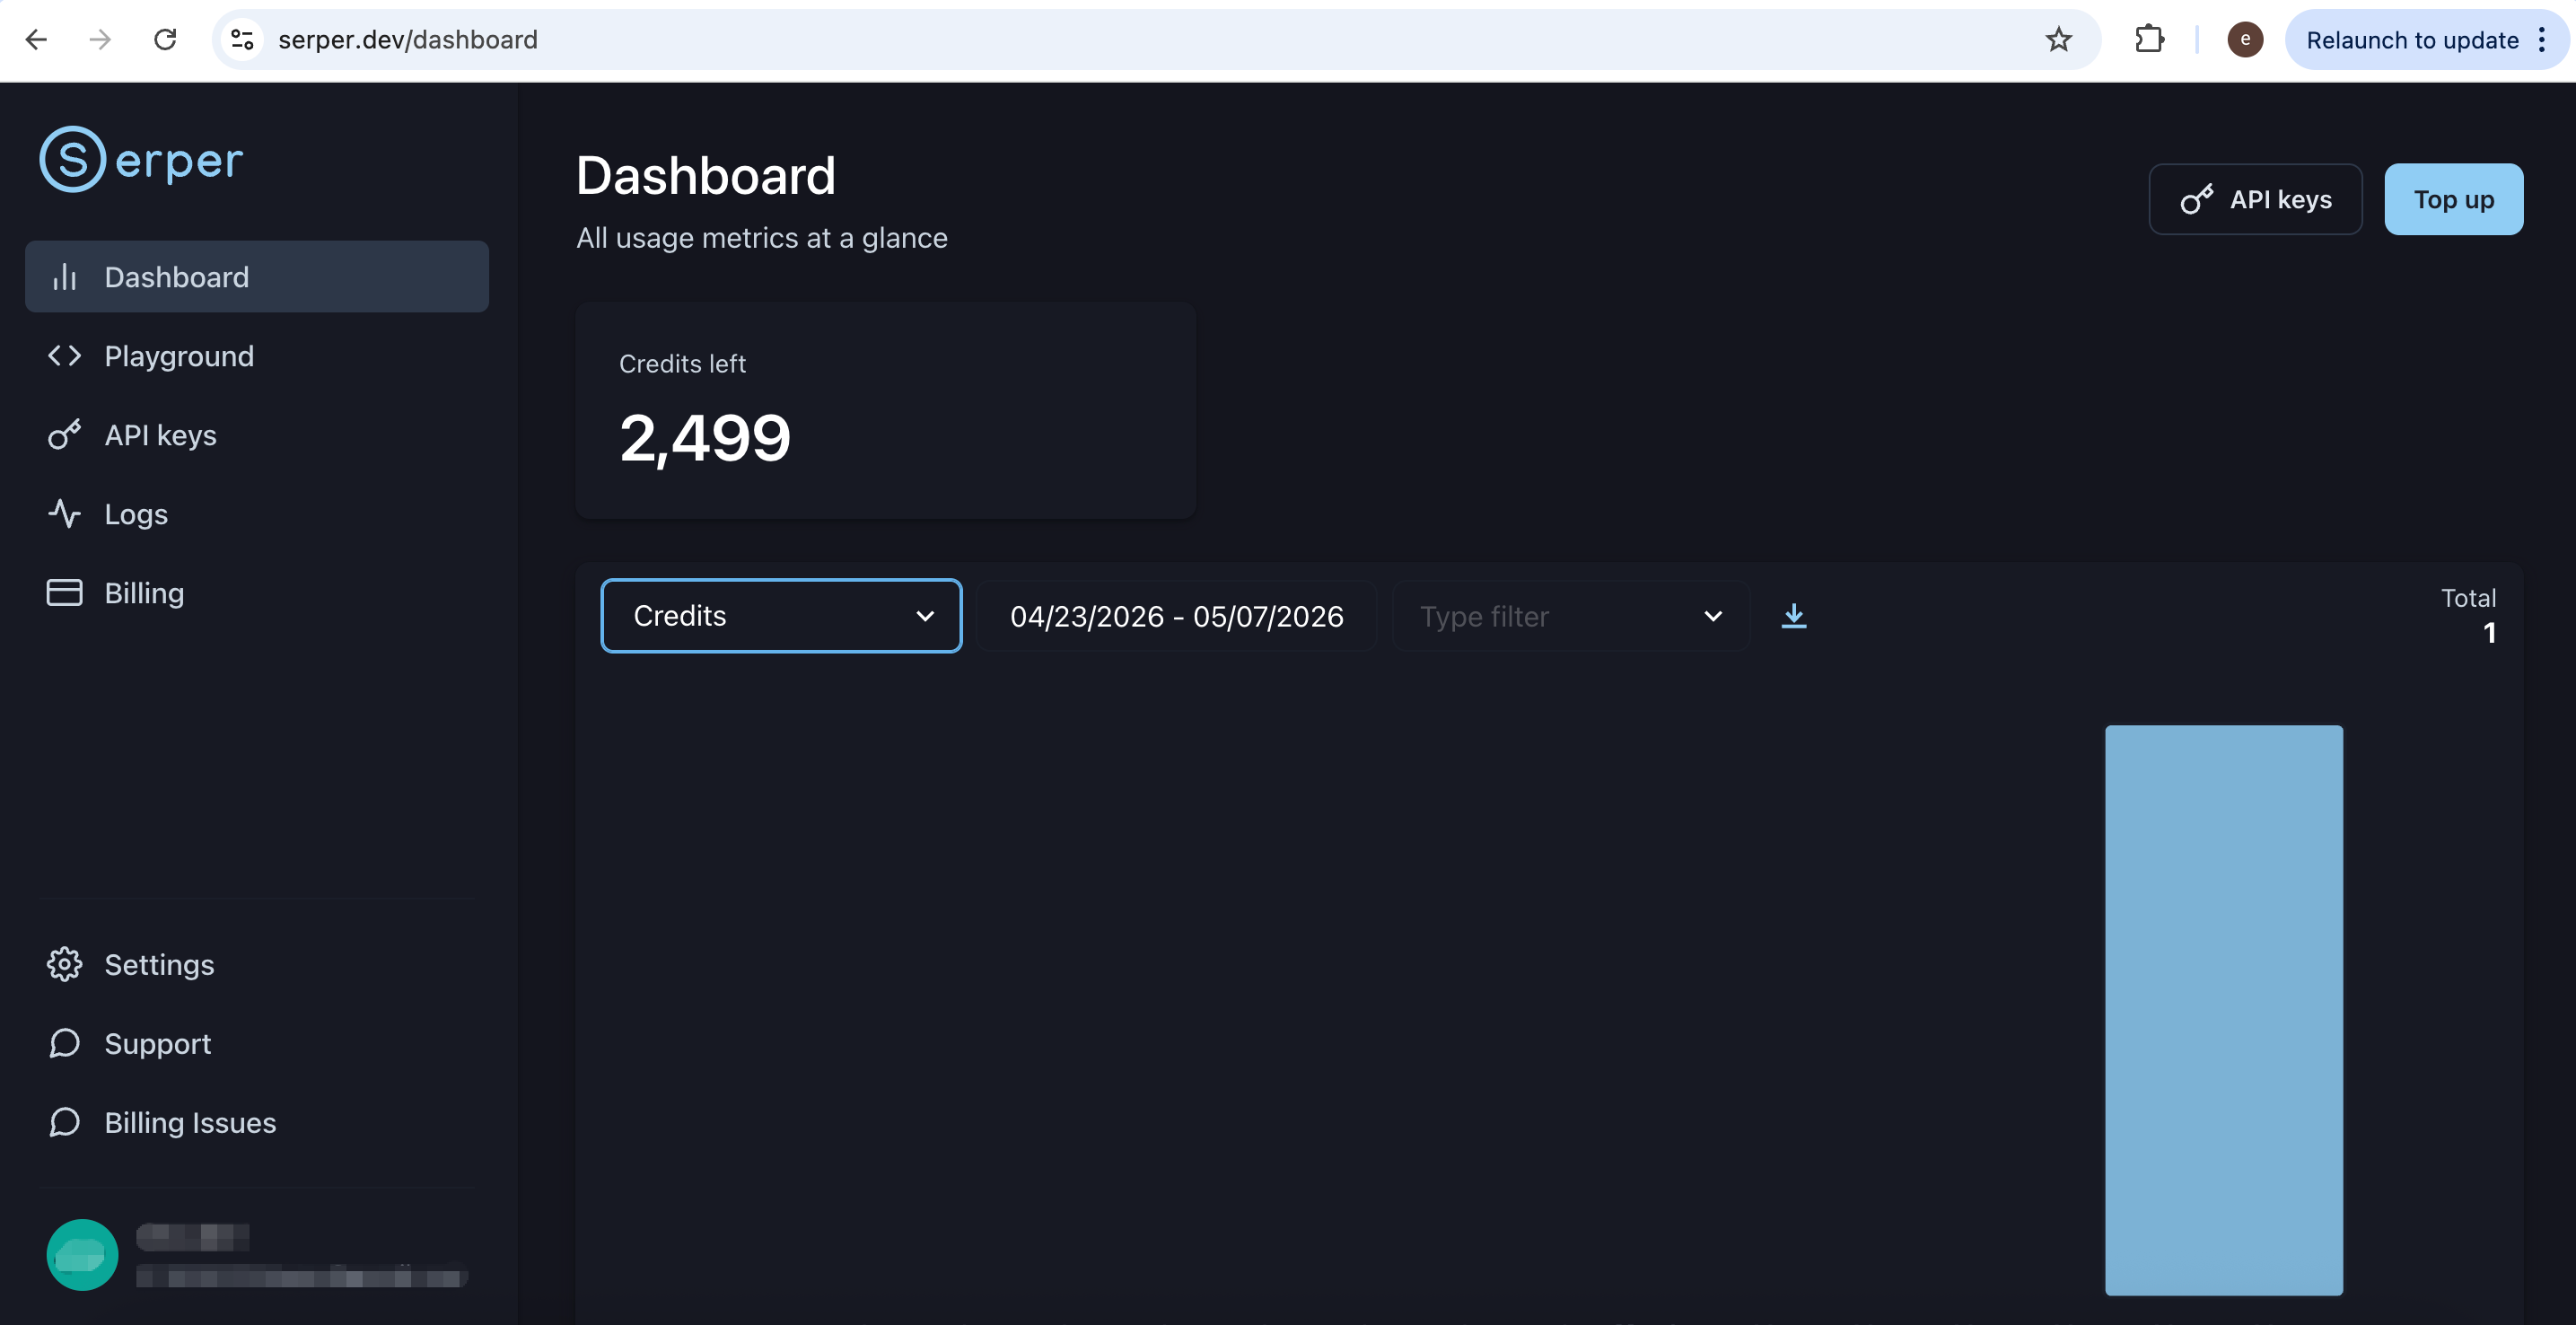
El plan gratuito de Serper es generoso en cuanto a volumen (de miles de búsquedas para cuentas nuevas en el momento de redactar este artículo), pero ofrece menos motores y resultados que SerpApi. Elige Serper cuando te baste con una opción limitada y centrada en Google; opta por SerpApi cuando necesites productos adicionales de Google (Académico, Noticias y otros) de un único proveedor.
2. SerpApi
SerpApi agrupa Google y muchos otros “motores” de Google como datos estructurados, de modo que los agentes pueden automatizar la búsqueda sin tener que abrir cada resultado manualmente. Convierte las páginas de resultados en un JSON limpio, que es más fácil de filtrar, clasificar y transmitir a las etapas posteriores que el HTML sin procesar.
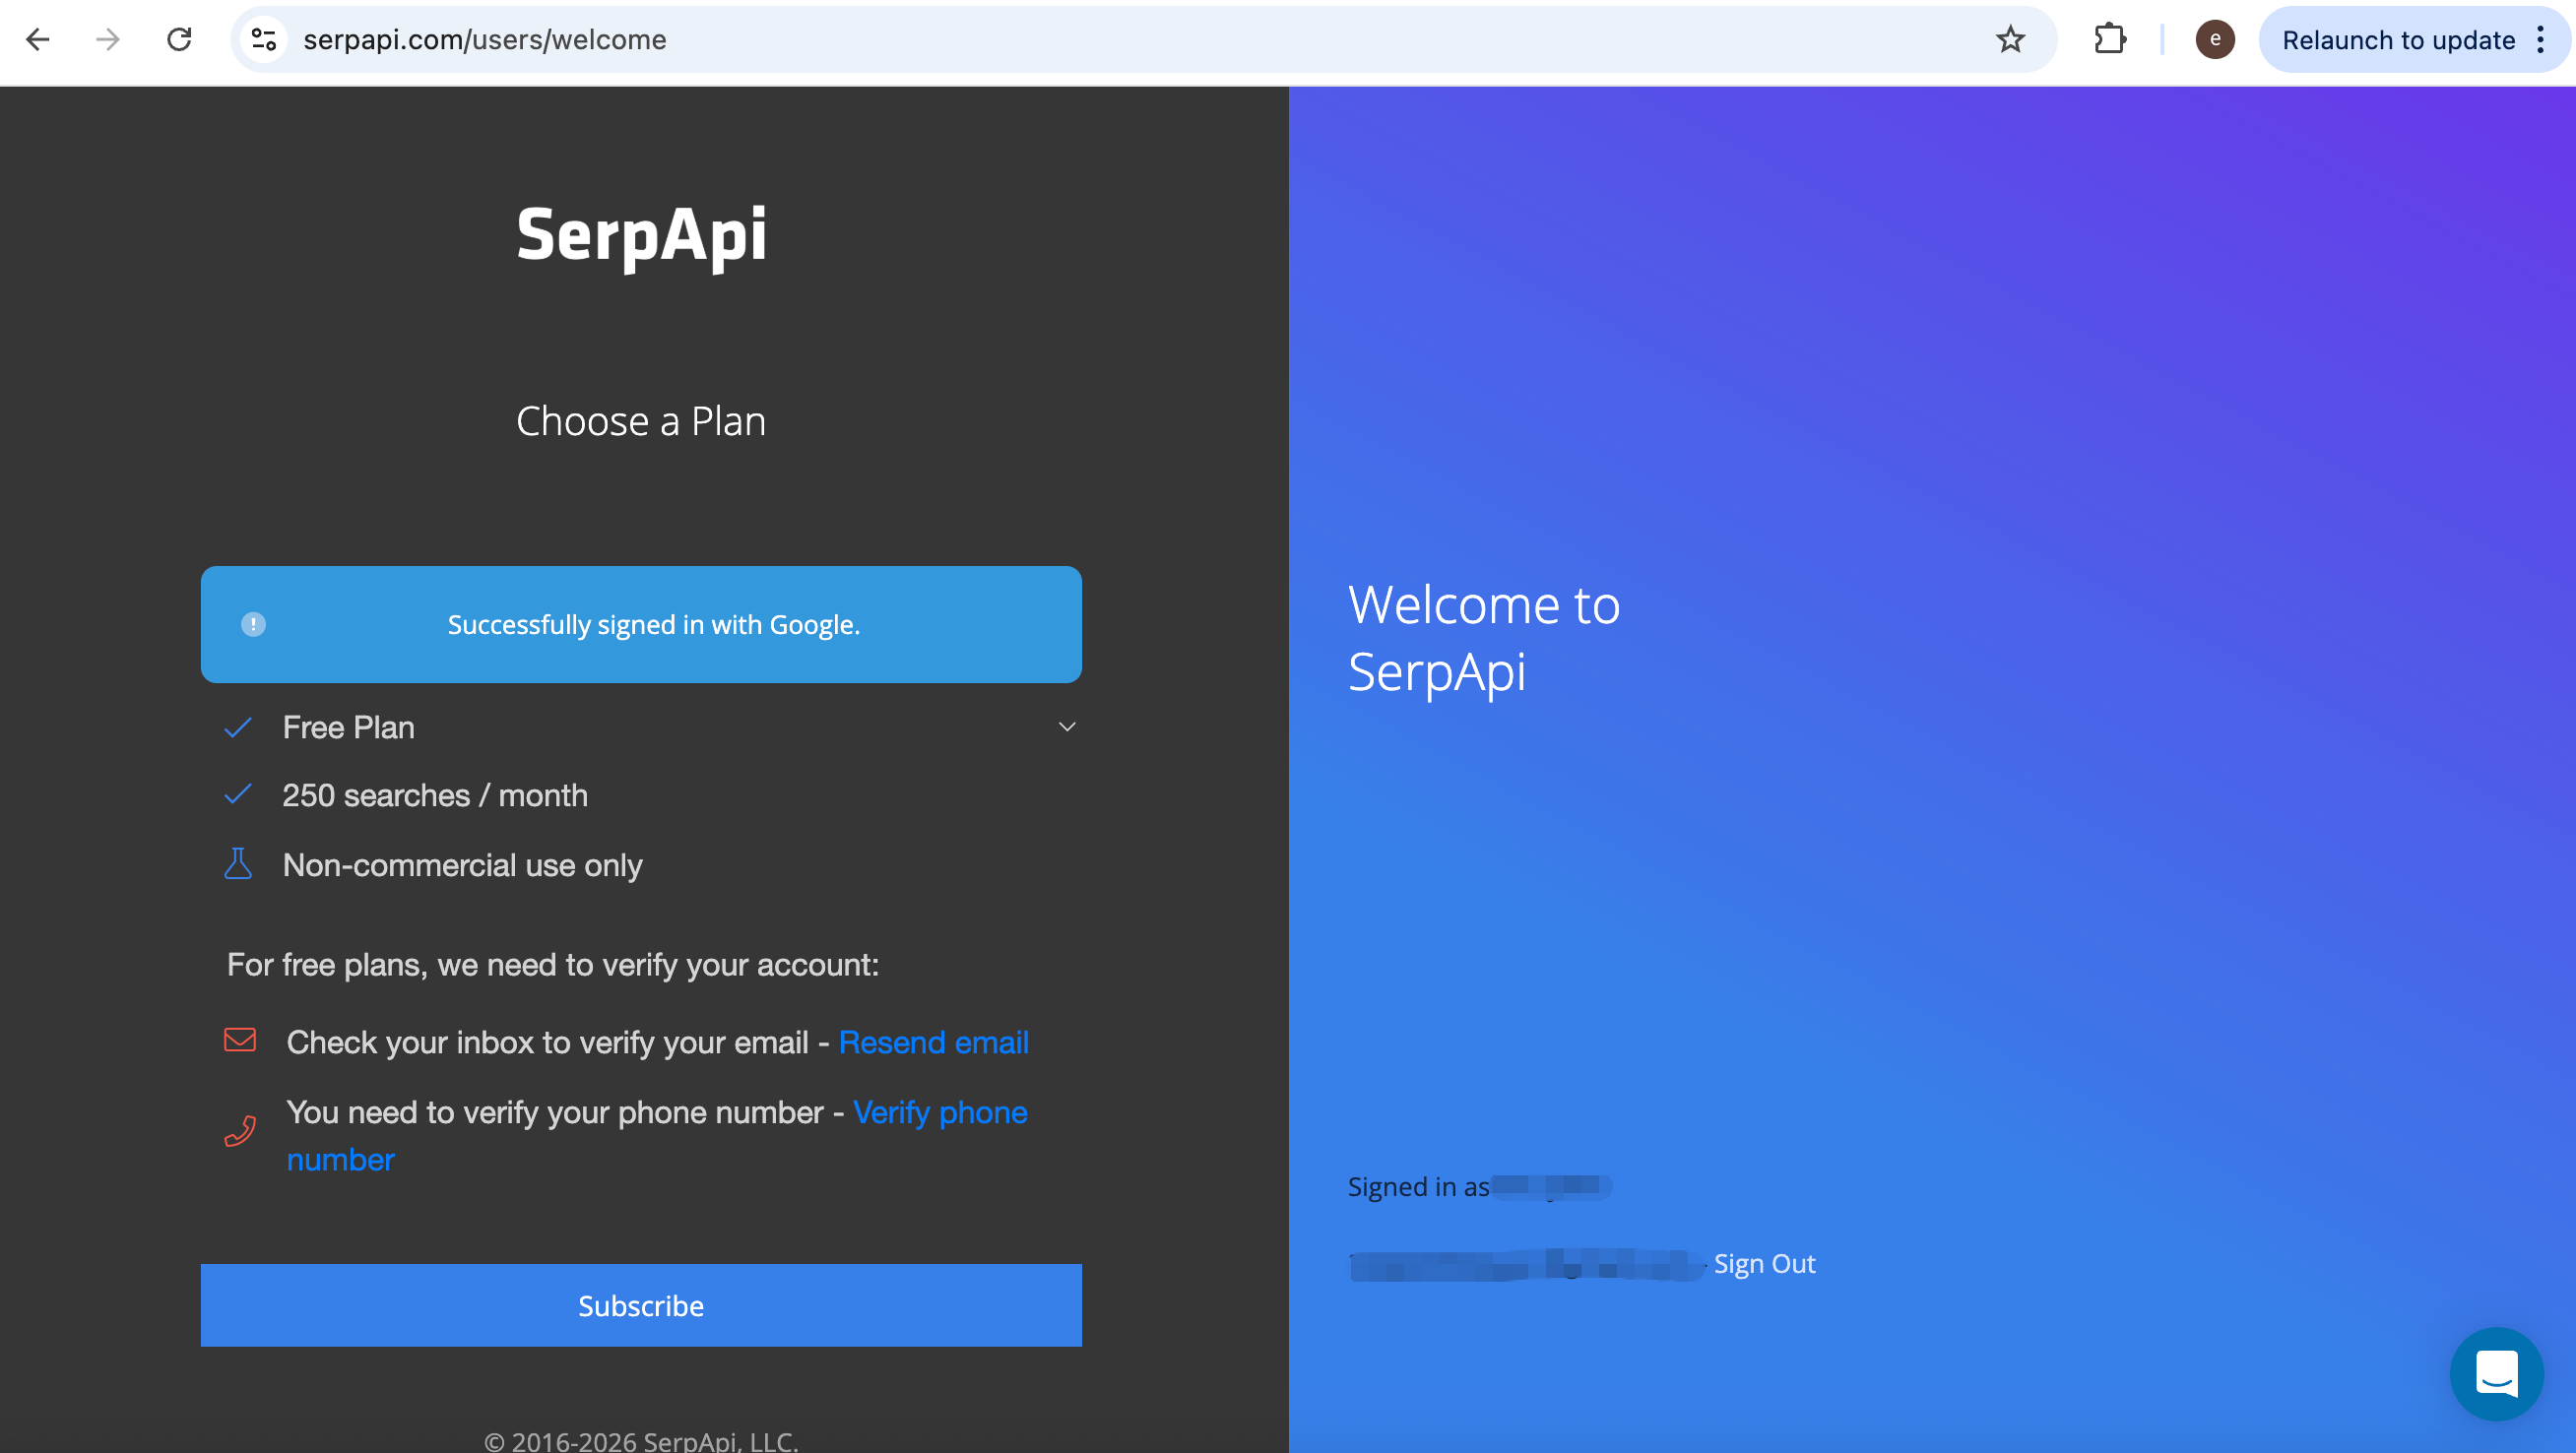
Regístrate e inicia sesión en https://serpapi.com/users/sign_in.
El plan gratuito predeterminado incluye un número limitado de búsquedas al mes; actualiza tu plan si tu volumen de trabajo aumenta.
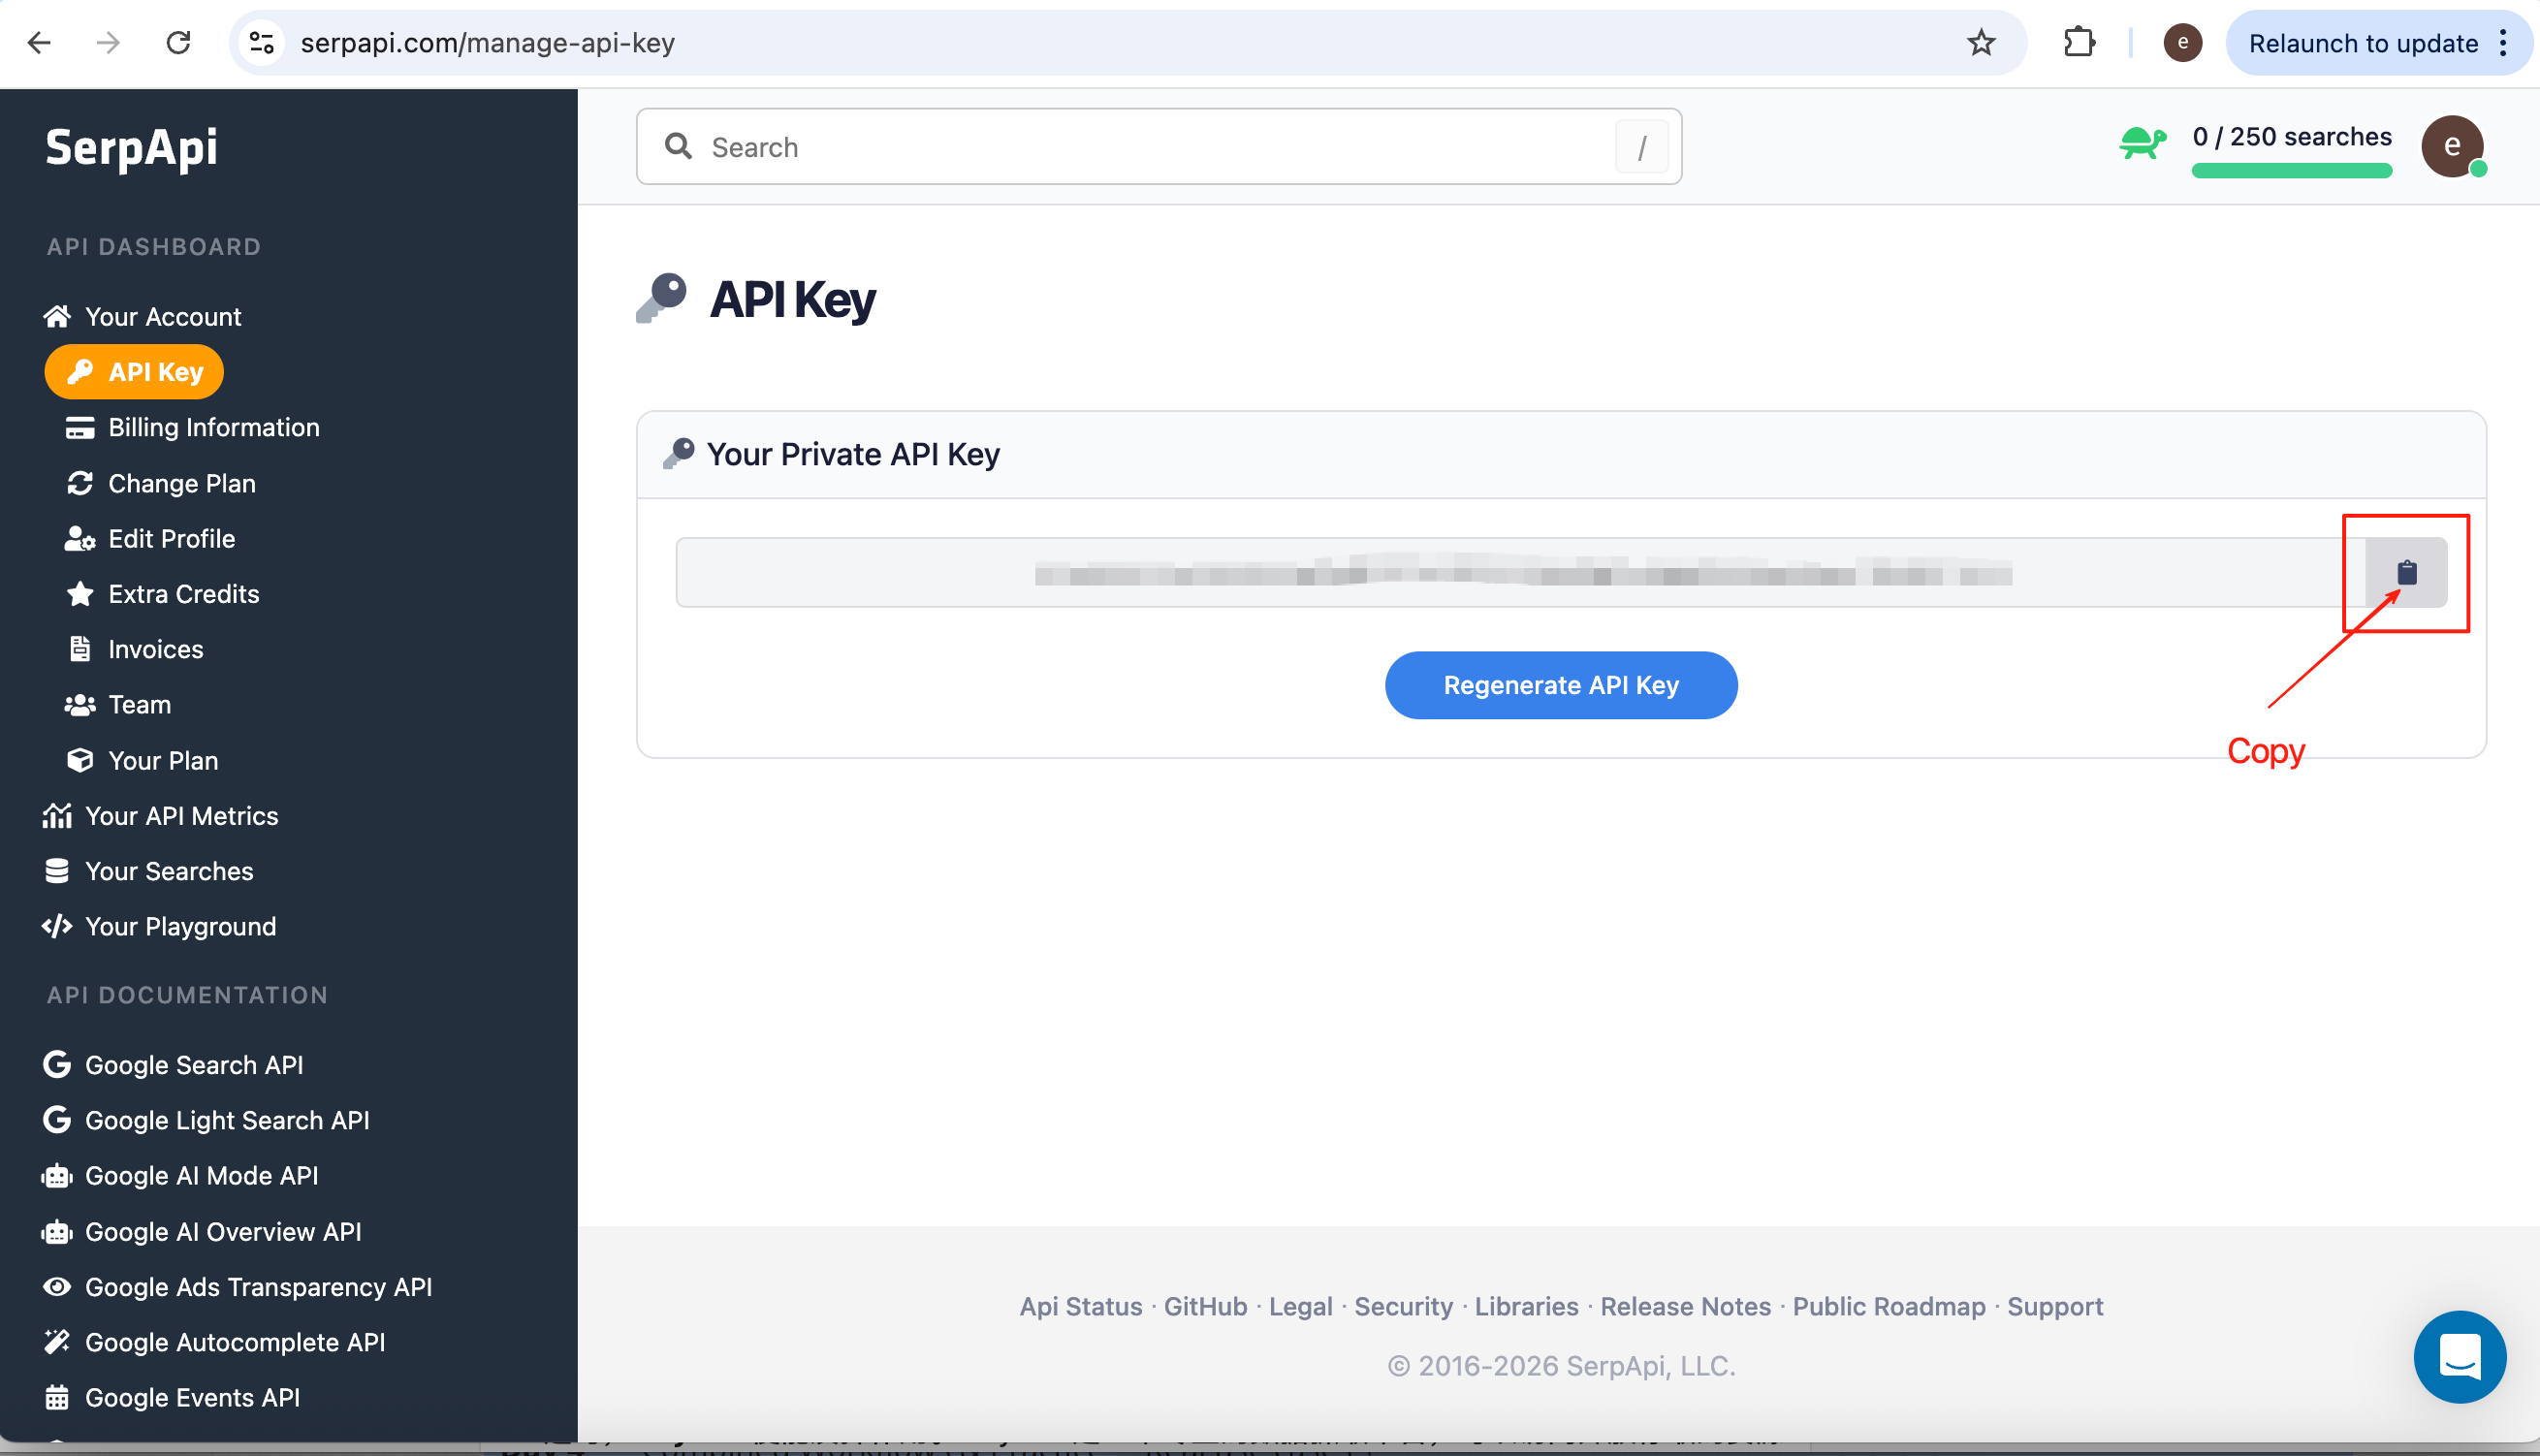
Desde el panel de control, copia tu clave de API.
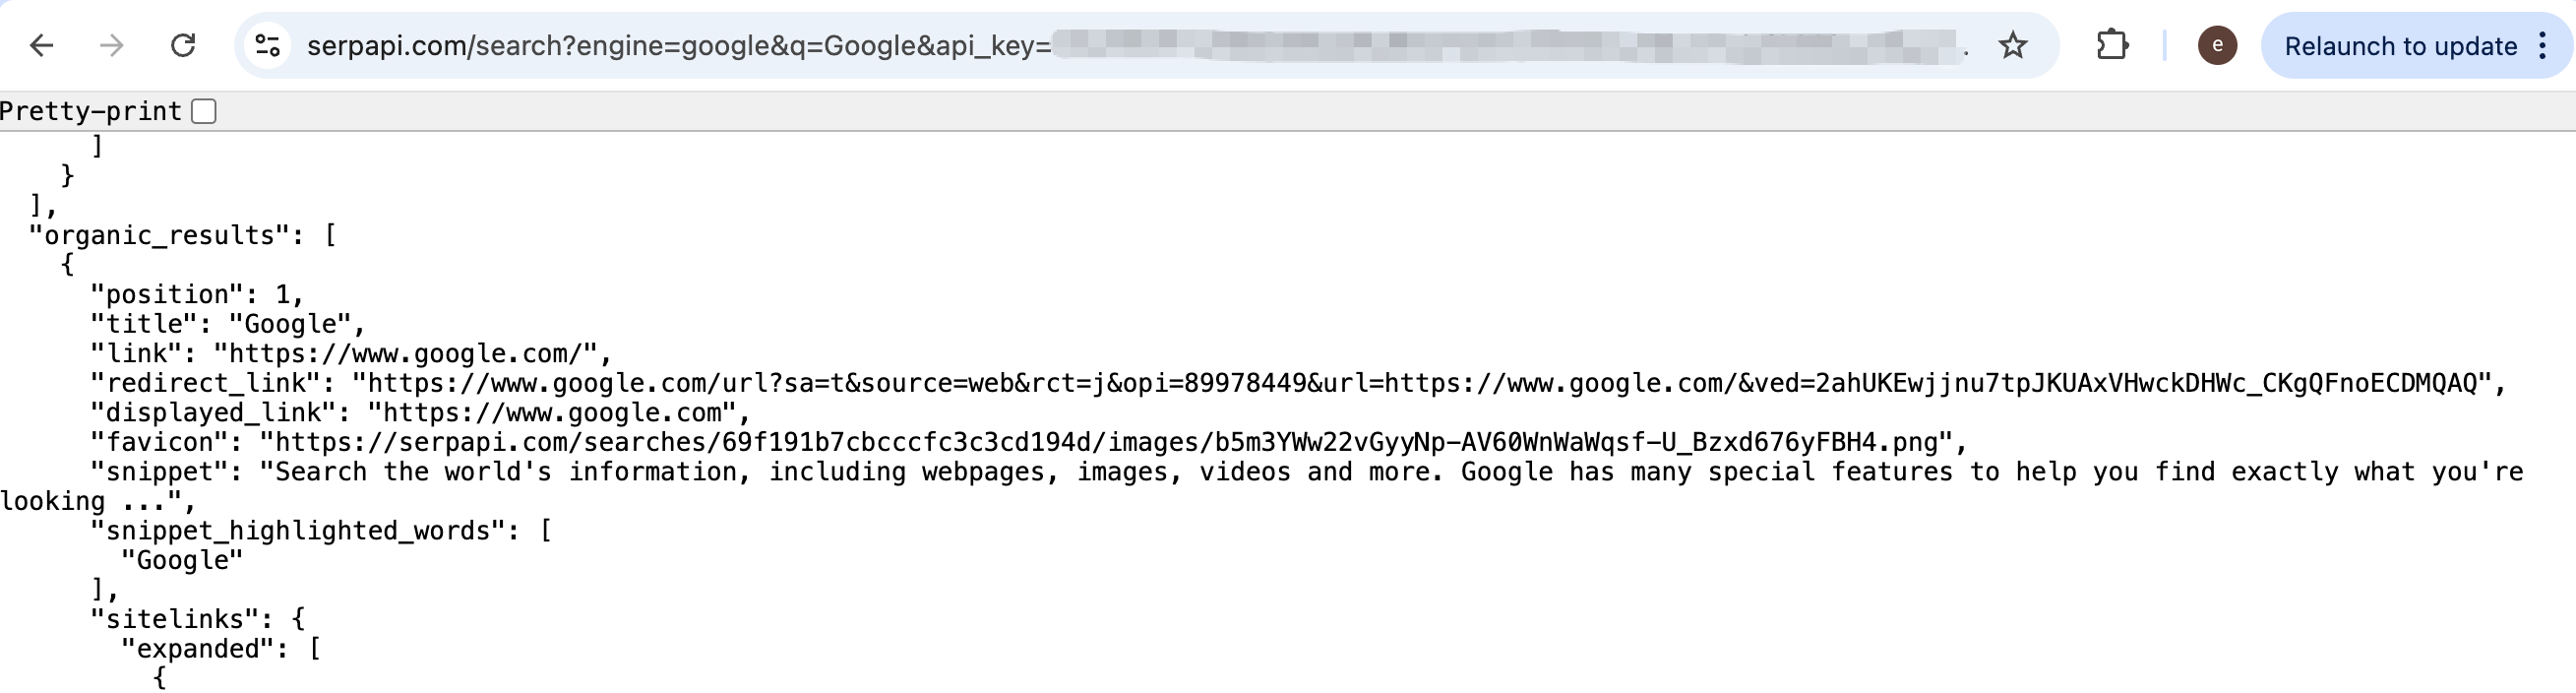
Una solicitud web mínima a Google tiene este aspecto (sustituye con tu consulta y tu clave):
https://serpapi.com/search?engine=google&q={palabras de búsqueda}&api_key={tu clave de API}Pega la URL en un navegador una vez para confirmar que ves formato JSON en lugar de HTML.
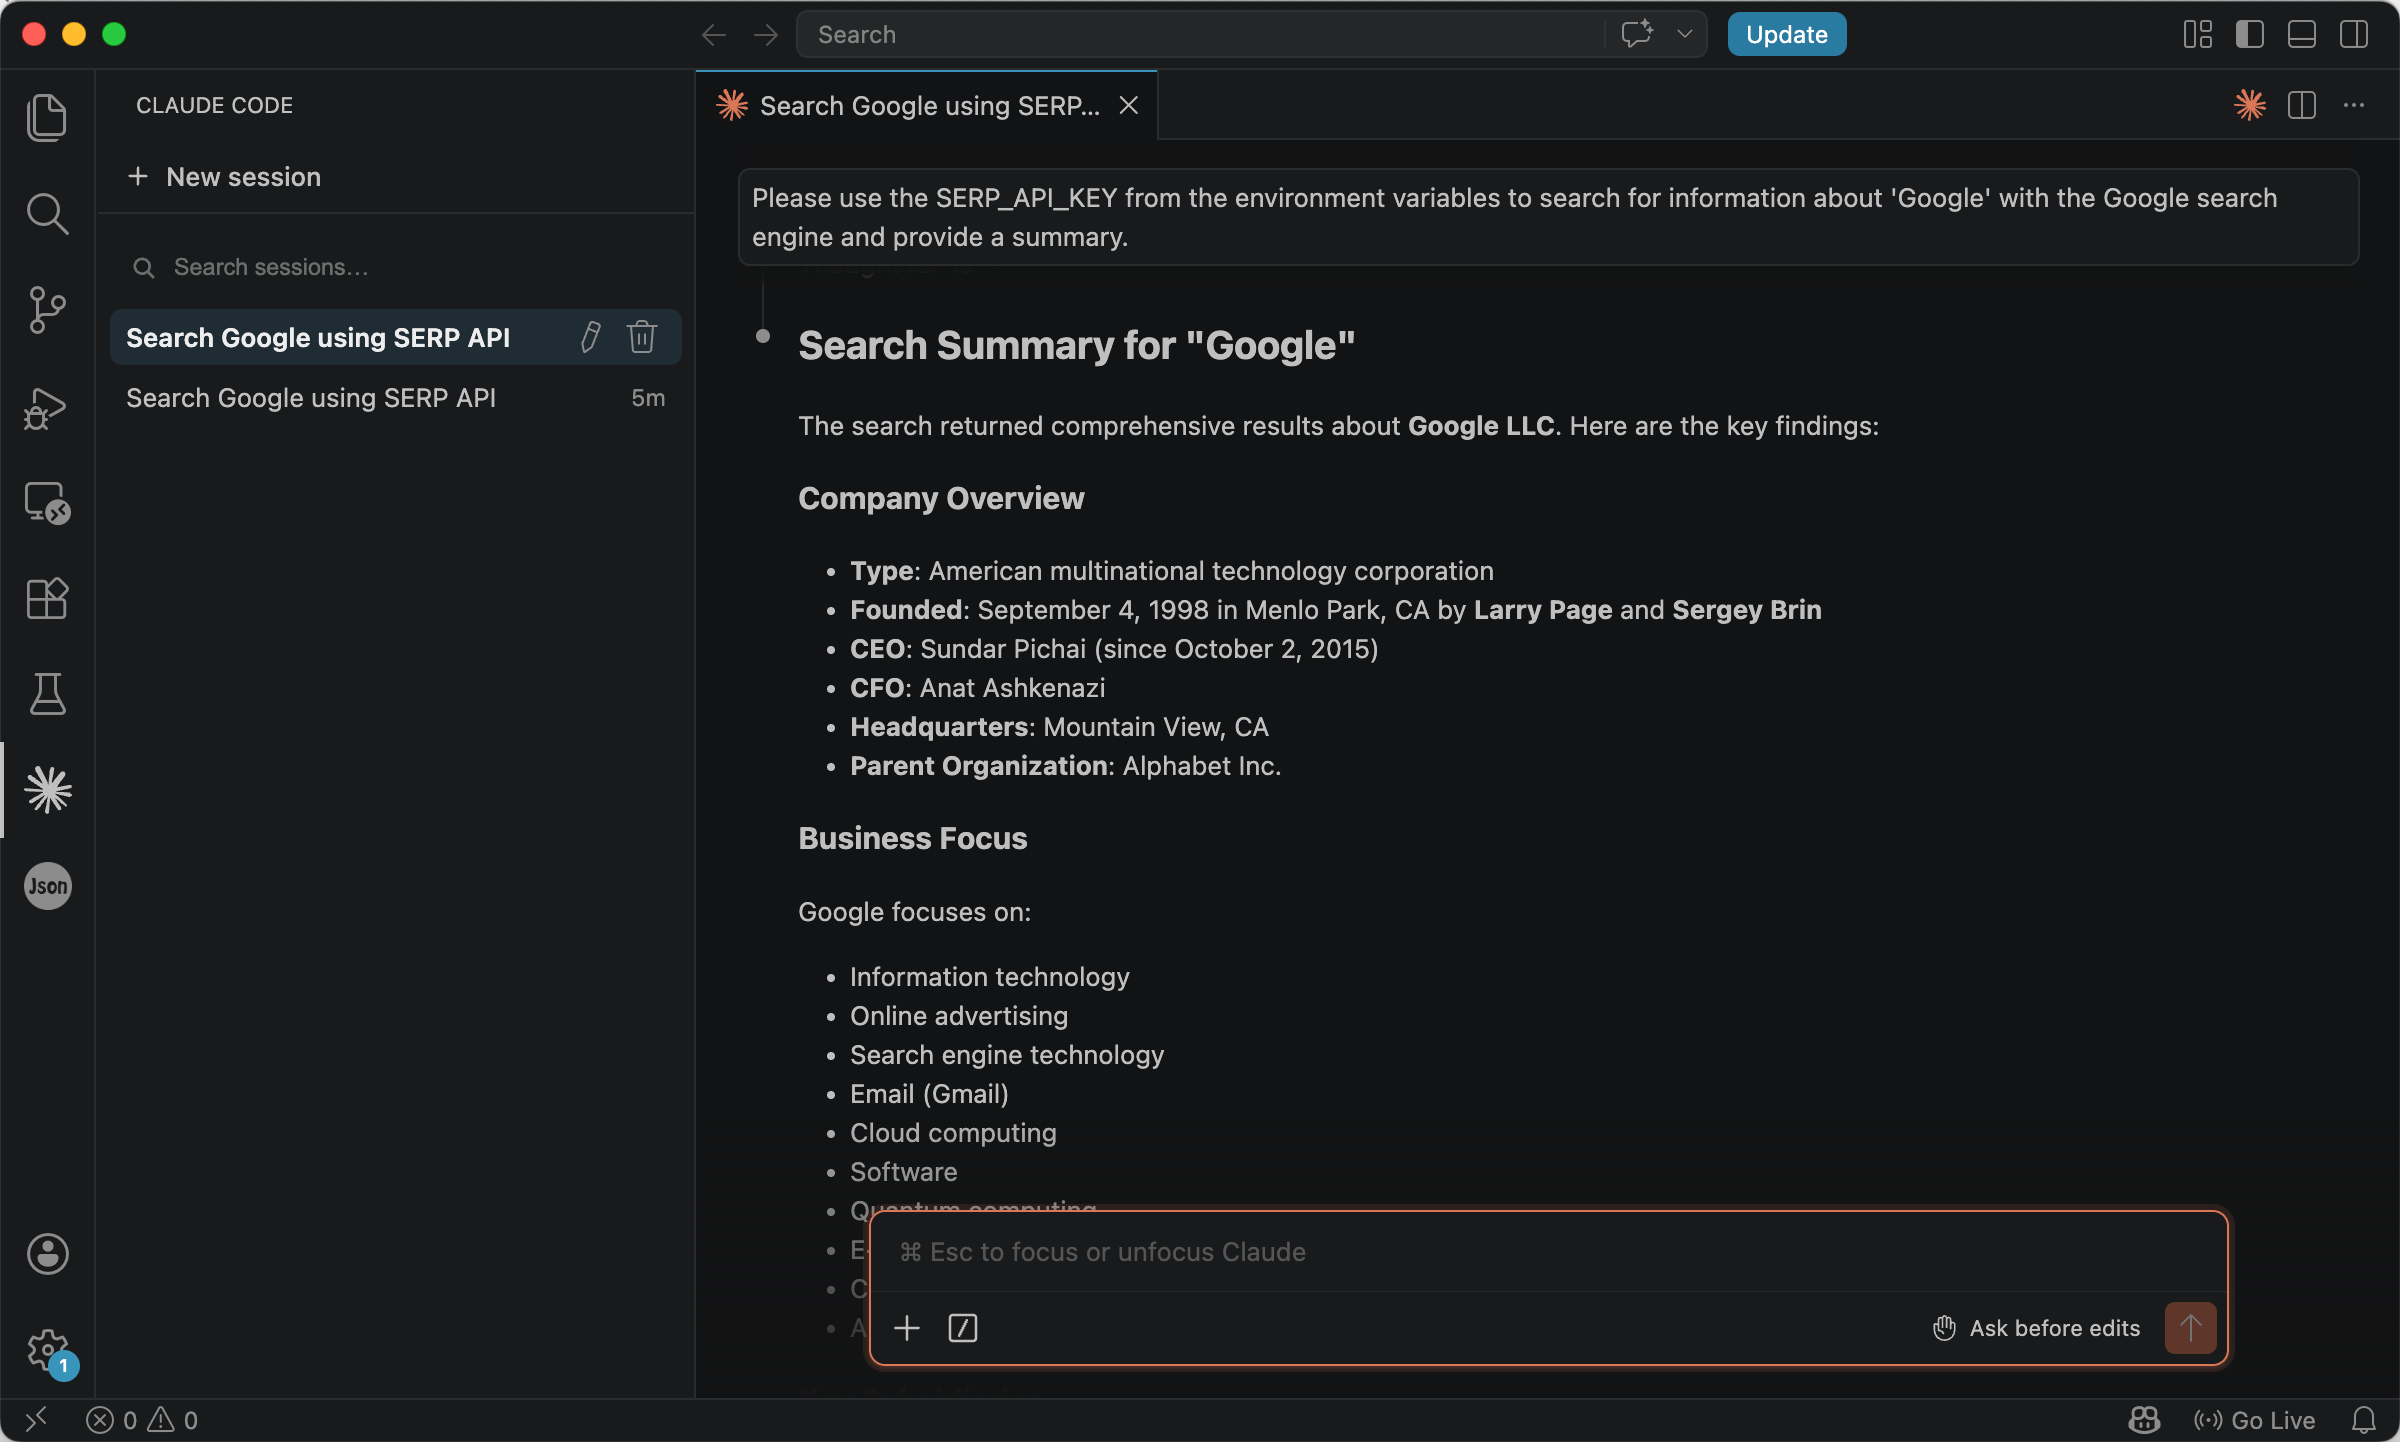
En el agente, lee la clave del entorno, por ejemplo SERP_API_KEY, y mantén el patrón de la URL en el indicador o en la configuración de la herramienta:
Utiliza la variable de entorno SERP_API_KEY para buscar información sobre «Google» con el motor de búsqueda de Google y proporciona un resumen. El formato de la API es:
https://serpapi.com/search?engine=google&q={palabras de búsqueda}&api_key={tu clave de API}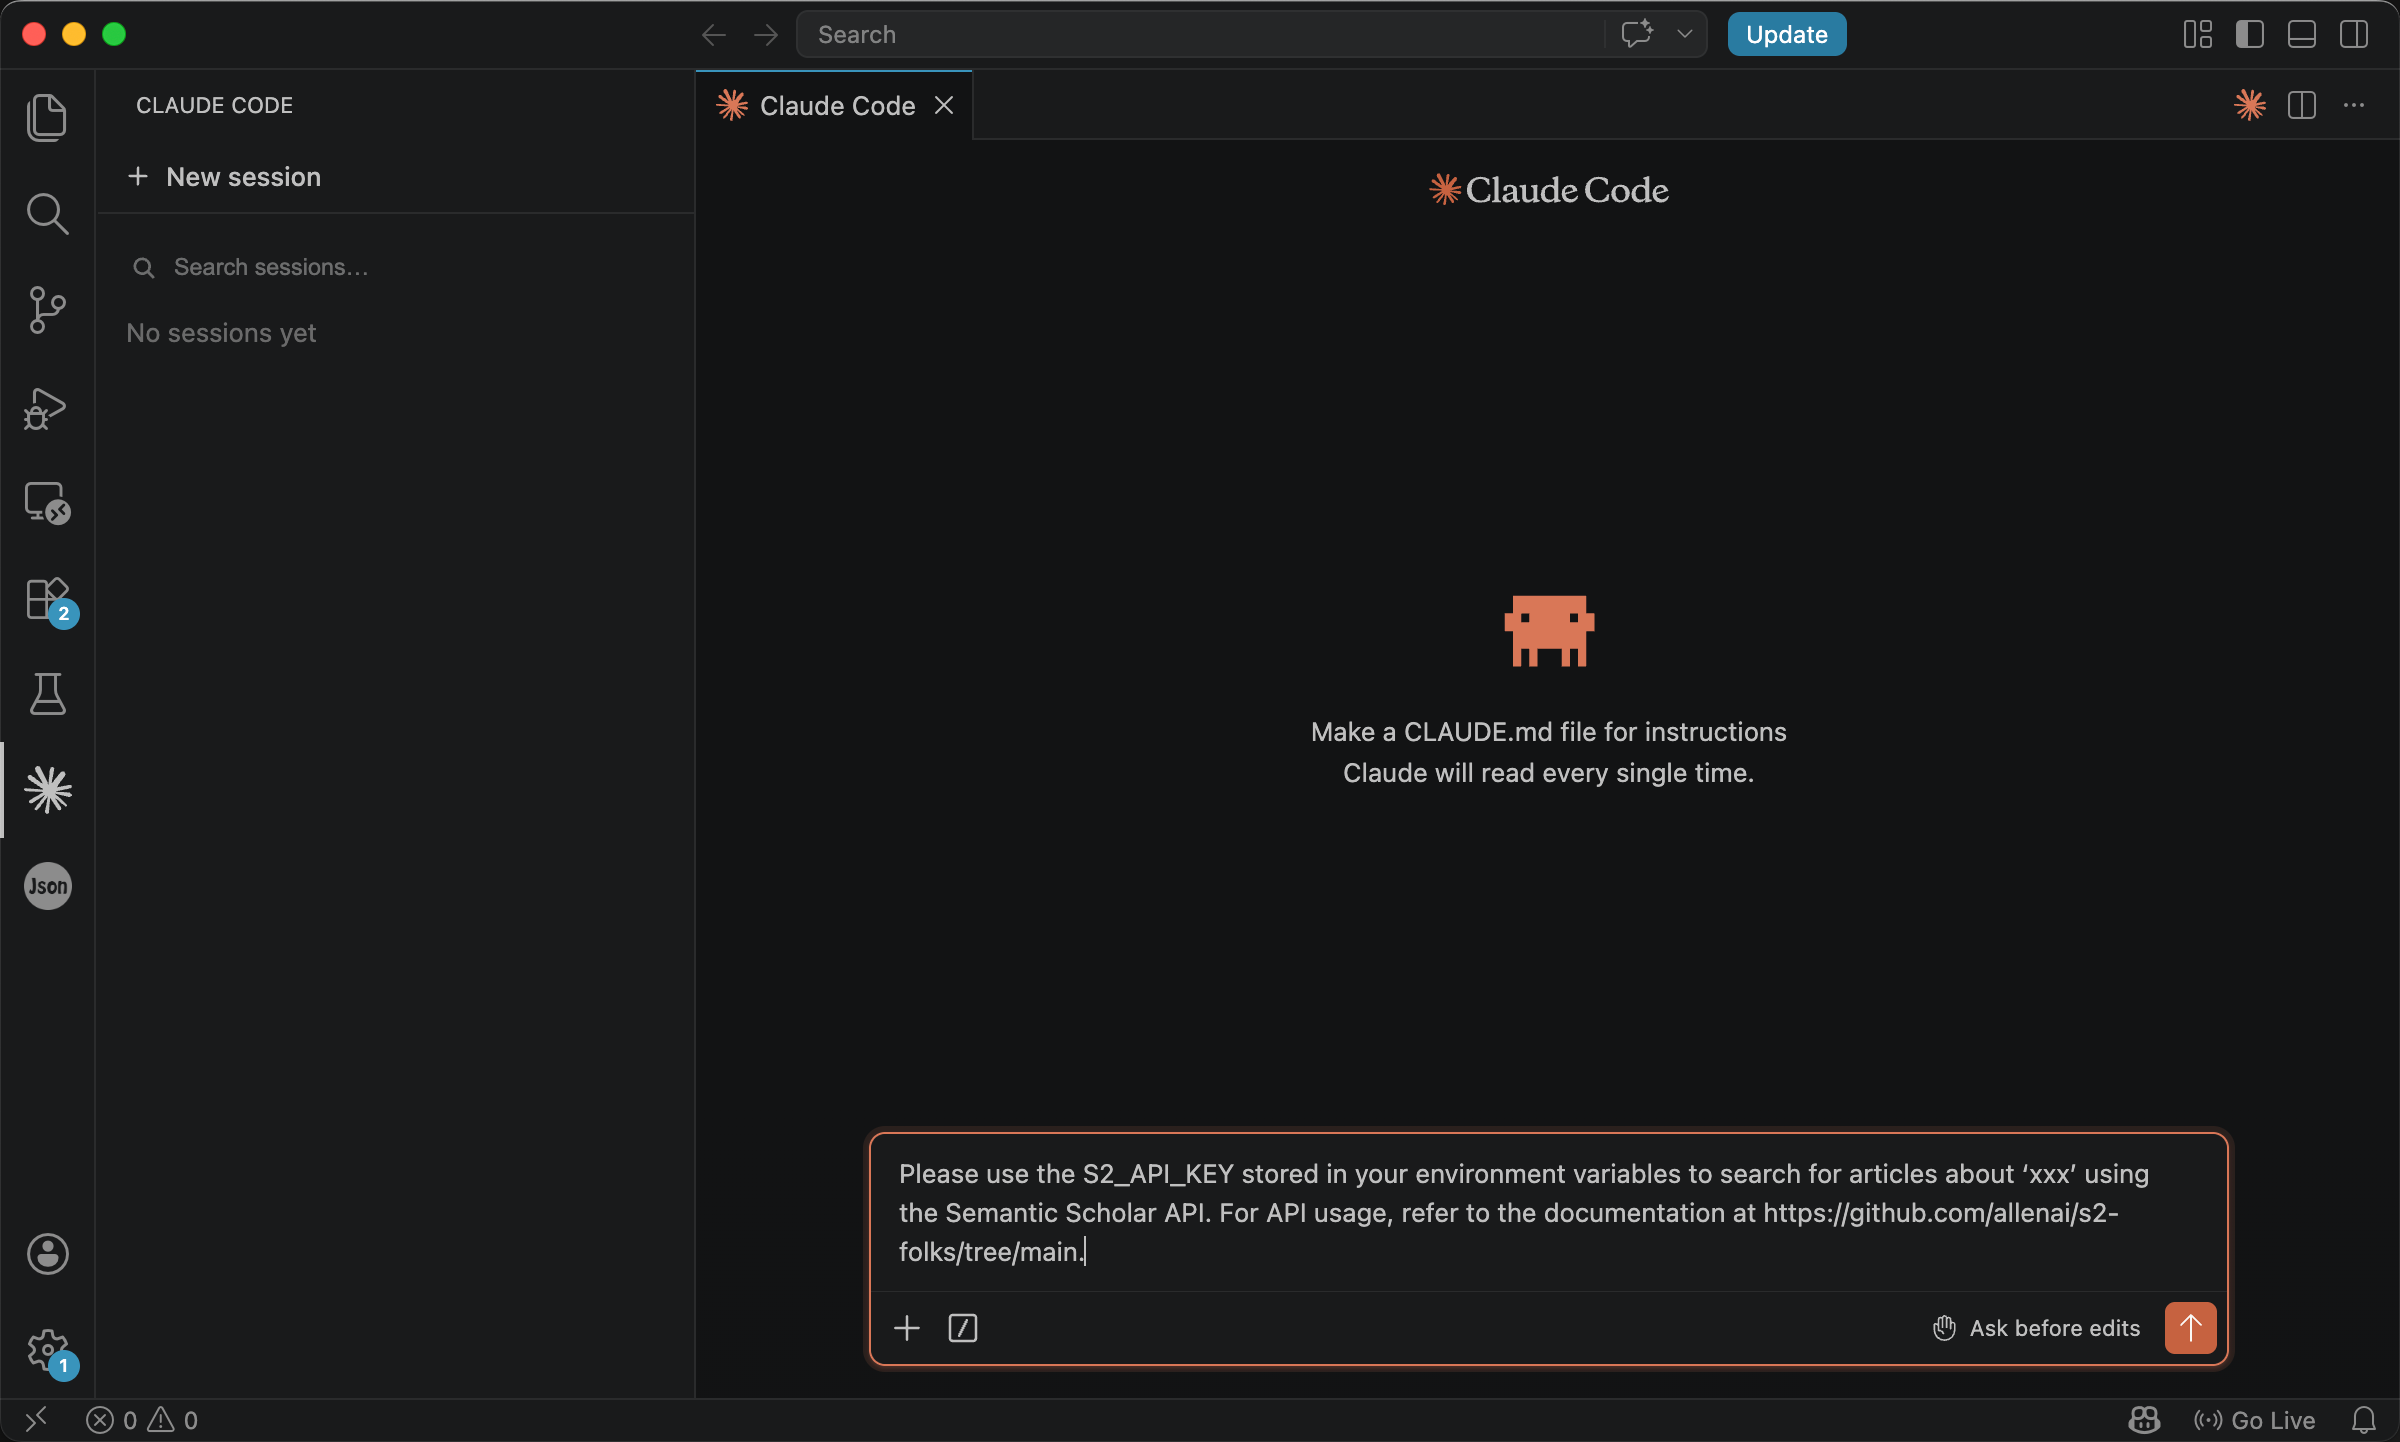
El modelo realiza la solicitud y devuelve un breve resumen de los resultados.
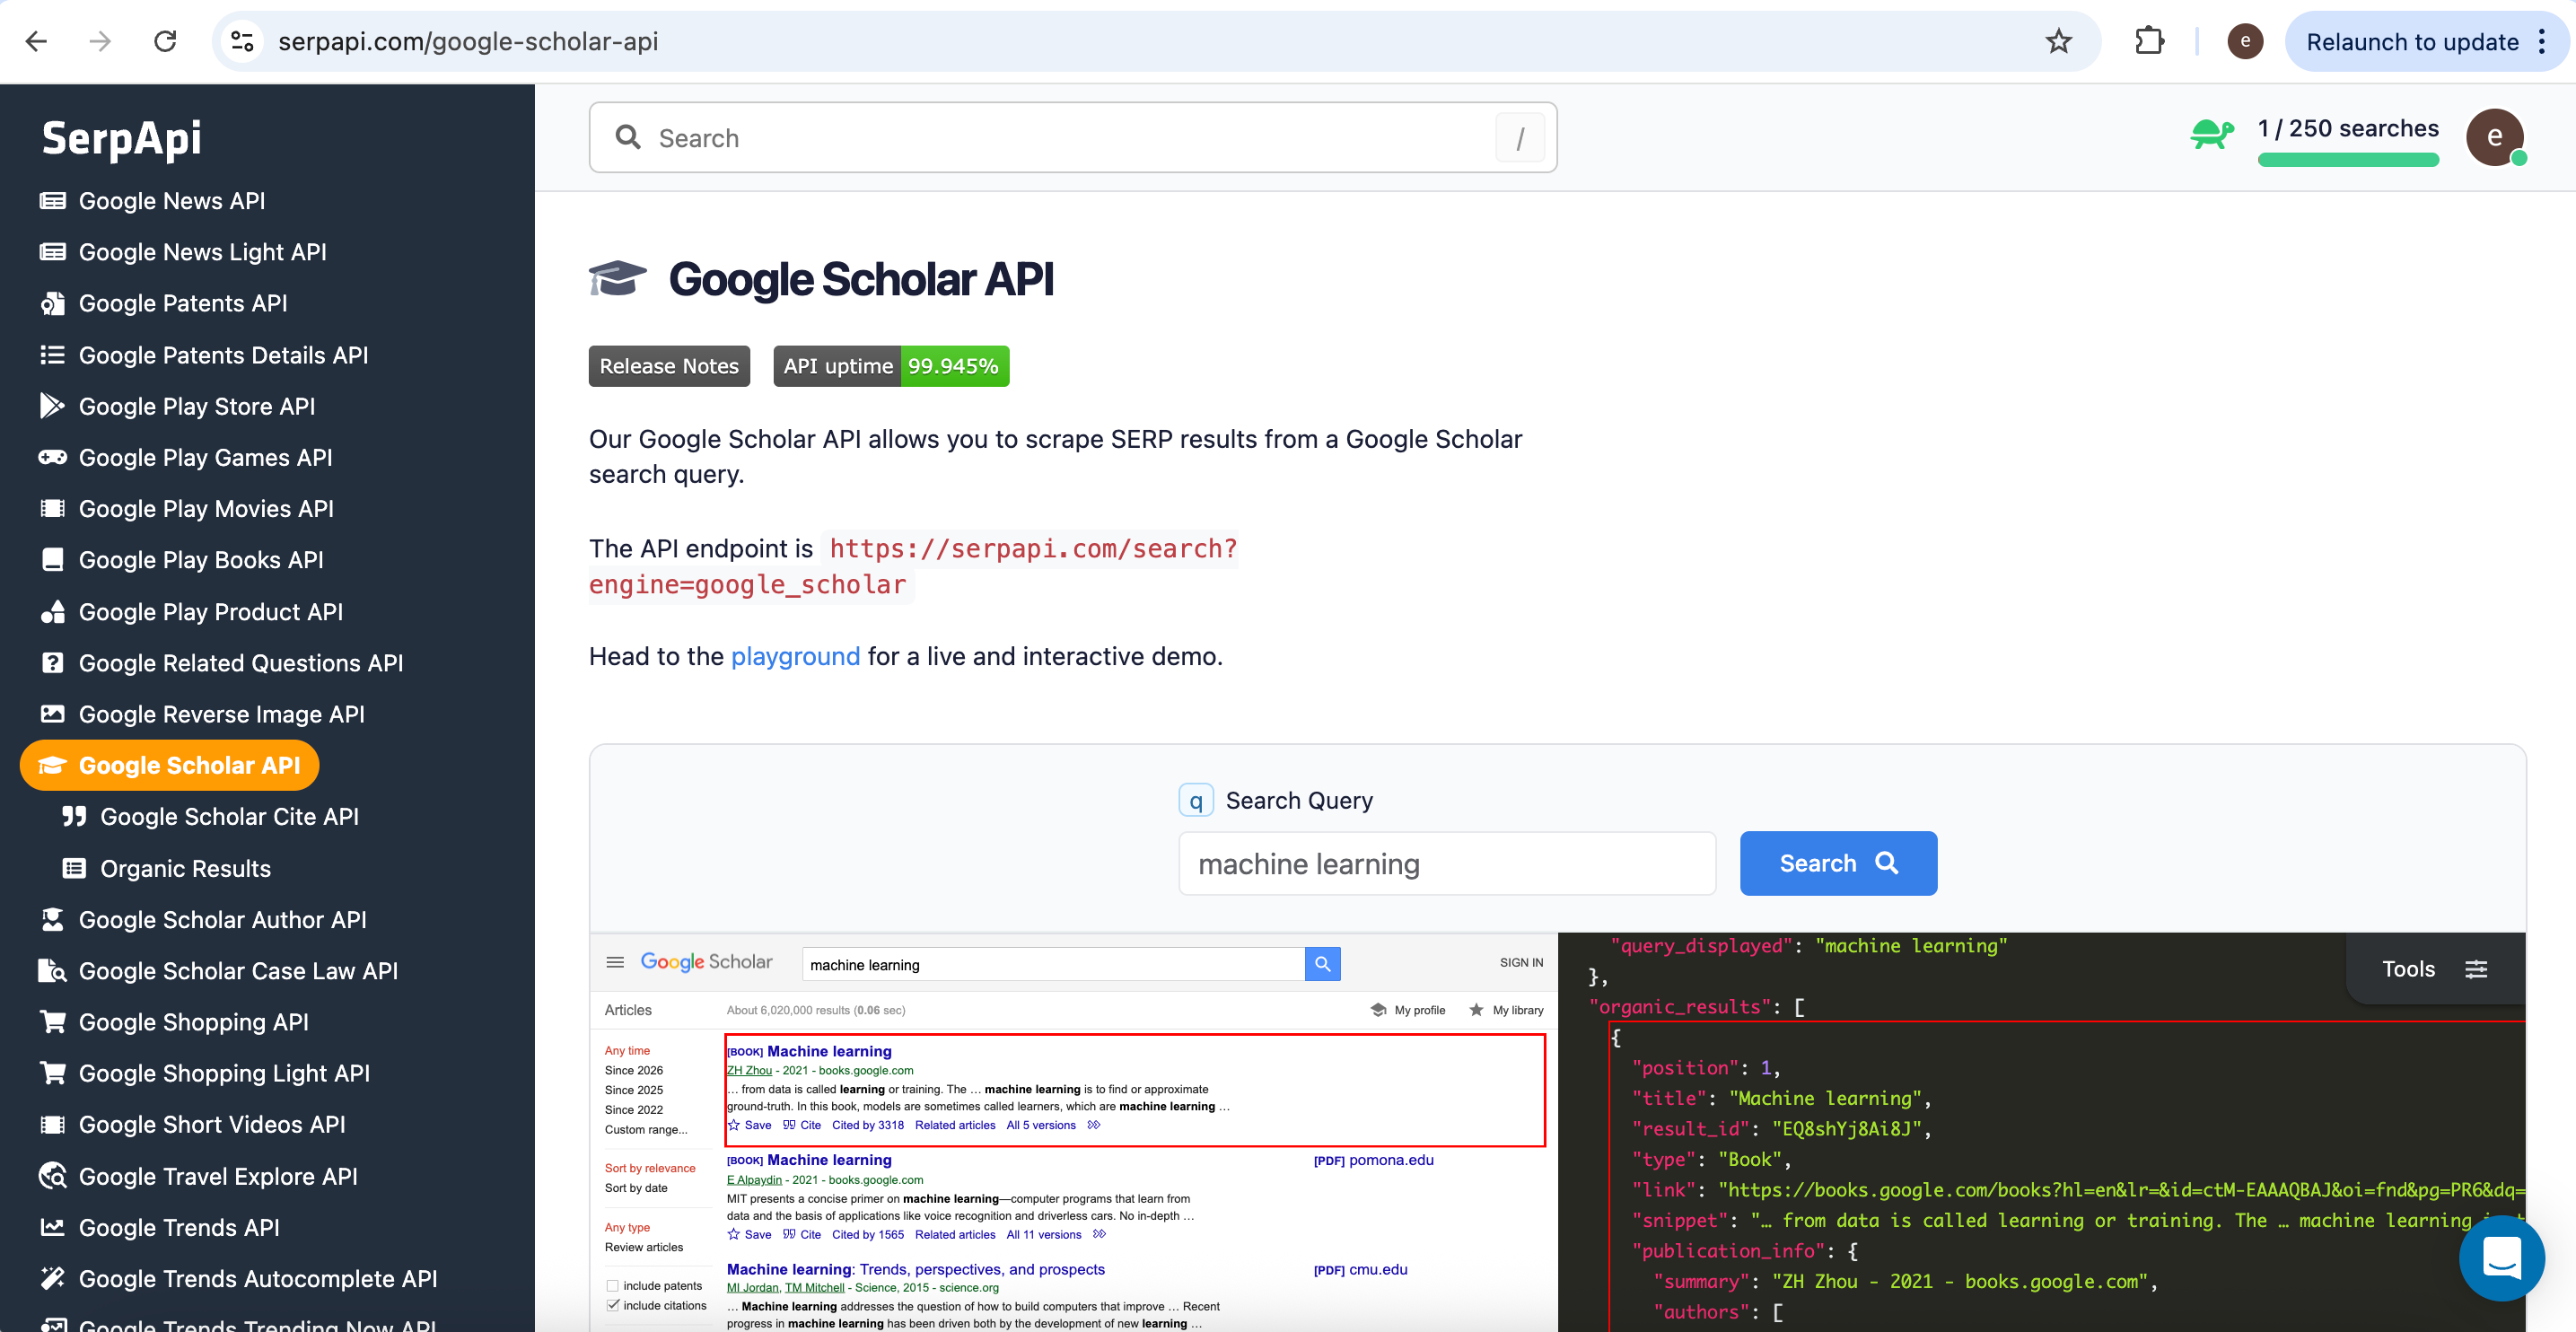
Este patrón se puede generalizar: SerpApi también ofrece acceso a Google Scholar, Google Events, Google Finance y otros servicios; ajusta el motor de búsqueda y el prompt para que el agente seleccione la fuente adecuada.
Recuperación de contenido web
La búsqueda te indica qué podría merecer la pena leer. La recuperación es la forma de conseguir el contenido completo, conforme a las normas: archivos PDF de repositorios abiertos, metadatos de API académicas o texto normalizado procedente de herramientas diseñadas para la extracción, no una copia masiva improvisada de sitios web completos.
API orientadas a PDF y documentos
arXiv
arXiv es un servicio de acceso abierto a preimpresiones gestionado por la Universidad de Cornell. Se utiliza ampliamente en informática, física, matemáticas y campos afines. Dado que los autores suelen subir sus trabajos antes de su publicación en revistas, arXiv es a menudo el primer lugar donde aparecen los nuevos trabajos.
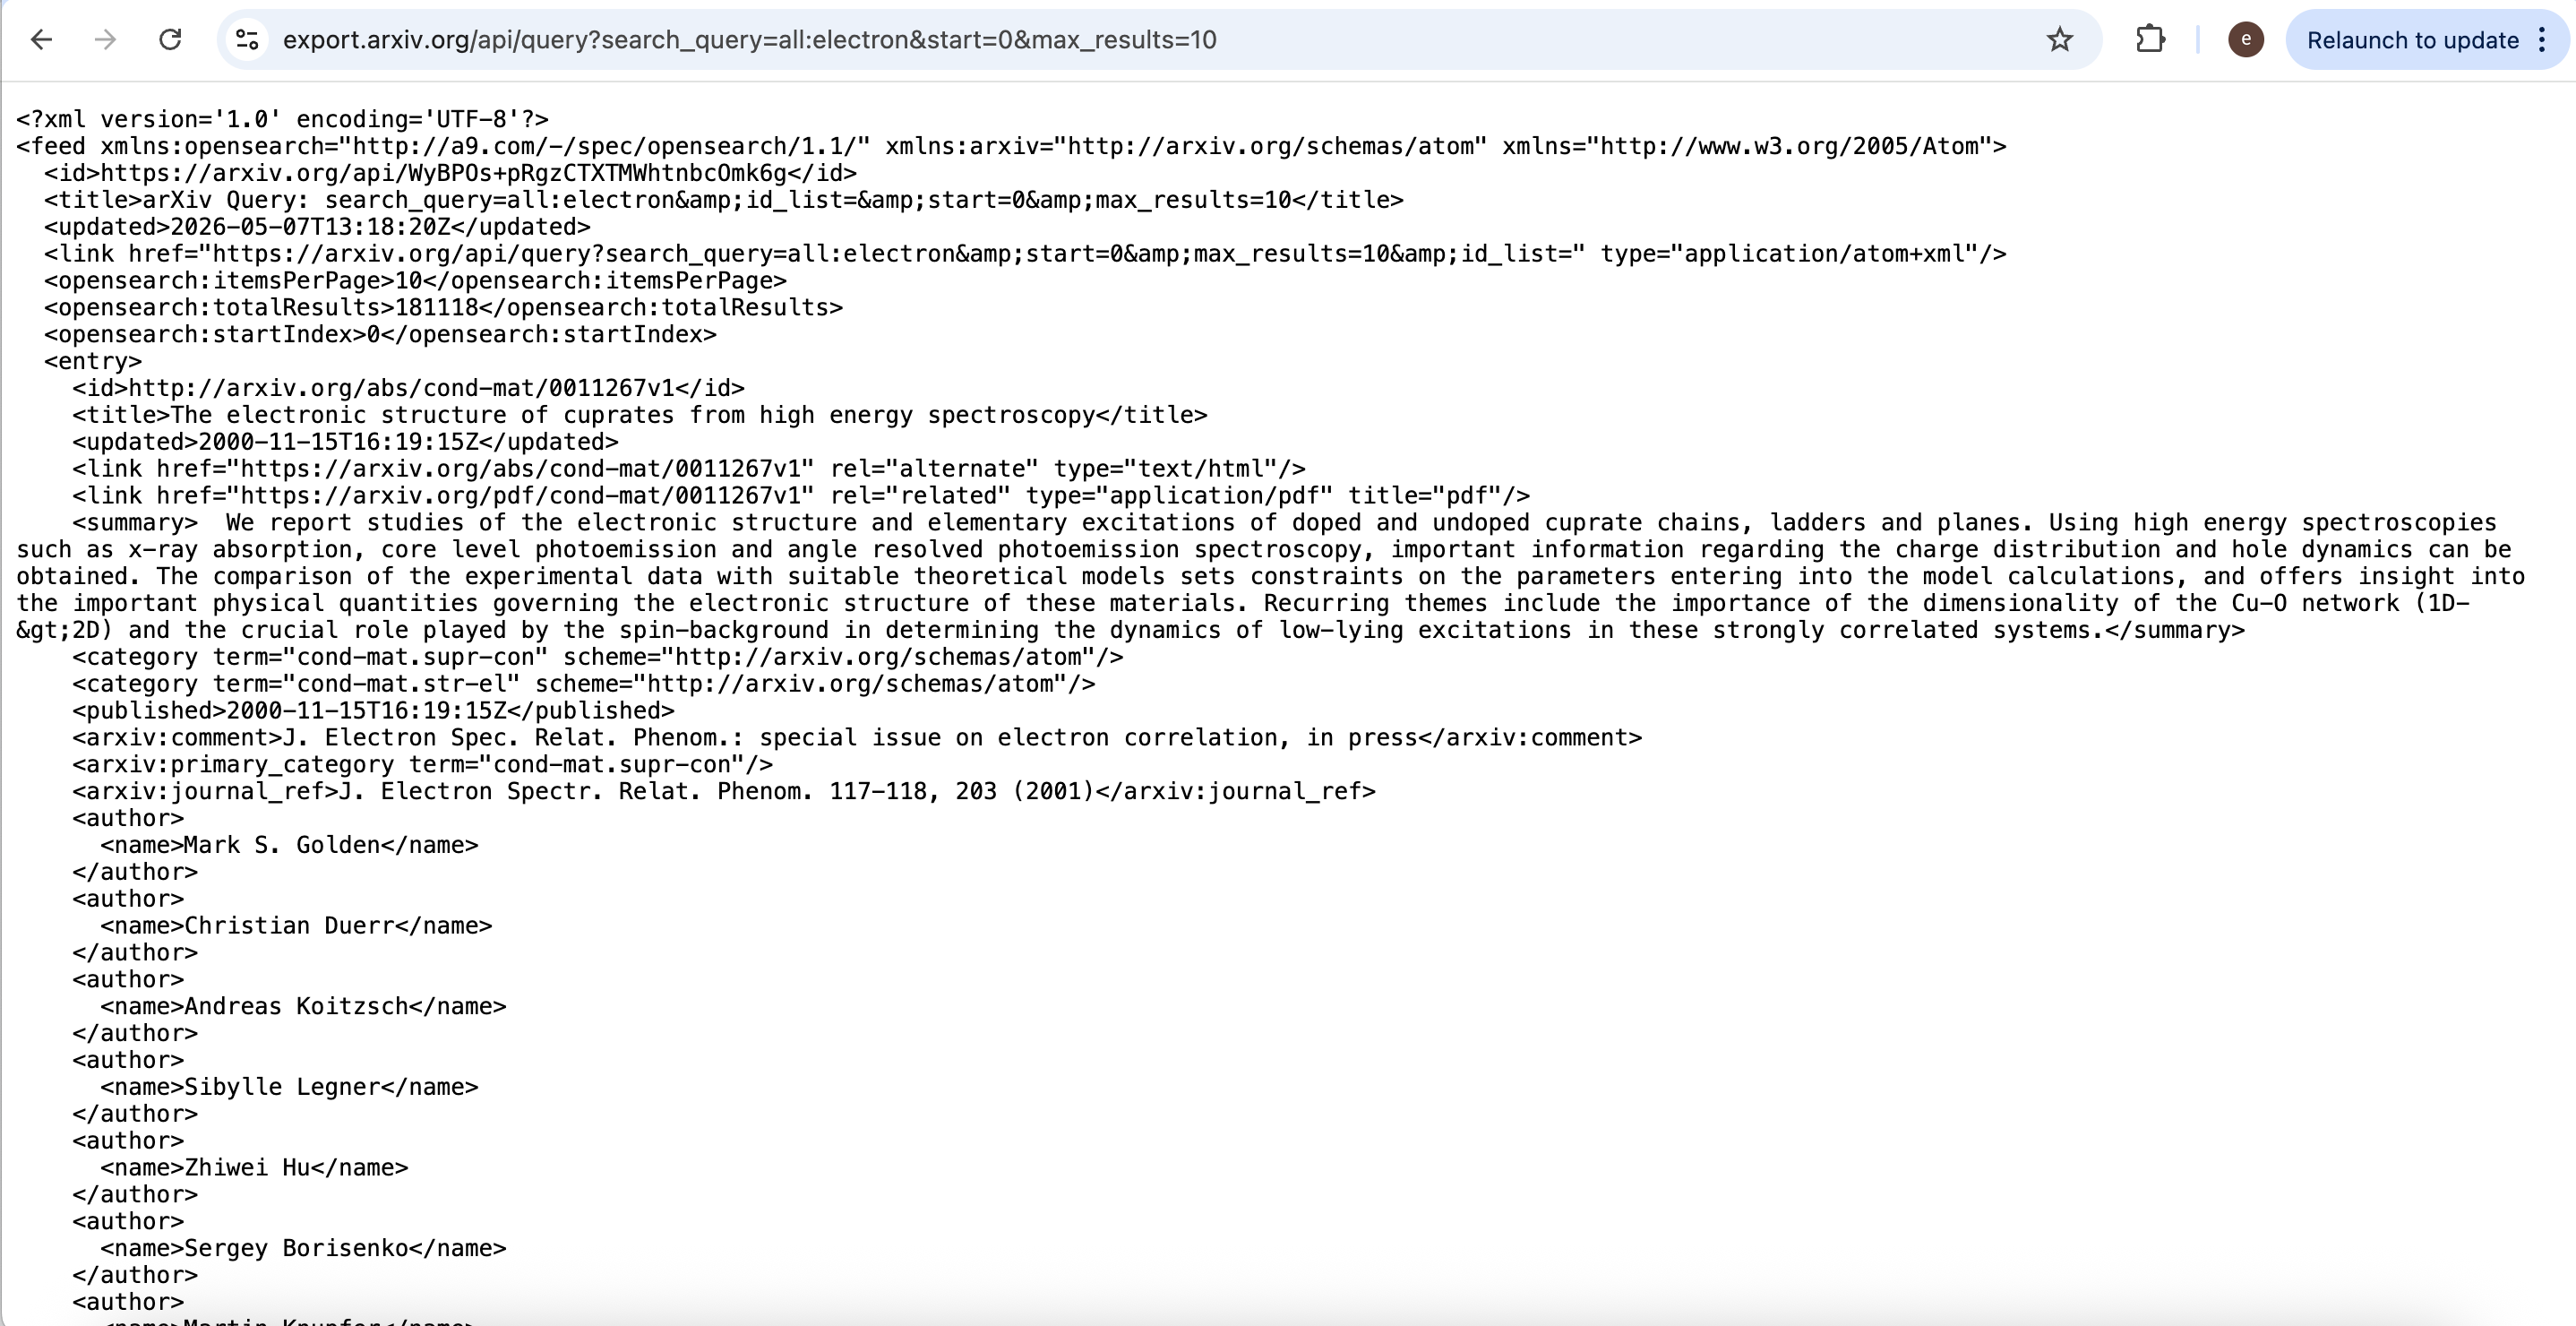
arXiv permite tanto la búsqueda como la recuperación: puedes buscar metadatos y obtener archivos PDF a través de interfaces HTTP estables y documentadas. La API pública de metadatos se describe en el centro de ayuda de arXiv; en la sección “Conceptos básicos de la API / Inicio rápido” se explica que los clientes envían solicitudes HTTP normales y reciben fuentes XML cuyas entradas incluyen enlaces a los archivos PDF.
No es necesario analizar el XML manualmente en cada flujo de trabajo, ya que tu agente o un pequeño script pueden hacerlo, pero es útil saber que la respuesta está estructurada y no es una simple página HTML destinada a los usuarios.
Ejemplo de consulta (metadatos de hasta diez resultados cuyos metadatos coincidan con electron en los campos predeterminados como “all”):
http://export.arxiv.org/api/query?search_query=all:electron&start=0&max_results=10
El feed devuelto muestra títulos, resúmenes y enlaces relacionados; se puede acceder a los archivos PDF desde los enlaces de las entradas, tal y como se describe en la documentación oficial. Se deben respetar los términos y condiciones de uso publicadas por arXiv.
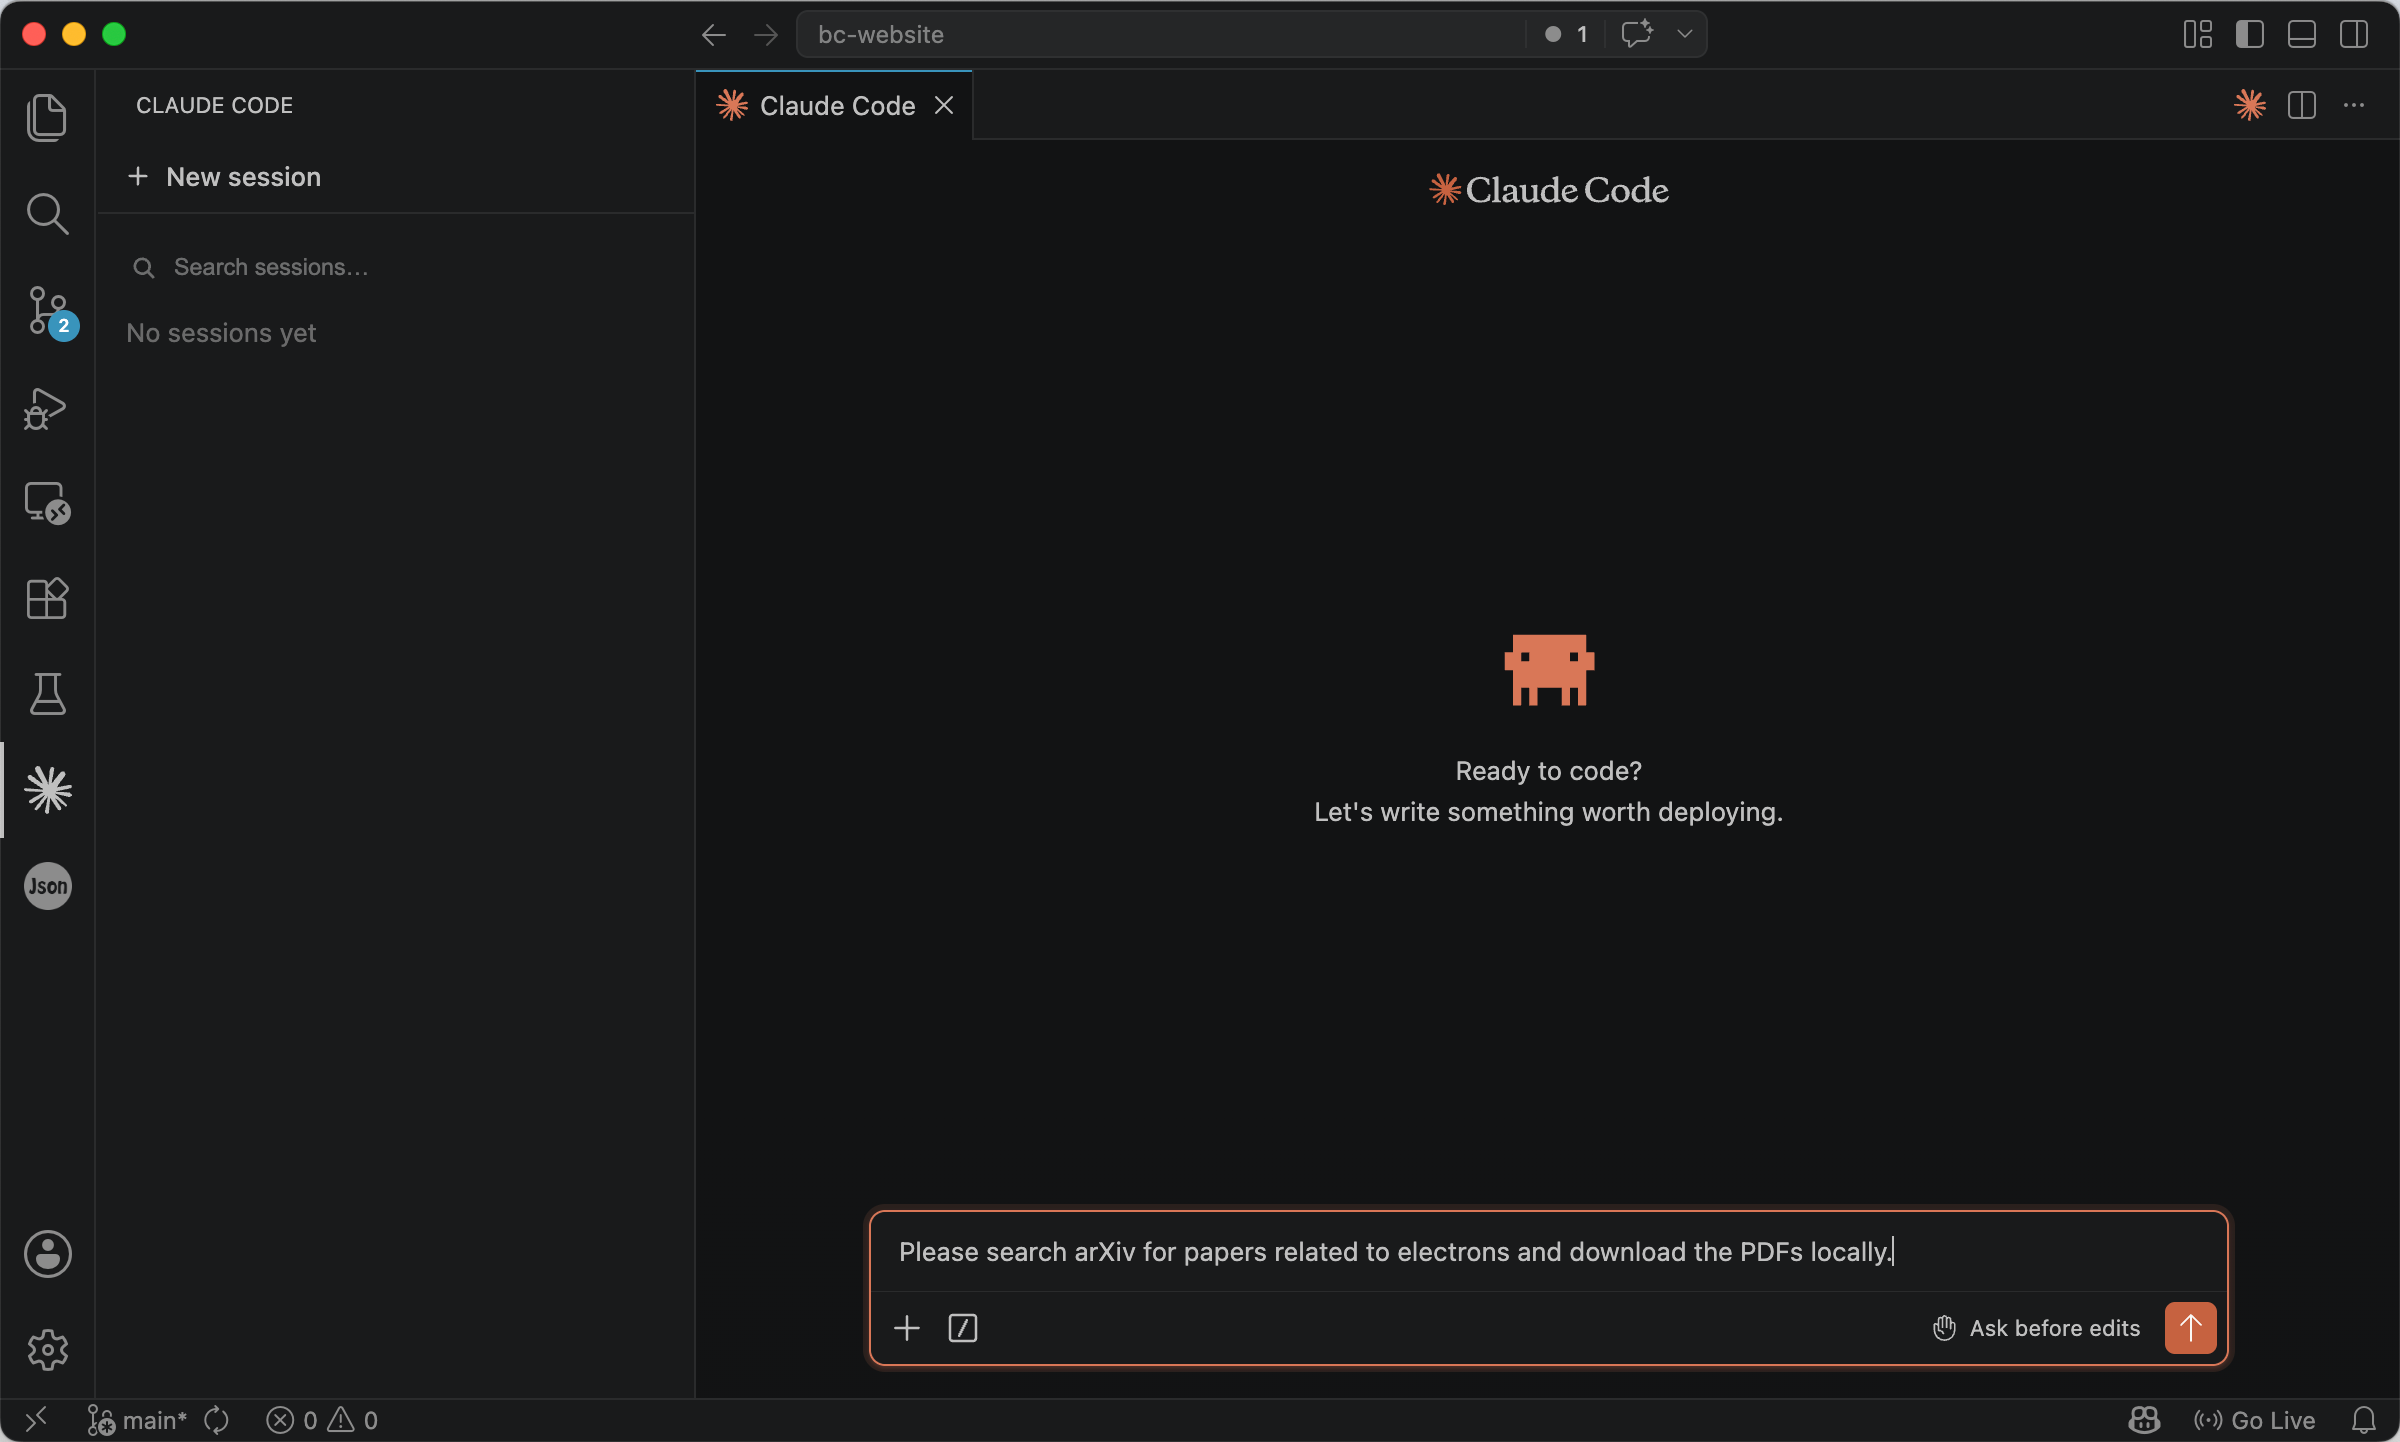
En un agente, puedes mantener la interacción a un nivel general:
Por favor, busca en arXiv artículos relacionados con los electrones y descarga los archivos PDF localmente.
El agente debe implementar la solicitud XML, seleccionar entradas y descargar solo lo que el usuario o la política permitan.
Semantic Scholar
Semantic Scholar, del Allen Institute for AI, combina la clasificación semántica con metadatos detallados (autores, revistas, citas, trabajos relacionados). Sus API admiten tanto la búsqueda bibliográfica como, cuando las licencias y los enlaces de los editores lo permiten, la recuperación de archivos PDF o URL de destino, siempre sujetas a las normas de acceso de cada artículo.
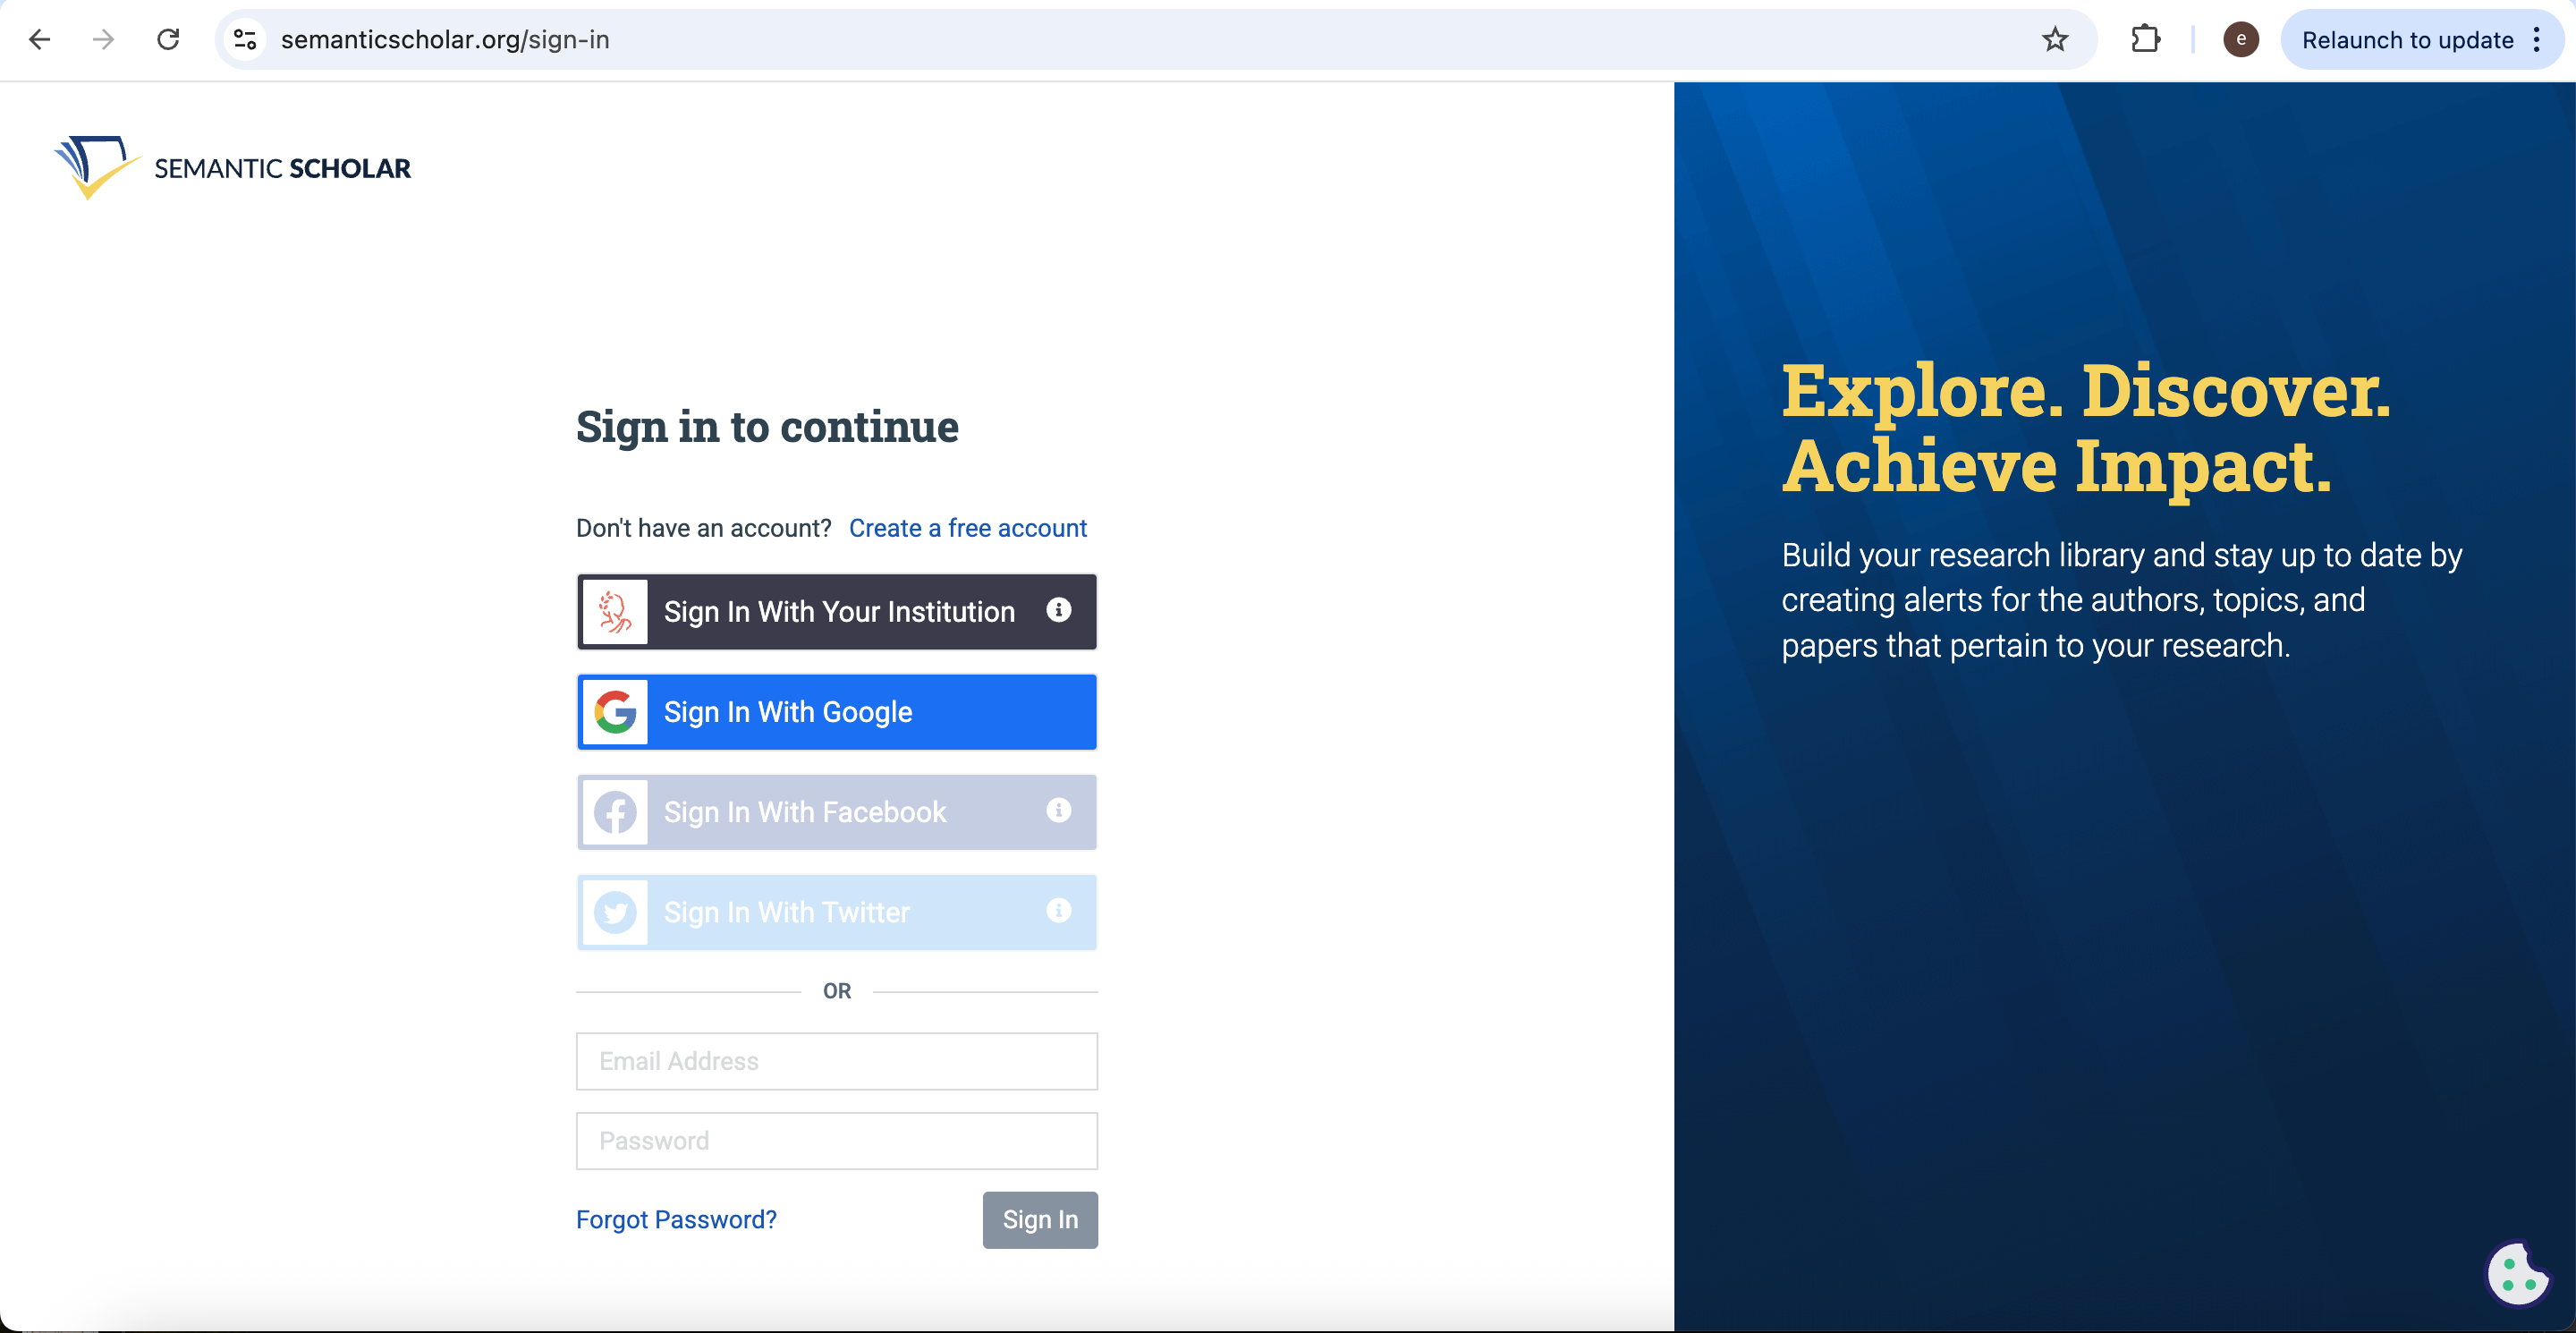
Inicia sesión en https://www.semanticscholar.org/sign-in.
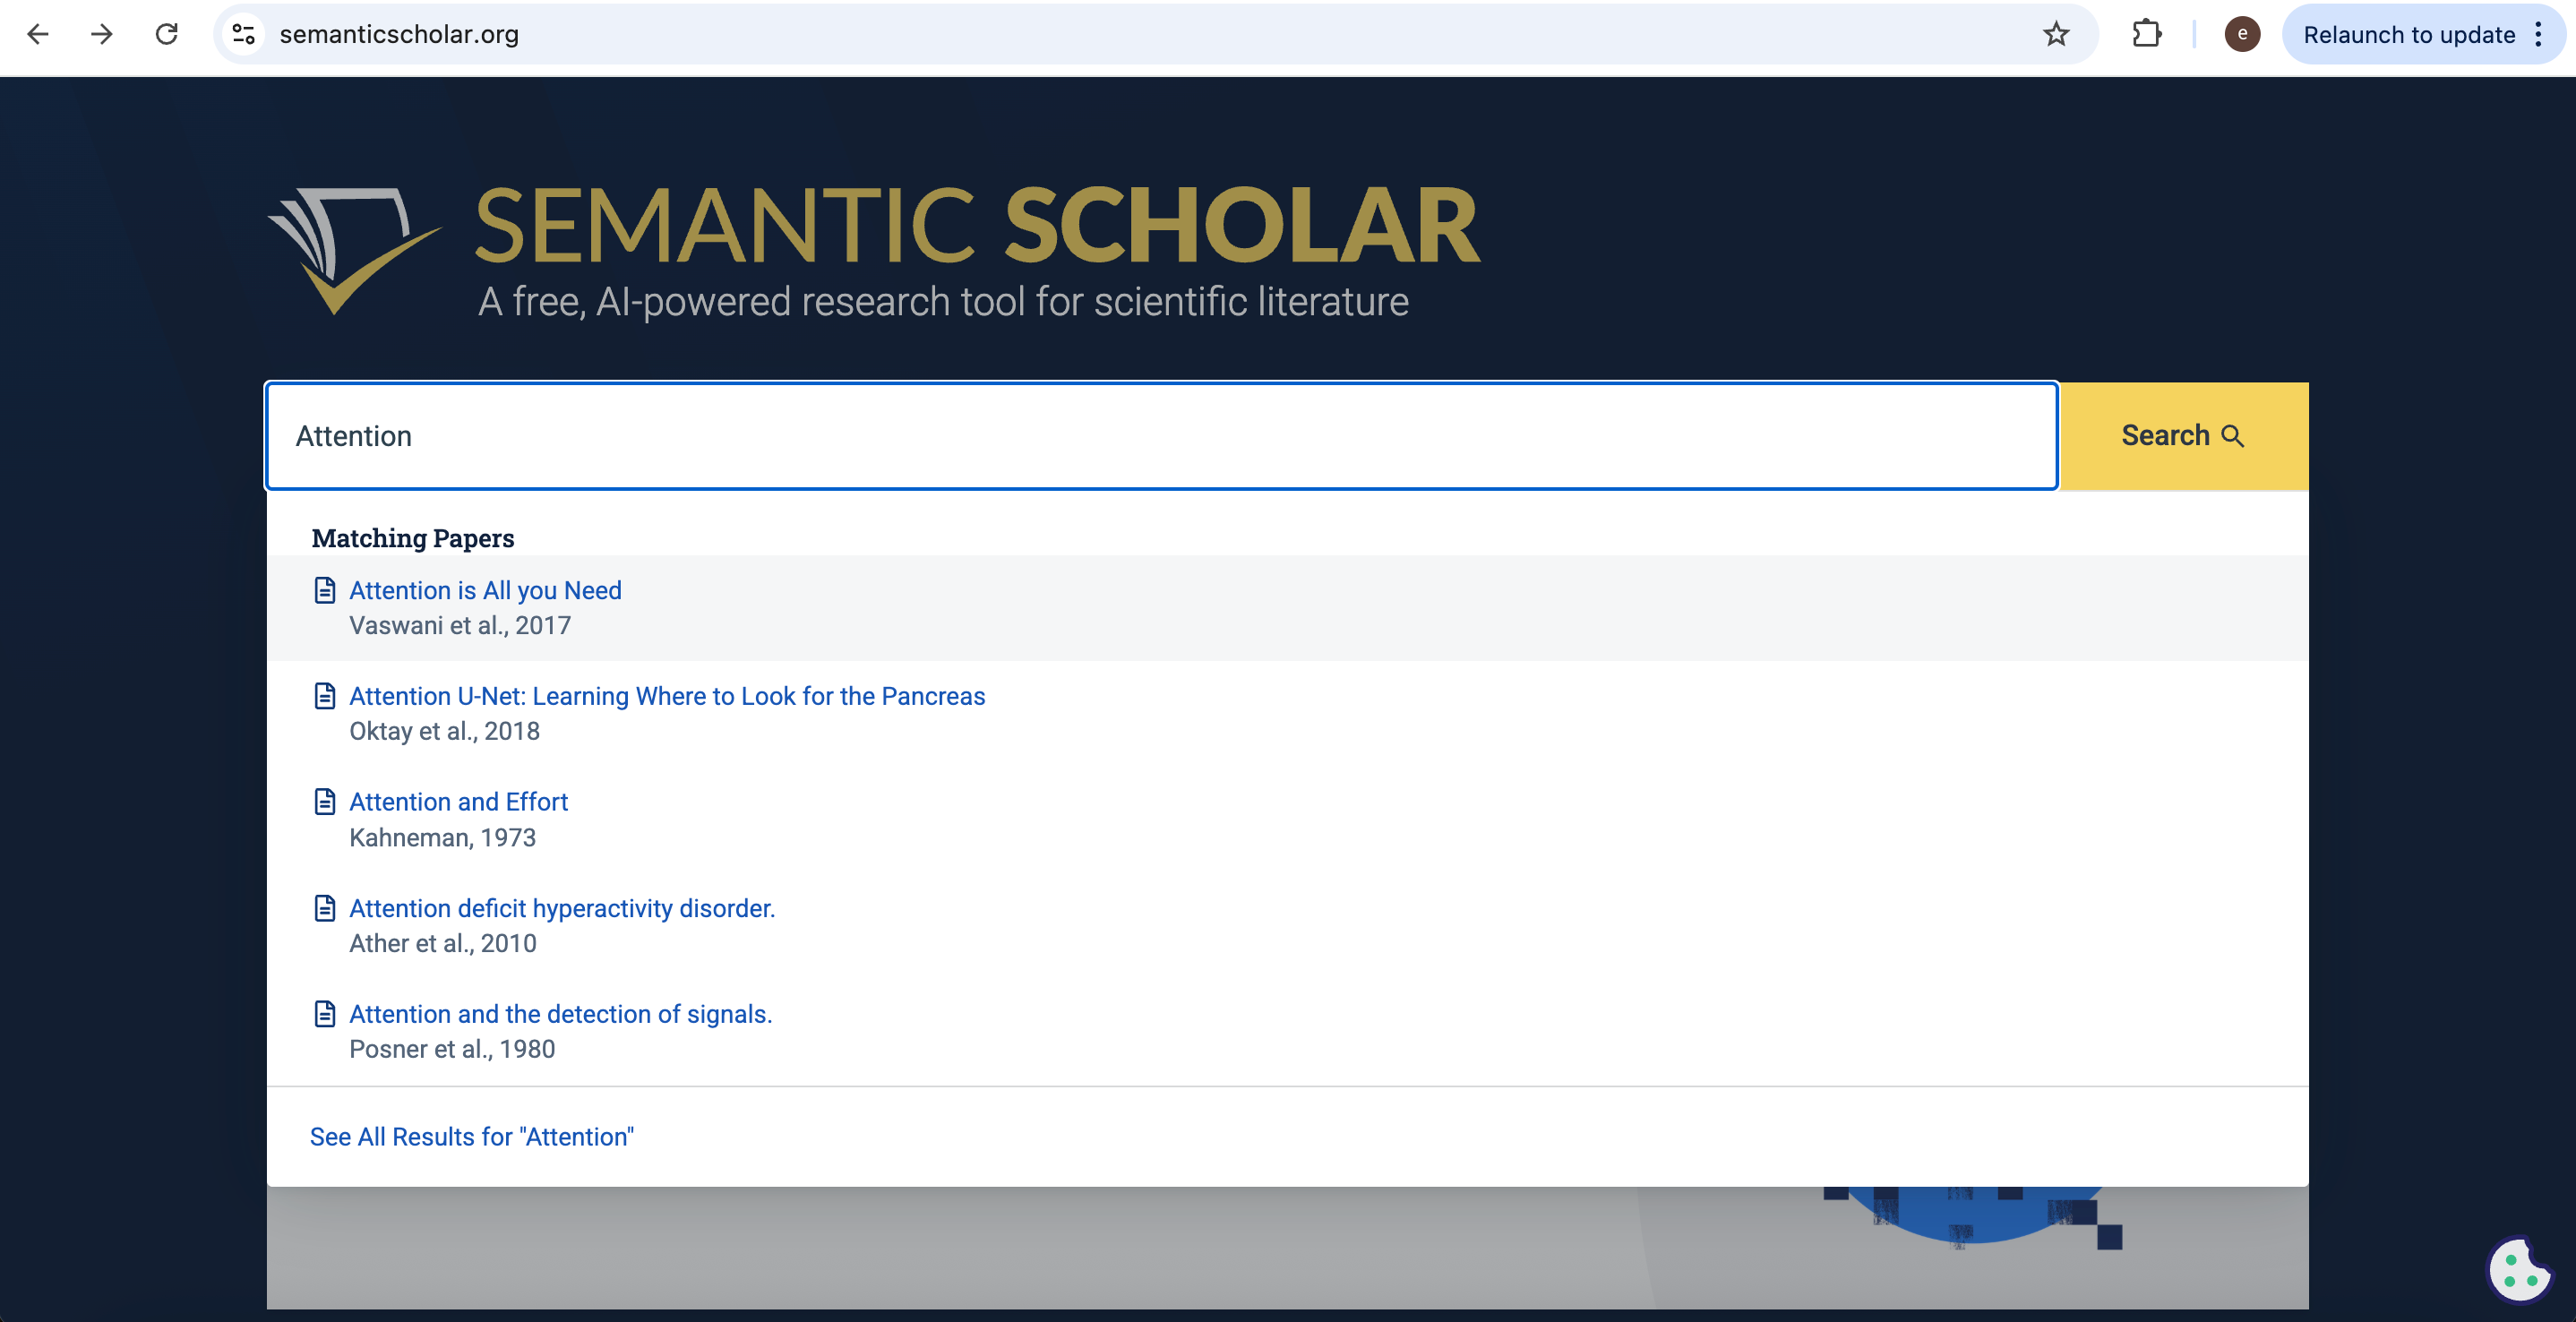
Utiliza la búsqueda del sitio web para comprobar títulos, autores o temas.
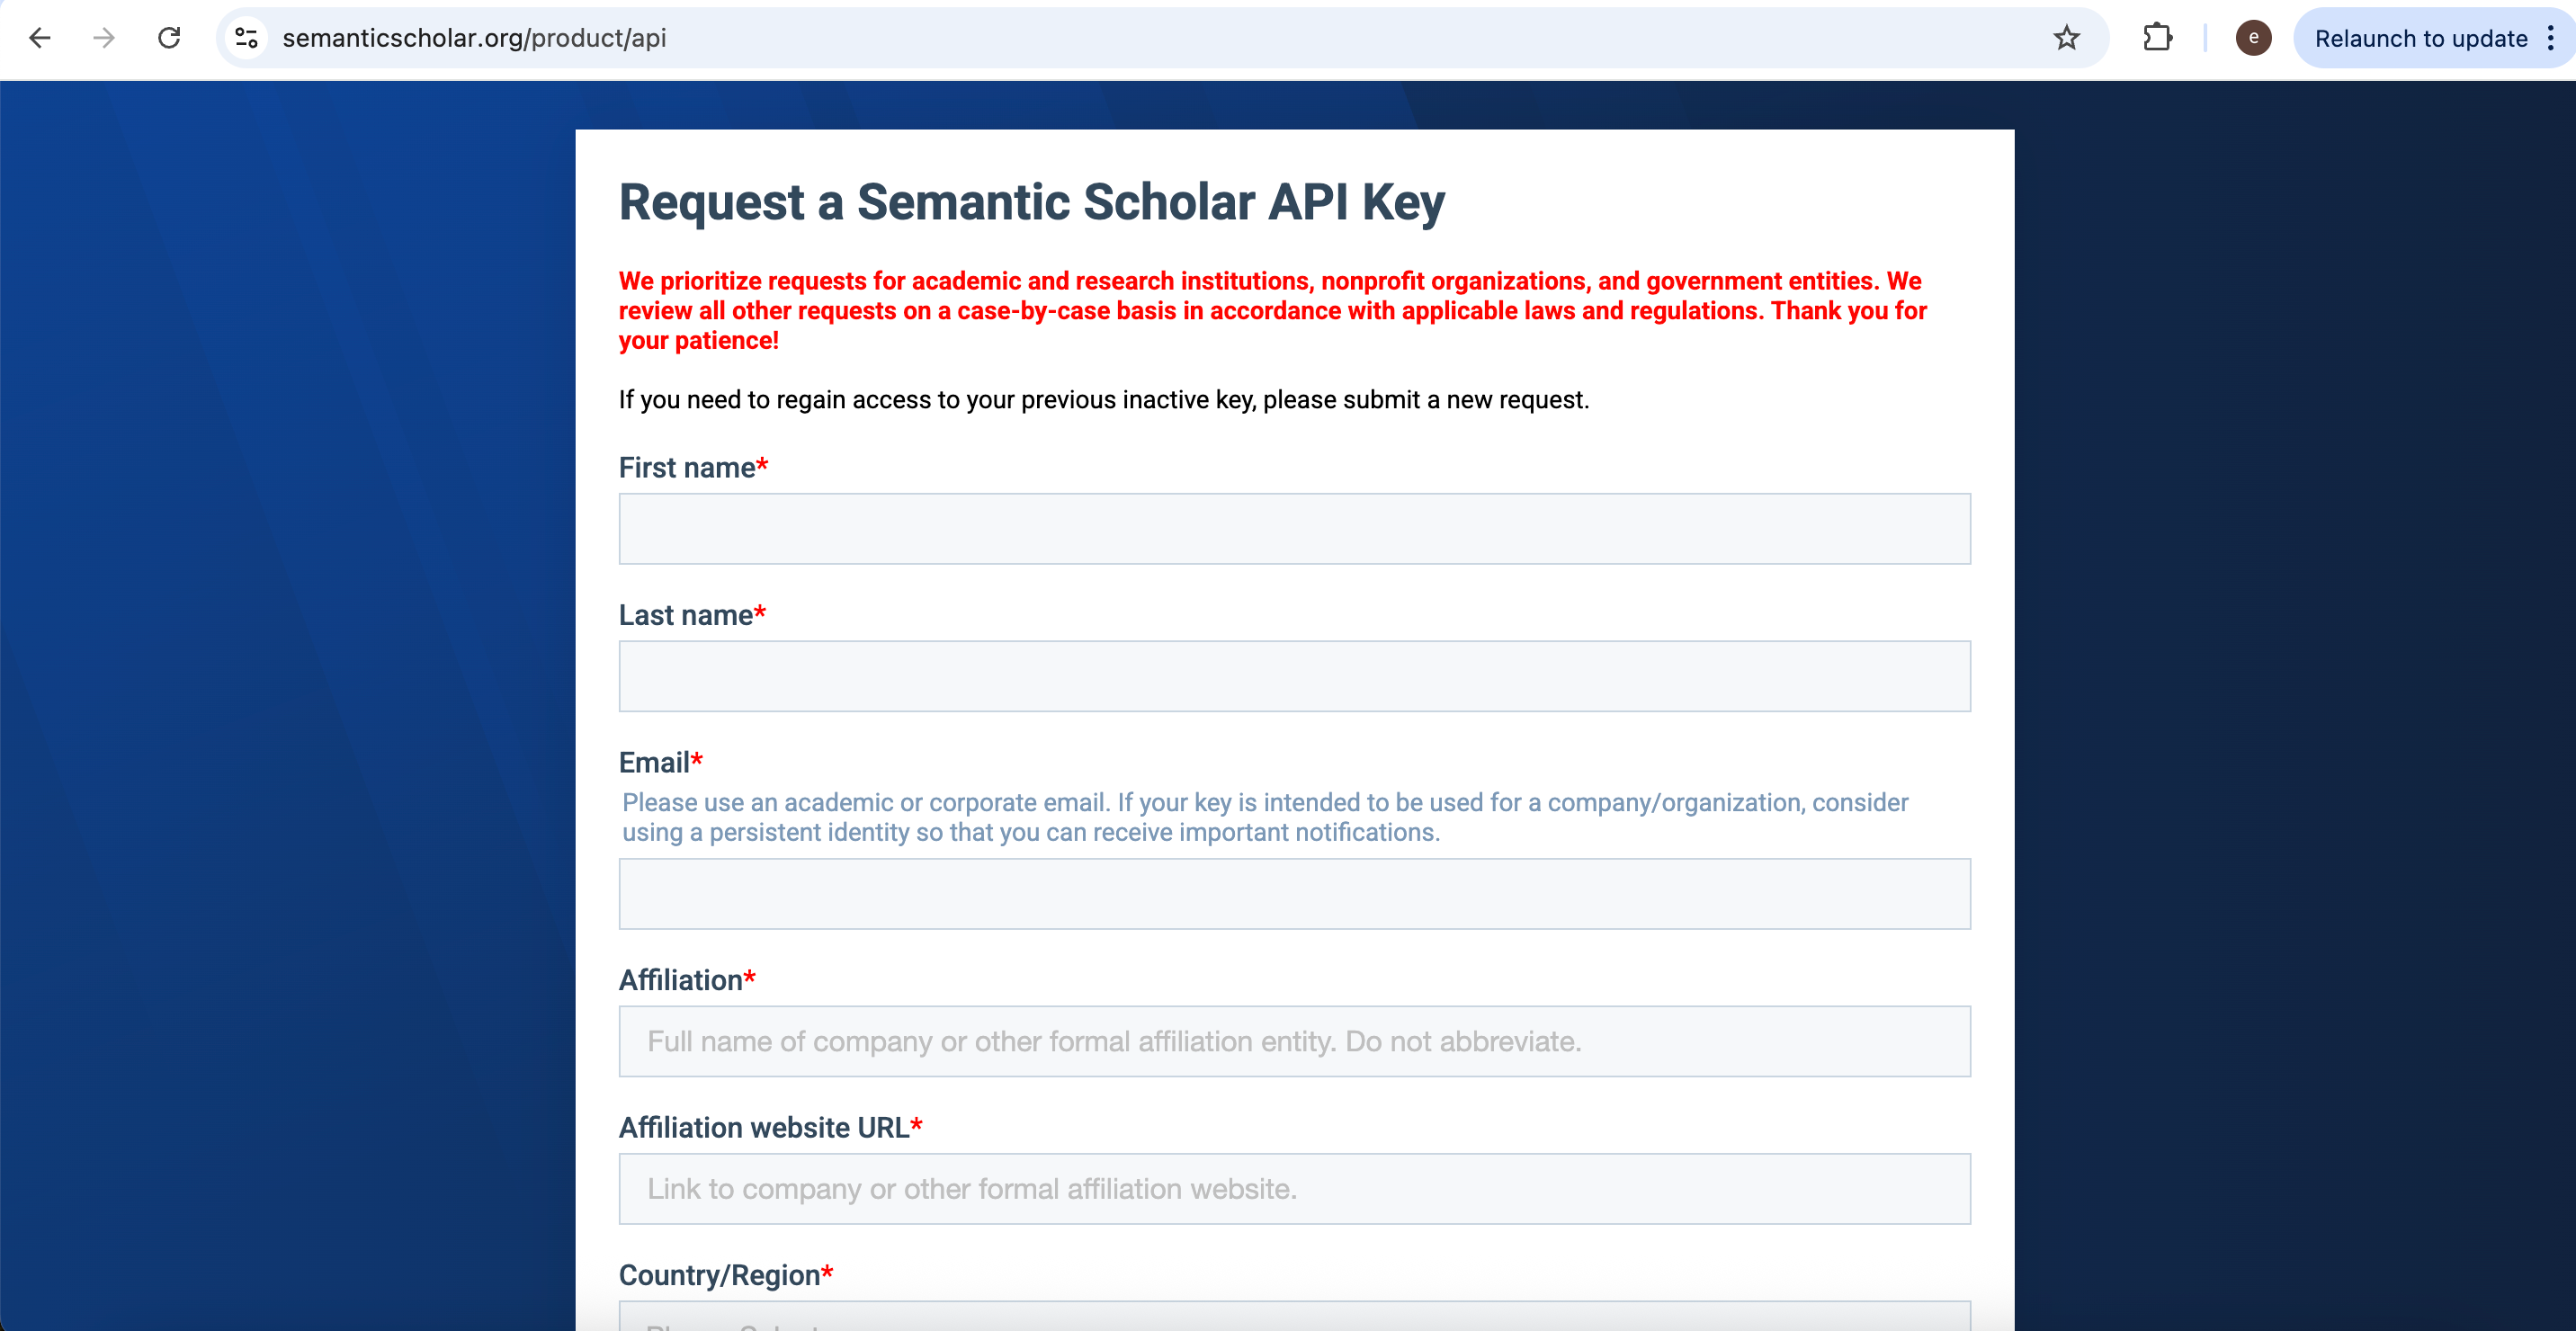
El acceso programático requiere una clave de API independiente. Solicítala en https://www.semanticscholar.org/product/api.
Una vez aprobada la solicitud, recibirás una clave por correo electrónico.
Guárdala bajo un nombre similar a S2_API_KEY y configura el agente según los ejemplos oficiales del cliente:
Utiliza la clave S2_API_KEY almacenada en tus variables de entorno para buscar artículos sobre «xxx» mediante la API de Semantic Scholar y descarga los archivos PDF localmente cuando esté permitido. Para el uso de la API, consulta la documentación en https://github.com/allenai/s2-folks/tree/main.
Contenido de páginas web
Algunos equipos encadenan la búsqueda web a servicios de extracción alojados que convierten las URL autorizadas, o pequeños trabajos configurados, en texto limpio o Markdown para procesamiento por modelos posterior.
Firecrawl y Crawl4AI se citan habitualmente en los tutoriales sobre agentes: tú proporcionas las URL y las restricciones; la herramienta devuelve el contenido normalizado. Sin embargo, no sustituyen a la lectura de la política de robots, el aviso de derechos de autor y las condiciones de uso de cada sitio web. Este artículo no expone tácticas de rastreo web; limita tu uso a lo que documenta cada proveedor y a lo que permite el sitio web de destino.
Otras herramientas: Connected Papers
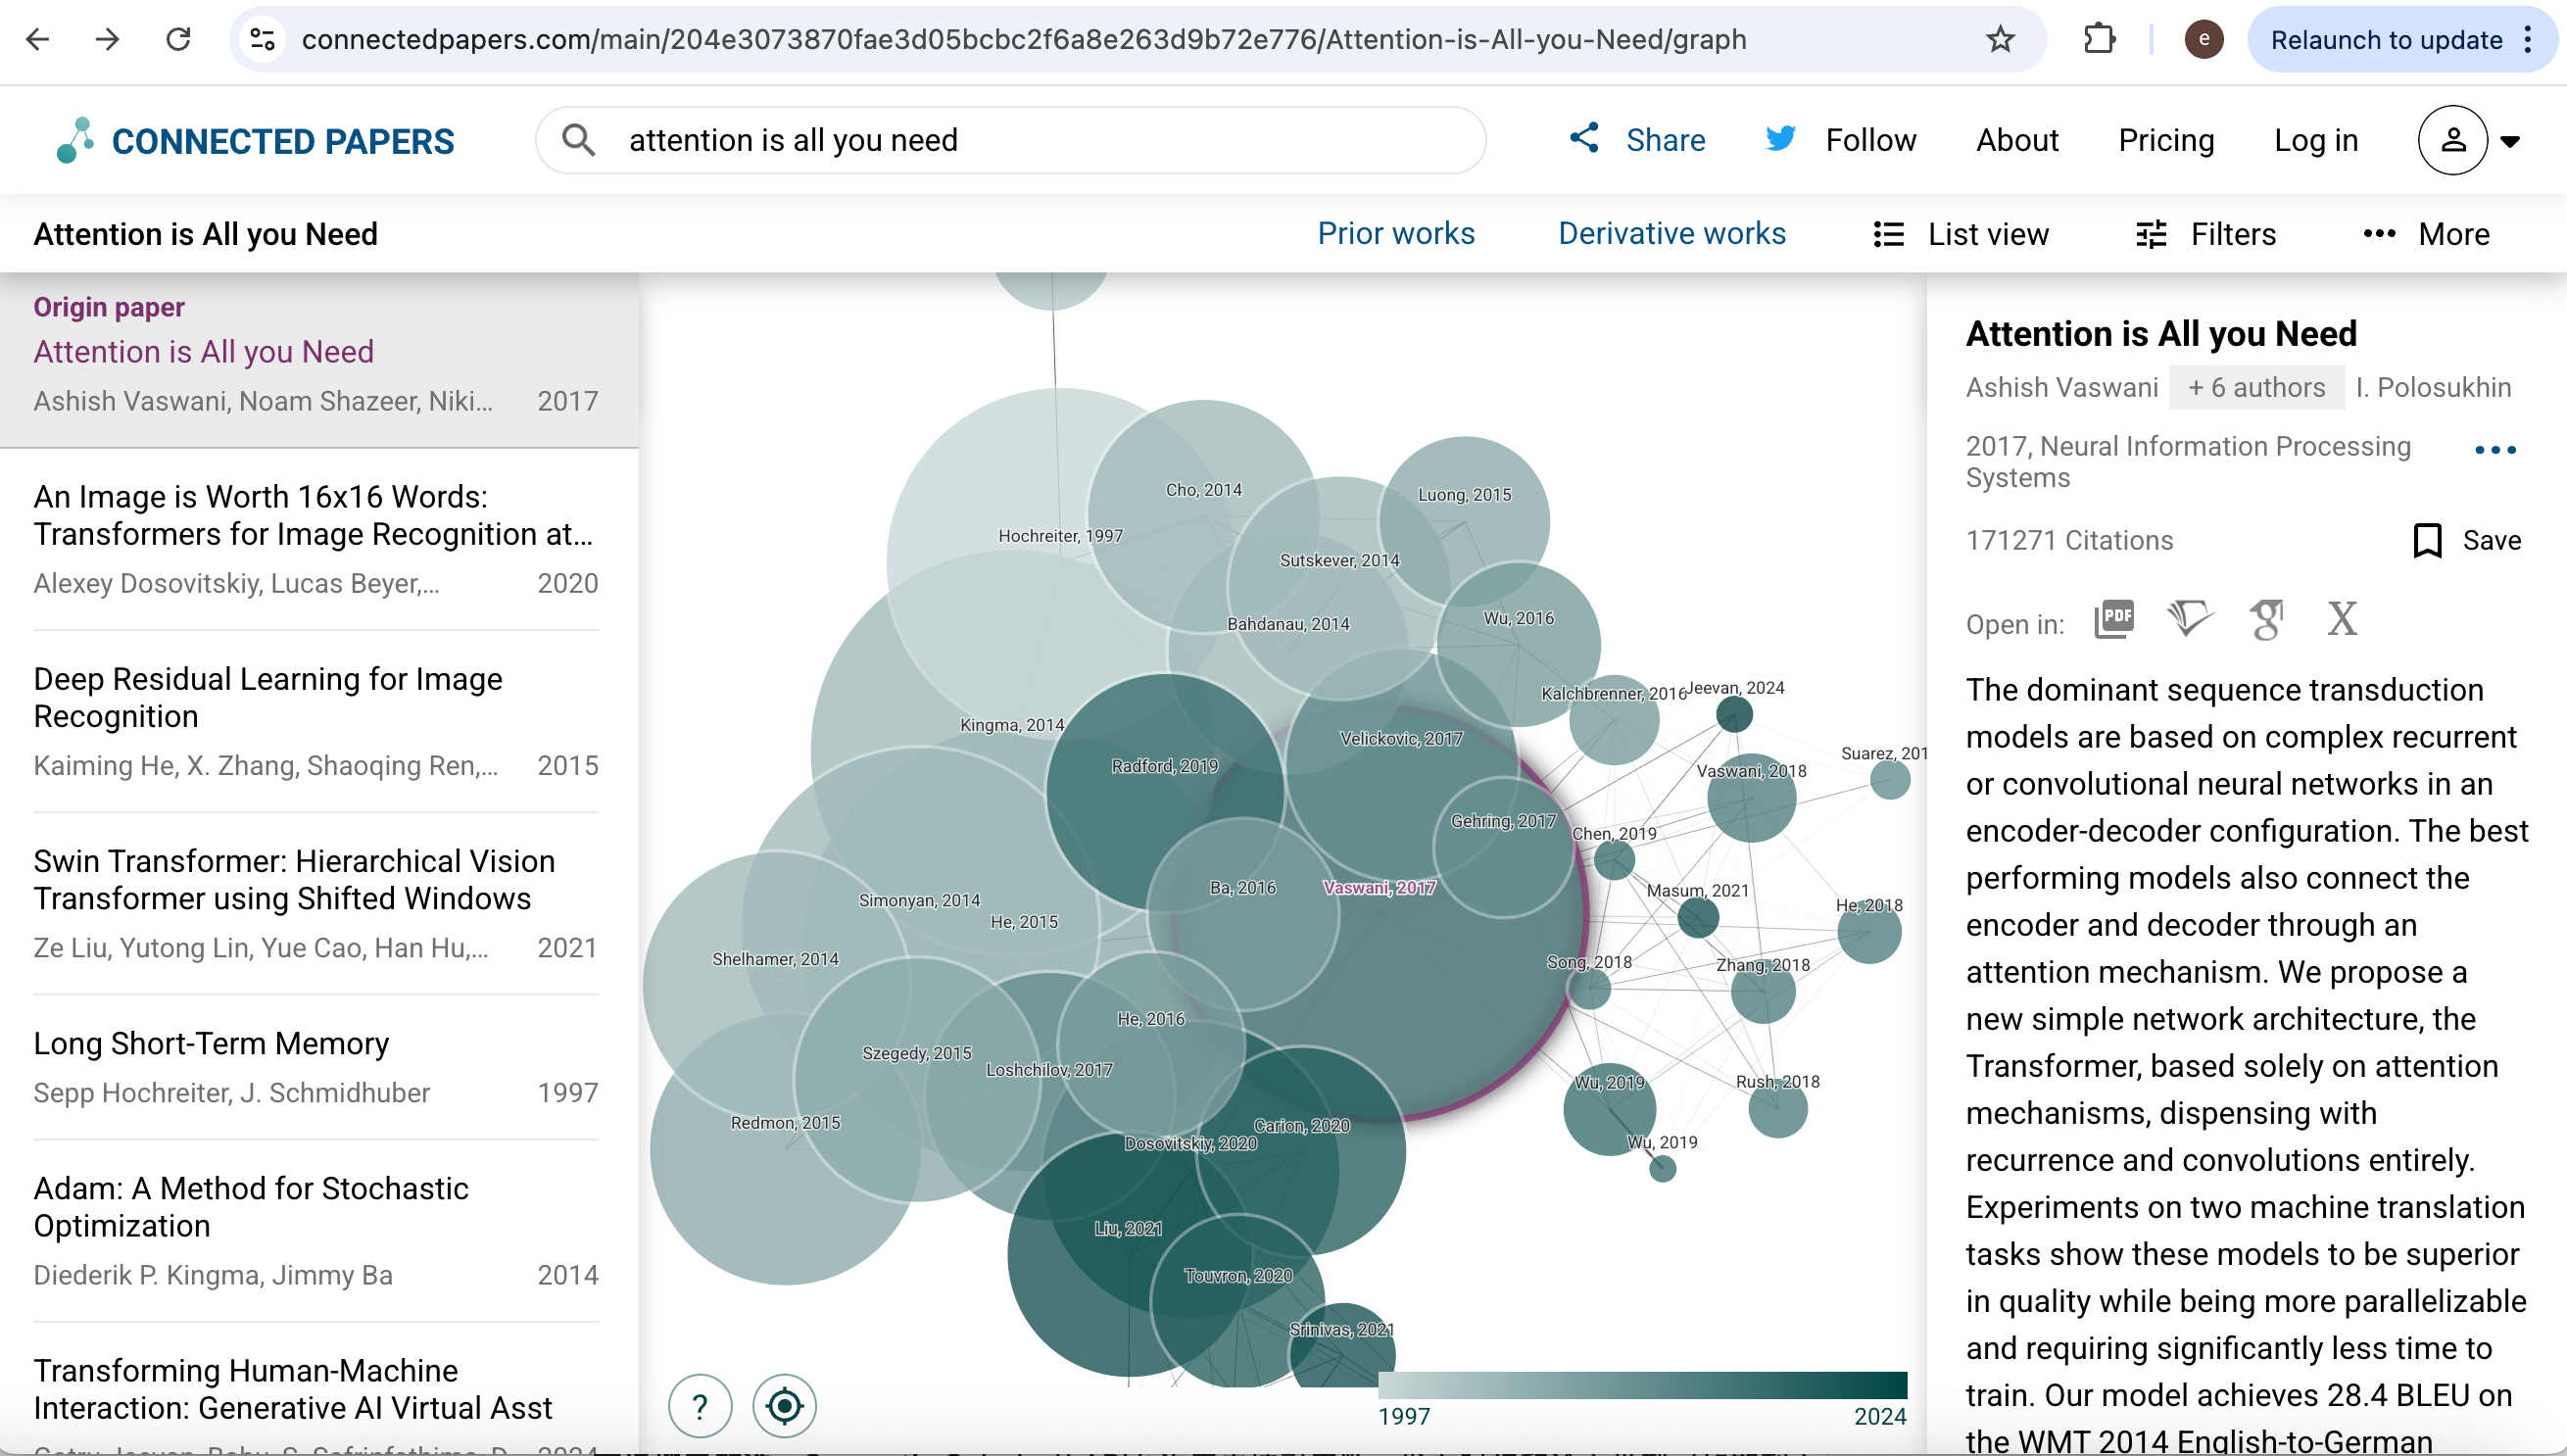
Connected Papers es un mapa interactivo: a partir de un artículo de referencia, traza un gráfico de trabajos relacionados para que puedas detectar grupos y nodos de gran influencia antes de fijar una lista de lecturas. No es principalmente una capa de recuperación de datos basada en API, pero resulta excelente para ver cómo se relacionan los artículos.
Abre https://www.connectedpapers.com/ y realiza una búsqueda por título.
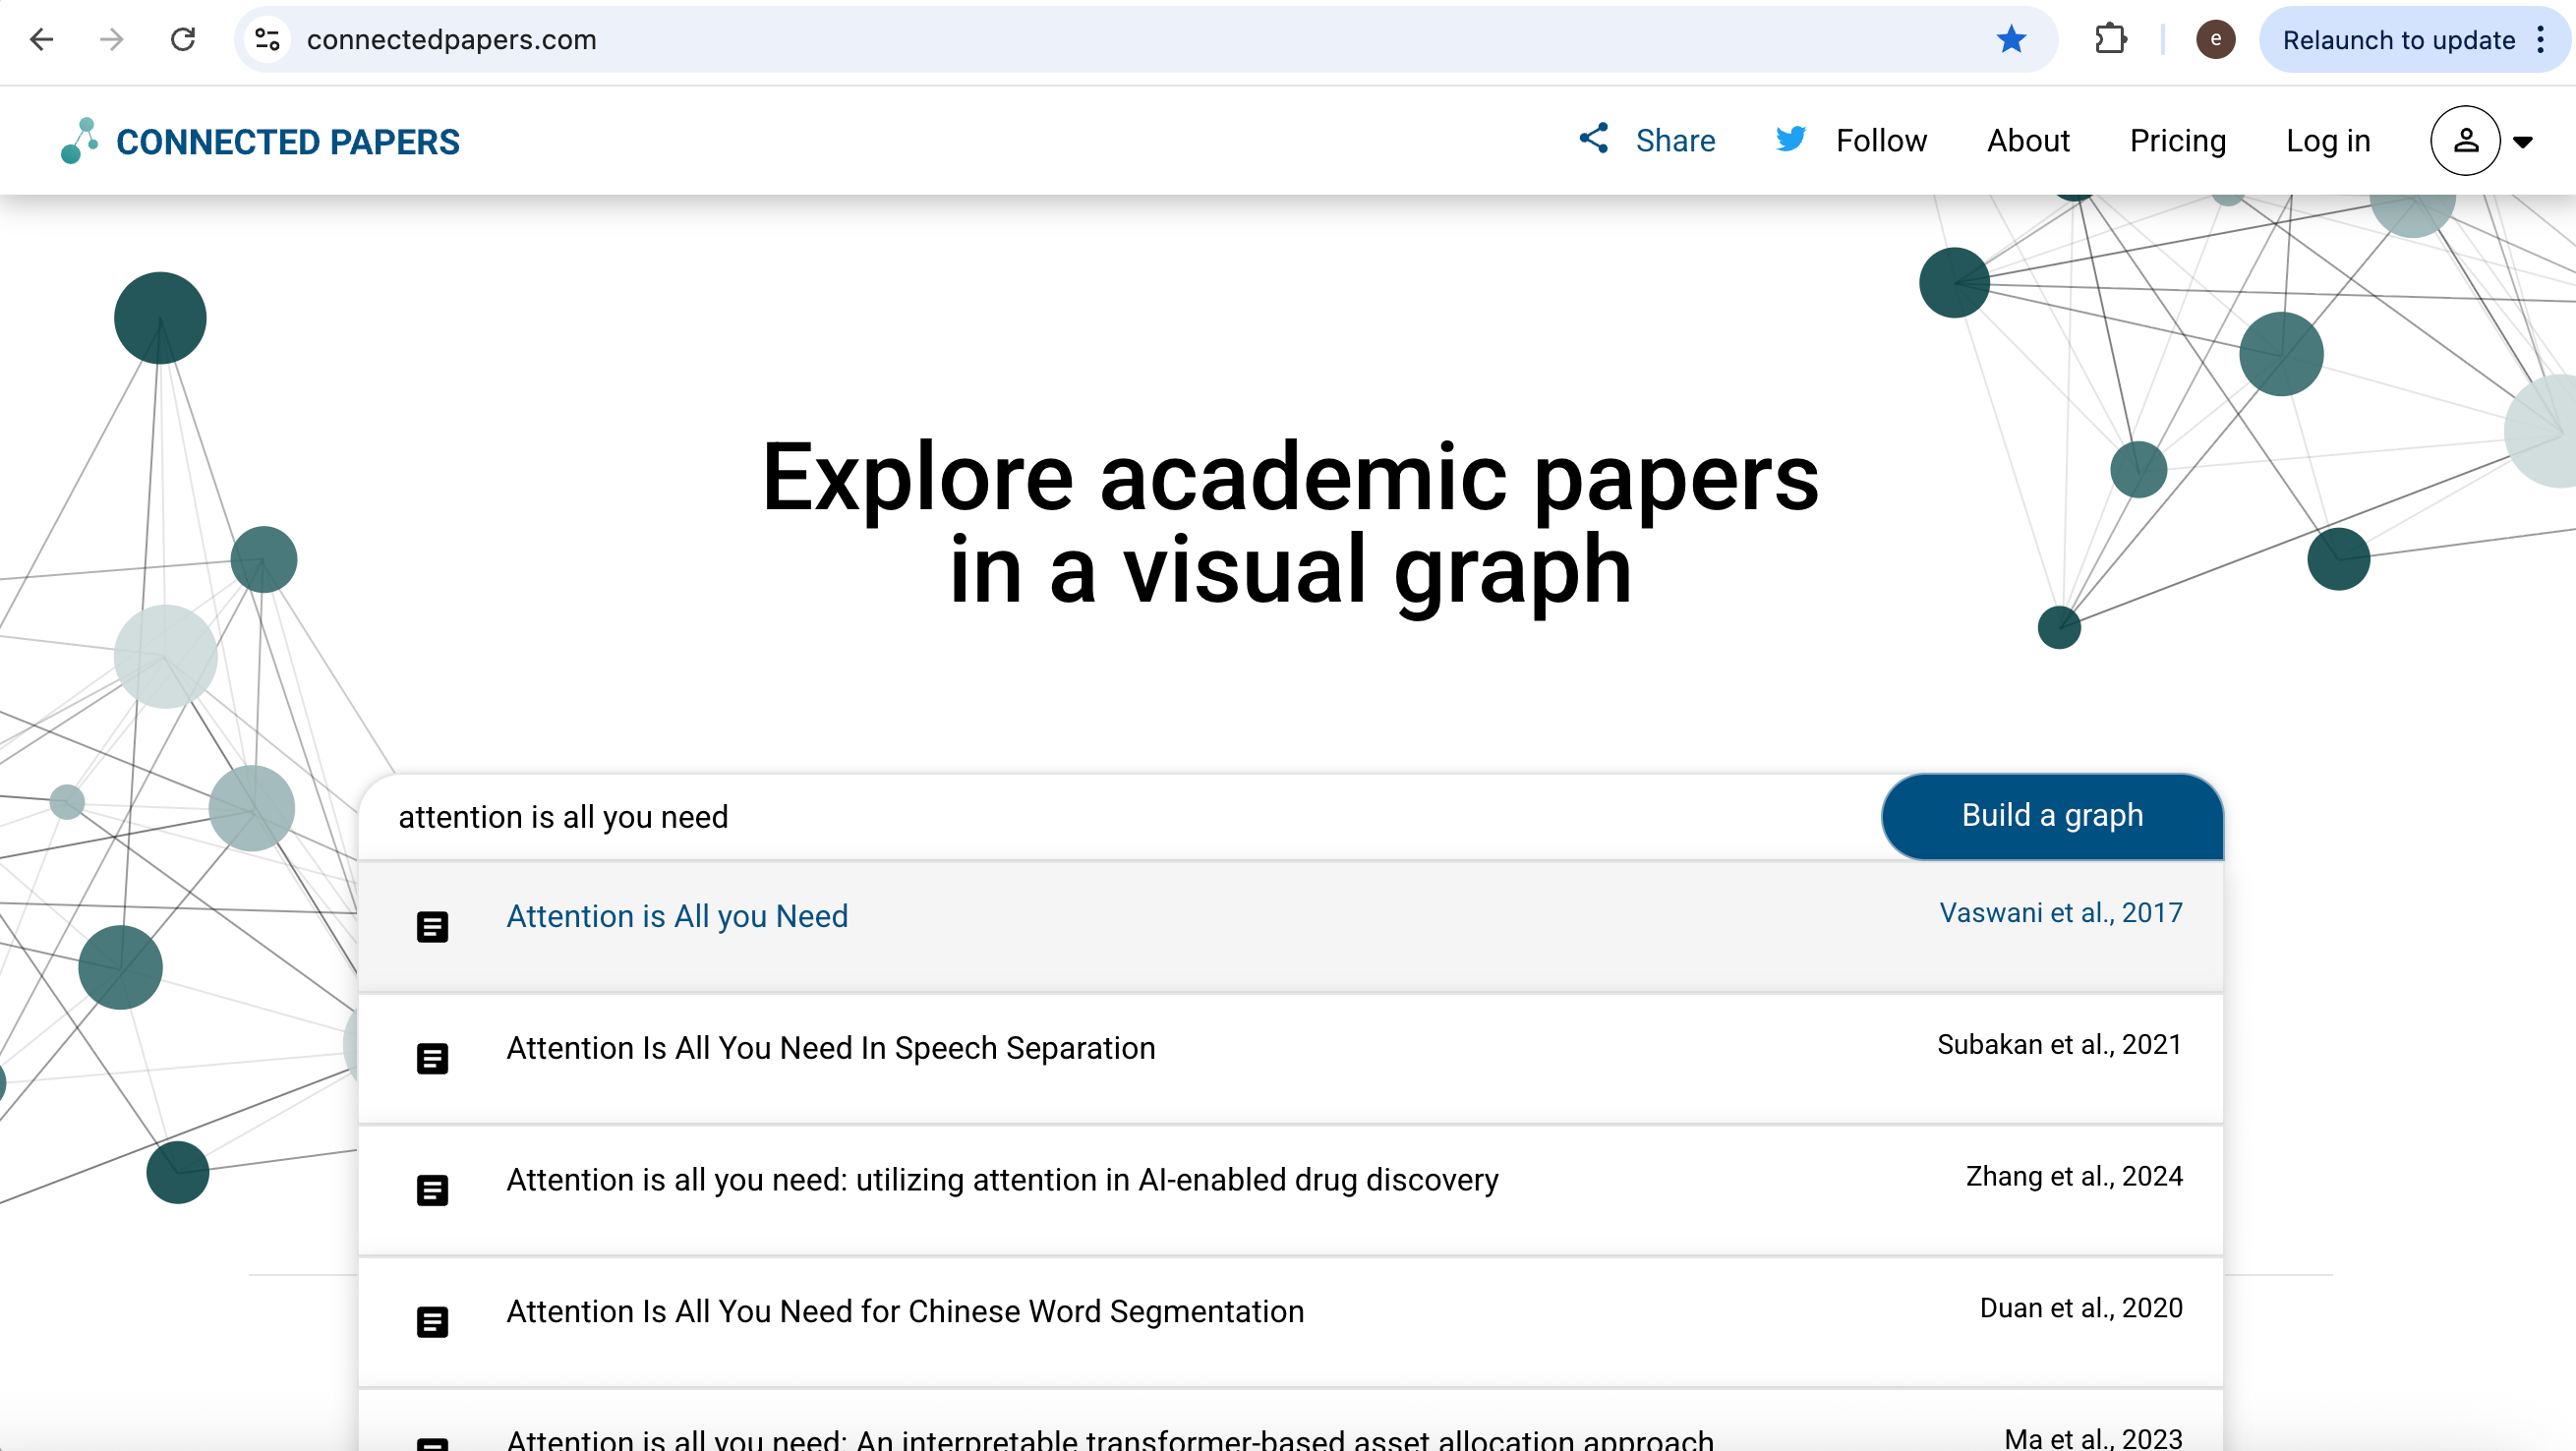
La herramienta crea un gráfico visual de los artículos vecinos en el espacio de las citas y la similitud.
Conclusión
La búsqueda en la web a través de Serper.dev y SerpApi te ofrece un descubrimiento estructurado de contenidos web; Semantic Scholar hace lo mismo con los metadatos académicos. La recuperación de contenido web, la API XML de arXiv para preimpresiones abiertas, junto con Semantic Scholar, siempre que las claves y las licencias lo permitan, proporciona el texto completo y los enlaces. Connected Papers permite realizar un mapeo exploratorio de la bibliografía, mientras que herramientas como Firecrawl y Crawl4AI pueden proporcionar texto normalizado de las páginas solo cuando las políticas y los contratos lo permiten.